语音小管家
LongCat-Next不仅简化了多模态建模的复杂性,还在图像理解与生成、纯文本处理、语音ASR(自动语音识别)与TTS(文本转语音)等方面展现出了卓越的性能。
论文链接:https://arxiv.org/abs/2603.27538v1 项目主页:https://longcat.chat/longcat-next/ GitHub Repo:https://github.com/meituan-longcat/LongCat-Next Hugging Face:https://huggingface.co/meituan-longcat/LongCat-Next 开源协议:MIT License
LongCat-Next是一个原生多模态模型,它采用单一的自回归目标函数处理文本、视觉和音频,且在语言范式之外,归纳偏置极小。作为一个规模达到 A3B 级的工业级基础模型,它在视觉、创造和表达方面表现出色,并在众多多模态基准测试中取得了优异成绩。尤其值得一提的是,它利用语义完备的离散表示,突破了离散视觉建模在理解任务上长期存在的性能瓶颈,并为视觉理解和生成提供了一个统一的解决方案。这一成功表明,离散标记可以普遍地表示多模态信号,并能被深度内化到单一的离散嵌入空间中。LongCat-Next模型的主要贡献在于:
原生全模态设计:提出了一套全新的离散原生自回归范式,将所有模态(文本、视觉、音频)全部转化为统一的离散Token,共享同一个自回归预测目标(NTP)。 高效的模态转换器:引入了dNaViT(离散原生视觉Transformer)和音频tokenizer,实现了图像和语音的高效压缩与重建。 统一语义空间:通过t-SNE可视化分析,证明了LongCat-Next模型将视觉和音频视为以语言为中心的自回归范式的内在扩展,形成了真正的统一语义空间。 优异的模型性能:在图像理解与生成、纯文本处理、语音ASR与TTS等方面,LongCat-Next模型均展现出了卓越的性能。
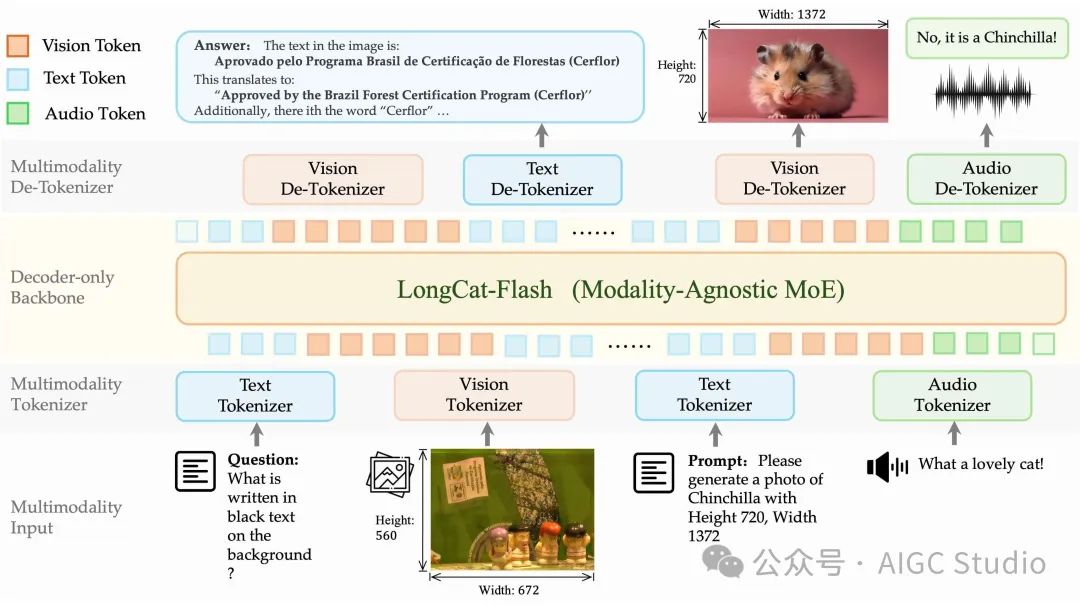
LongCat-Next模型采用了一套全新的离散原生自回归范式,将所有模态数据转化为统一的离散Token序列。这一范式通过分词器-反分词器对,利用LLM(大型语言模型)的现有训练基础设施进行训练,简化了多模态建模的复杂性。
模态转换器设计
视觉转换器(dNaViT):dNaViT是一个在任意分辨率下视觉理解和生成的统一tokenizer。它通过Semantic-and-Aligned Encoder (SAE) + Residual Vector Quantization (RVQ)实现任意分辨率支持,并在保持语义完整的前提下实现高效压缩。 音频tokenizer:音频tokenizer将连续语音转化为离散token,同时保留语义和声学信息。它通过Whisper编码器进行音频特征提取,然后以下采样和RVQ量化的方式生成离散token。
原生多模态训练
LongCat-Next模型的原生多模态训练包括预对齐(Pre-align)、预训练(Pre-train)、中间训练(Mid-training)和监督微调(SFT)等阶段。在训练过程中,美团还提出了V型流水线并行(VHalf-based Pipeline Parallelism)技术,以解决异构模块间跨阶段通信开销大的问题。
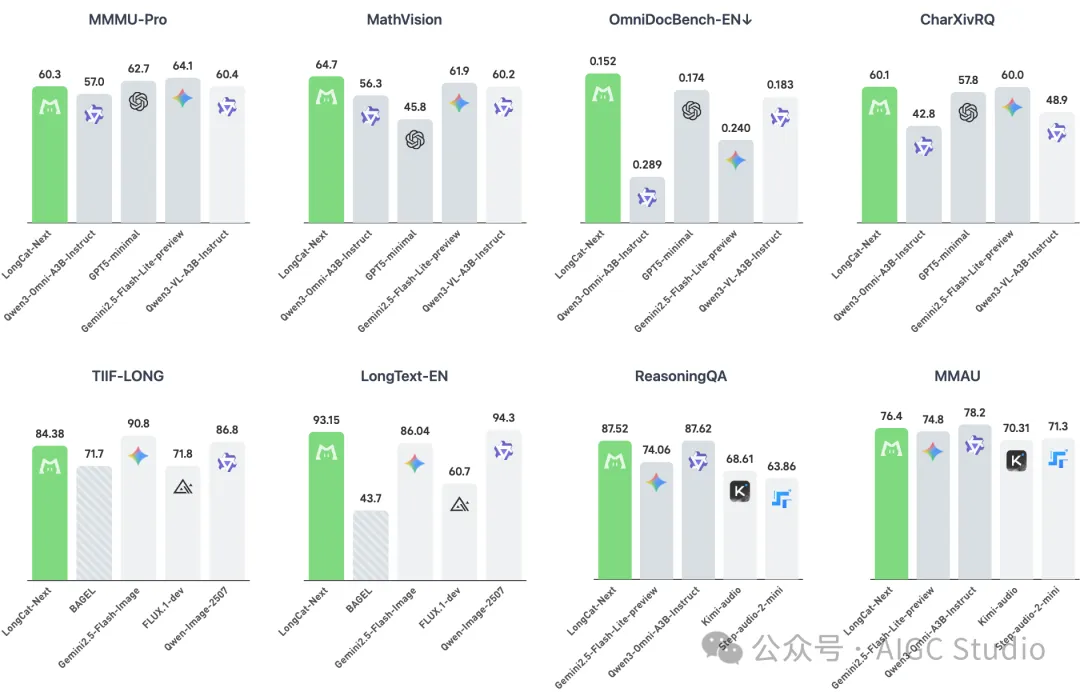
图像理解与生成:LongCat-Next模型在OCR(光学字符识别)方面表现出色,细粒度内容识别准确。在视觉理解任务中,模型能够精准定位并找到核心点,但对于空间变化和复杂逻辑推理的效果有待提升。在图像生成任务中,模型能够生成大字报和简单图像,但对于复杂指令生成的图像质量有待提高。 纯文本处理:LongCat-Next模型在纯文本处理任务中也展现出了优异的性能,与同等级模型相比毫不逊色。 语音ASR与TTS:在语音ASR和TTS任务中,LongCat-Next模型同样表现出了卓越的性能,准确率和自然度均达到了较高水平。
视觉理解
视觉生成