
 语音小管家
作者:罗立昂,编辑:冯小雨,审核:关键
在追求沉浸式体验的道路上,空间音频扮演着至关重要的角色。想象一下,在虚拟现实中,不仅能看到逼真的场景,还能听到与场景几何、物体材质、布局息息相关的真实声场,这才是真正的“身临其境”。然而,新视角声学合成 这一任务仍然充满挑战,因为它需要精确地模拟声音在复杂物理环境(如反射、衍射、材质吸收)中的传播。
当前多数方法依赖于单视角或全景图输入,虽然在空间保真度上有所改进,却难以捕捉场景的全局几何结构以及物体布局、材质属性等关键语义信息。例如,几何模型无法区分地毯和瓷砖的吸声差异,而全景输入在物体级语义理解上存在局限。这导致合成的音频往往缺乏物理一致性,难以“以假乱真”。
该工作由哈尔滨工程大学智能信号处理组(GISP@HEU)联合南京大学、悉尼科技大学及萨里大学等单位合作完成,提出了Phys-NVAS 框架,这是首个将三维声学环境建模与物理感知的视觉语言先验相结合的NVAS框架。这项名为《PHYSICS-AWARE NOVEL-VIEW ACOUSTIC SYNTHESIS WITH VISION-LANGUAGE PRIORS AND 3D ACOUSTIC ENVIRONMENT MODELING》的工作,近期被音频顶会ICASSP2026录用,为解决上述难题提供了新思路。
作者:范聪毅 关键*林尤添 徐东篱 叶桐 朱乔茜 冯鹏铭 王文武
论文网址:https://arxiv.org/html/2601.19712v1
Demo Page:https://physnvas.github.io/
实现逼真的NVAS需要对复杂的声传播物理过程进行精确建模,包括直达声、早期反射和混响,这些过程都受到场景几何、物体布局和材质的影响。现有方法,如 AV-NeRF, SOAF, AV-GS 等,虽然各有侧重,但普遍忽略了对声学至关重要的语义信息,例如“木制咖啡桌”和“平板电视”因其材质不同,会显著改变声音的反射与吸收特性。
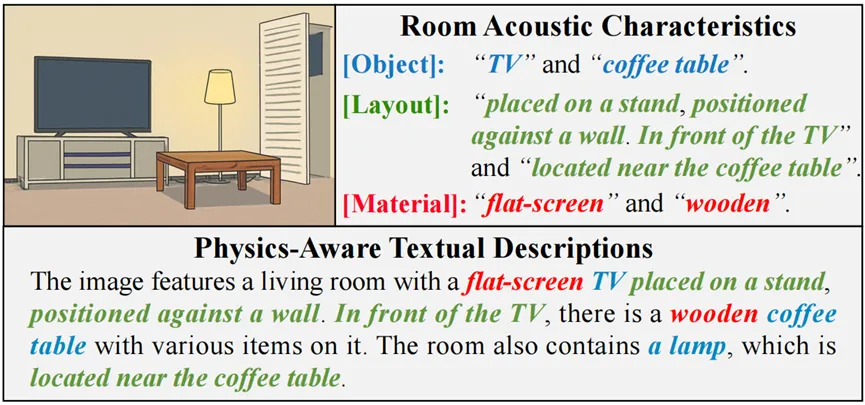
图1:场景语义影响声学的图示
如图1所示,这些语义线索的缺失会导致生成的音频在物理上不一致。Phys-NVAS 的目标正是填补这一空白。
为了解决这一问题,团队提出了Phys-NVAS框架,其核心思想是联合建模几何与语义,打造一个真正理解物理的声学模型。整个框架流程如图2所示。
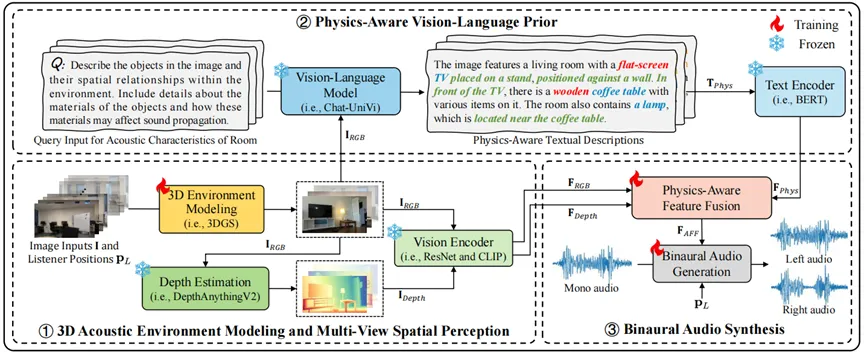
图2:Phys-NVAS 整体框架图
框架包含三个创新模块:
1. 三维声学环境建模与多视角感知
团队利用3D高斯泼溅技术,从少量输入图像重建场景的全局三维几何,生成多视角RGB图像。同时,利用深度估计模型(如DepthAnythingV2)生成对应的多视角深度图。前者捕获全局形状,后者提供精确的空间距离信息,共同为声音的直达传播和早期反射建模提供了坚实的几何基础。
2. 物理感知的视觉语言先验
这是团队的核心创新。团队引入视觉语言模型(如Chat-UniVi),让它“看懂”场景并生成物理感知的文本描述,例如:“一个木制咖啡桌放在平板电视前面”。这些文本中蕴含的“木质”、“平板屏幕”等材质和布局信息,被编码成语义特征。这相当于为模型注入了关于材料吸声性和反射性的“常识”。
3. 物理感知特征融合与双耳音频生成
团队设计了一个声学特征融合适配器,将上述几何特征与语义特征深度融合,形成一个统一的、物理感知的场景表征。最后,以此表征和单声道音频为条件,通过一个双耳音频生成器,合成出最终的空间音频。这使得生成的声音同时具备了精确的空间定位和符合物理规律的声学特性。
团队在Real-World Audio-Visual Scene (RWAVS) 数据集上进行了全面评测,与包括AV-NeRF在内的多种前沿方法进行对比。评价指标为衡量音频保真度的MAG(幅度距离)和ENV(包络结构差异),数值越低越好。
表1:在RWAVS数据集上的性能对比 (MAG↓ / ENV↓)
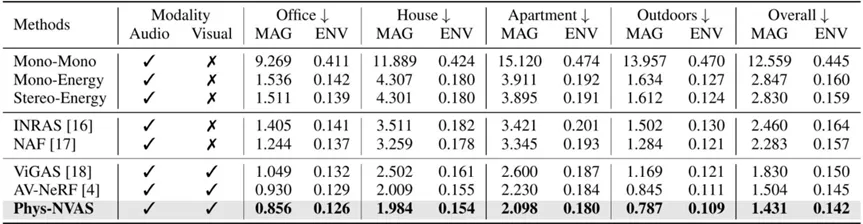
如表1所示,Phys-NVAS在全部四种场景和总体指标上均达到最佳性能,优于之前的SOTA方法AV-NeRF,证明了团队引入物理感知语义先验的有效性。
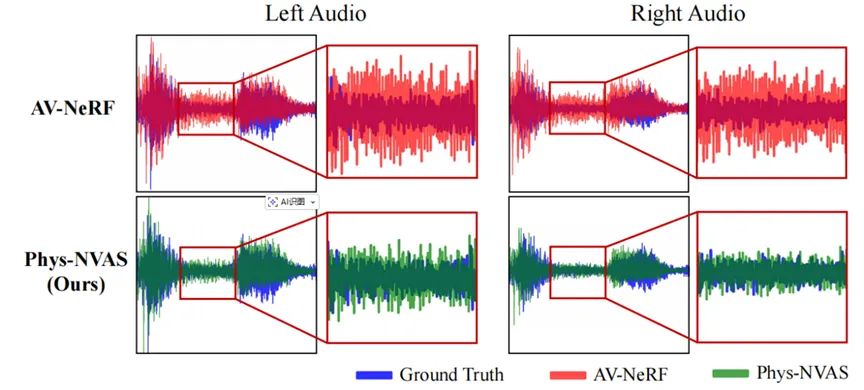
图3:生成波形对比(示意图)
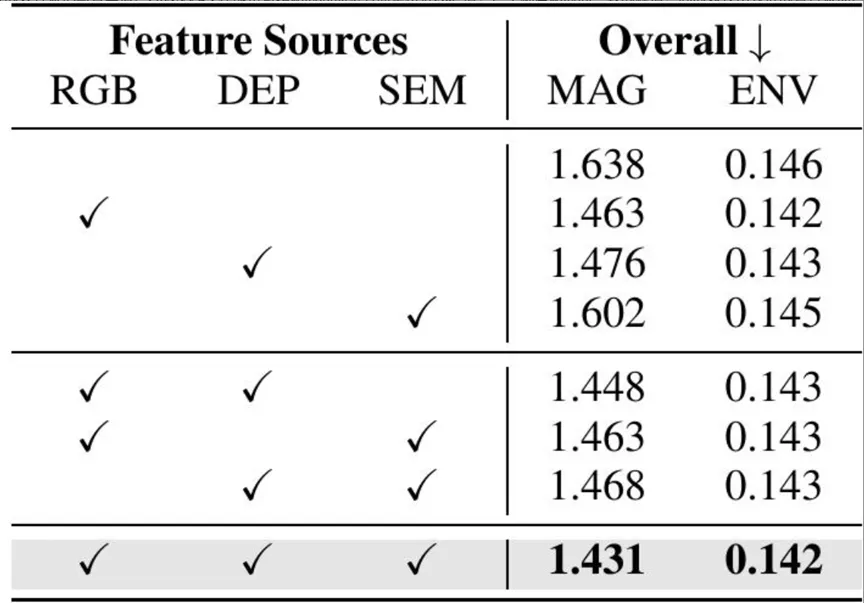
消融实验进一步验证了各模块的贡献。如表2所示,几何特征(RGB, DEP)和语义特征(SEM)各自都能提升性能,而三者结合时达到最优,证明了几何与语义信息的强互补性。
表2:特征消融研究结果 (Overall↓)
本文提出了Phys-NVAS,一个物理感知的新视角声学合成框架。团队首次将多视角三维环境重建与视觉语言模型提取的物理语义先验相结合,统一建模了场景的几何、物体布局和材质属性,生成了空间感更真实、物理一致性更强的双耳音频。
这项工作为下一代沉浸式交互(如AR/VR、元宇宙)中的空间音频合成提供了新范式。未来,团队将探索更精细的材质声学属性建模,并将该框架扩展到更动态、更复杂的开放世界场景中。
