
 语音小管家
近年来,扩散语言模型(diffusion large language models, dLLMs)逐渐成为自回归(autoregressive, AR)解码范式之外的重要生成框架。与严格从左到右逐 token 生成的 AR 模型不同,dLLMs 通过对部分掩码序列进行迭代去噪,实现任意顺序的 token 建模,并在推理阶段支持并行更新。这种生成机制不仅改变了解码方式,也在训练目标与上下文利用方式上提供了不同的建模视角。
近期文本领域的研究进一步表明,在高质量训练数据规模受限的条件下,dLLMs 往往展现出较强的数据利用能力:在固定数据预算下,模型仍可通过更密集的计算与隐式的数据增强机制持续提升性能。相比纯文本数据,覆盖语音、环境声与音乐等多模态信息的高质量音频—文本监督数据获取成本更高、规模扩展更为困难,因此在数据受限场景下提升模型效率尤为重要。此外,严格顺序的 AR 解码在音频理解与交互场景中可能带来延迟方面的约束,而 dLLMs 在机制上支持乱序与并行解码,为推理加速提供了一种潜在路径。
尽管扩散模型在机制层面具备上述优势,当前主流的大型音频语言模型(LALMs)仍然主要基于 AR 架构。诸如 Qwen-3-Omni、Qwen-2.5-Omni、Kimi-Audio 等系统均基于 AR LLM ,并在多种音频理解与对话基准上取得了具有竞争力的性能表现。在这一背景下,一个自然而关键的问题是:
在有限数据规模与算力约束下,扩散语言模型能否被构建为一种具有竞争力且具备实用性的音频骨干架构,在通用音频理解任务上达到与主流AR LALMs 相当的性能水平?
在前期工作DIFFA 中,团队初步验证了将扩散语言模型引入音频理解的可行性。然而,该工作仍主要停留在概念验证阶段:模型训练以语音识别/描述为主,语音编码器规模较小,扩散骨干保持冻结,尚未系统引入大规模指令数据与偏好优化目标,也未充分评估推理效率问题。
为此,团队提出了DIFFA-2,旨在以扩散语言模型为基座,在更完整的语义—声学对齐与可扩展训练框架下,构建一个具备实际竞争力的通用音频理解大模型。
DIFFA-2 以预训练语音编码器和扩散语言模型为基础,在结构设计和训练流程上进行了有针对性的改造,力图在可控的参数和数据预算下提升通用音频理解能力。
1. 双适配器结构
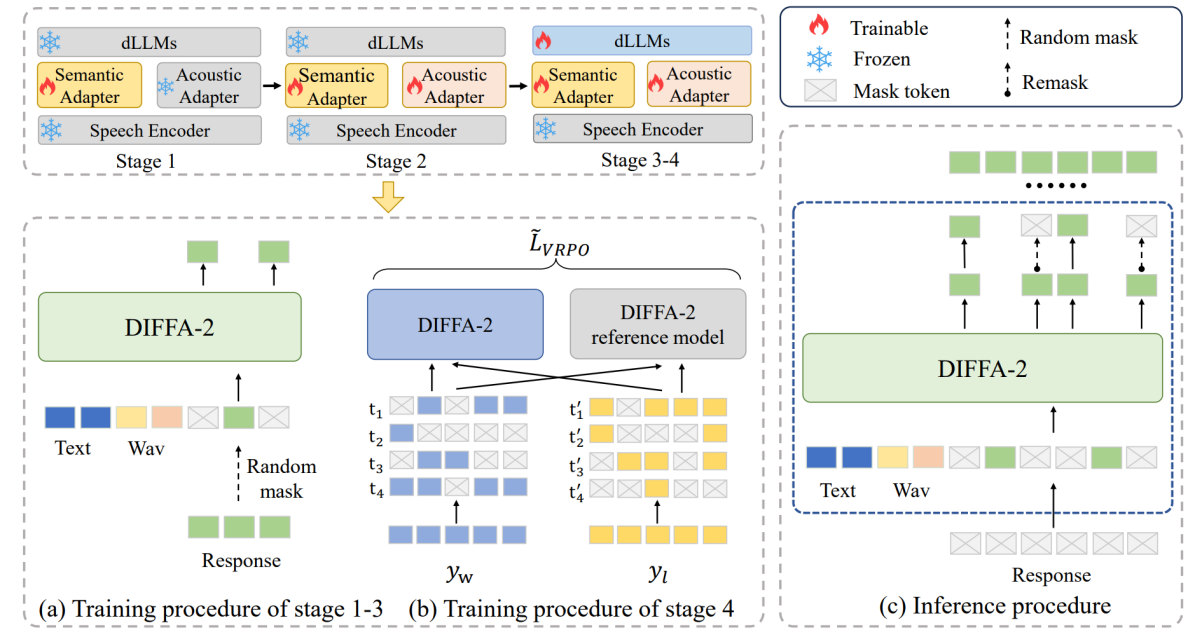
针对语音模态,DIFFA-2在Speech Encoder的基础上引入双适配结构,分别建模语义与声学信息。Semantic Adapter 采用卷积+全连接结构,对语音编码器最终层输出进行下采样用于语义内容对齐;Acoustic Adapter 采用 Q-Former 结构,从中间层特征中捕获声学信息。在这一结构下,Speech Encoder参数保持冻结,将语义和声学信息高效融入 dLLM。
2. 渐进式四阶段训练流程
为兼顾训练稳定性与最终性能表现,DIFFA-2设计了渐进式四阶段训练策略,逐步优化不同模块:
阶段一:ASR 语义对齐冻结dLLM,以 ASR 任务训练Semantic Adapter,实现语音-文本语义对齐。
阶段二:语义–声学联合建模冻结dLLM,同时优化 Semantic Adapter 与 Acoustic Adapter,引入覆盖语音、环境声与音乐等多类型音频理解和问答任务,使模型能够在统一架构下处理不同类型音频信号。
阶段三:扩散语言模型的轻量微调通过参数高效化技术(如LoRA),在前两阶段对齐的基础上对扩散语言模型进行适度微调,使其更好地适应音频的理解与推理任务。
阶段四:基于偏好数据的VRPO 对齐使用“优选答案–对比答案”形式的偏好数据,采用 VRPO 方法,从优化目标层面进一步对齐模型输出与人工偏好,特别强调对细粒度声学线索的敏感度与稳定性。
整体来看,这一训练流程从内容对齐、模态融合到偏好优化逐步推进,尽可能在有限的可训练参数和数据规模下挖掘扩散骨干在音频理解任务中的潜力。
1. 实验设置:
训练数据:约11000小时开源语音识别数据与基于3767小时开源数据集构造的指令微调数据。
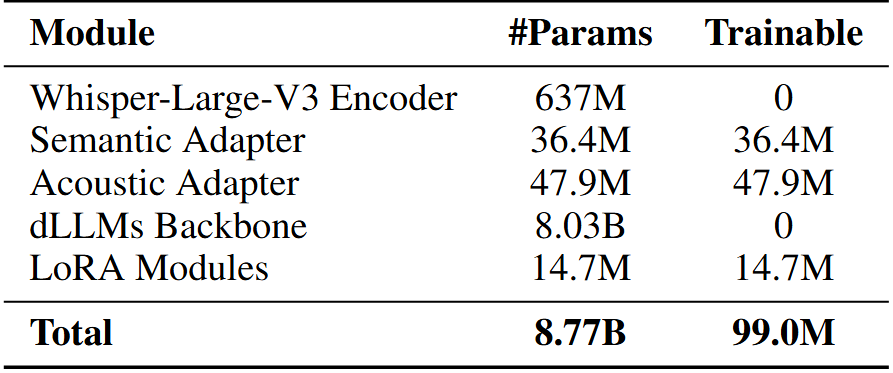
模型参数:在冻结语音编码器与大部分语言模型参数的前提下,可训练参数约为 99.0M,占总参数量约 1.1%。
2. 性能评估:
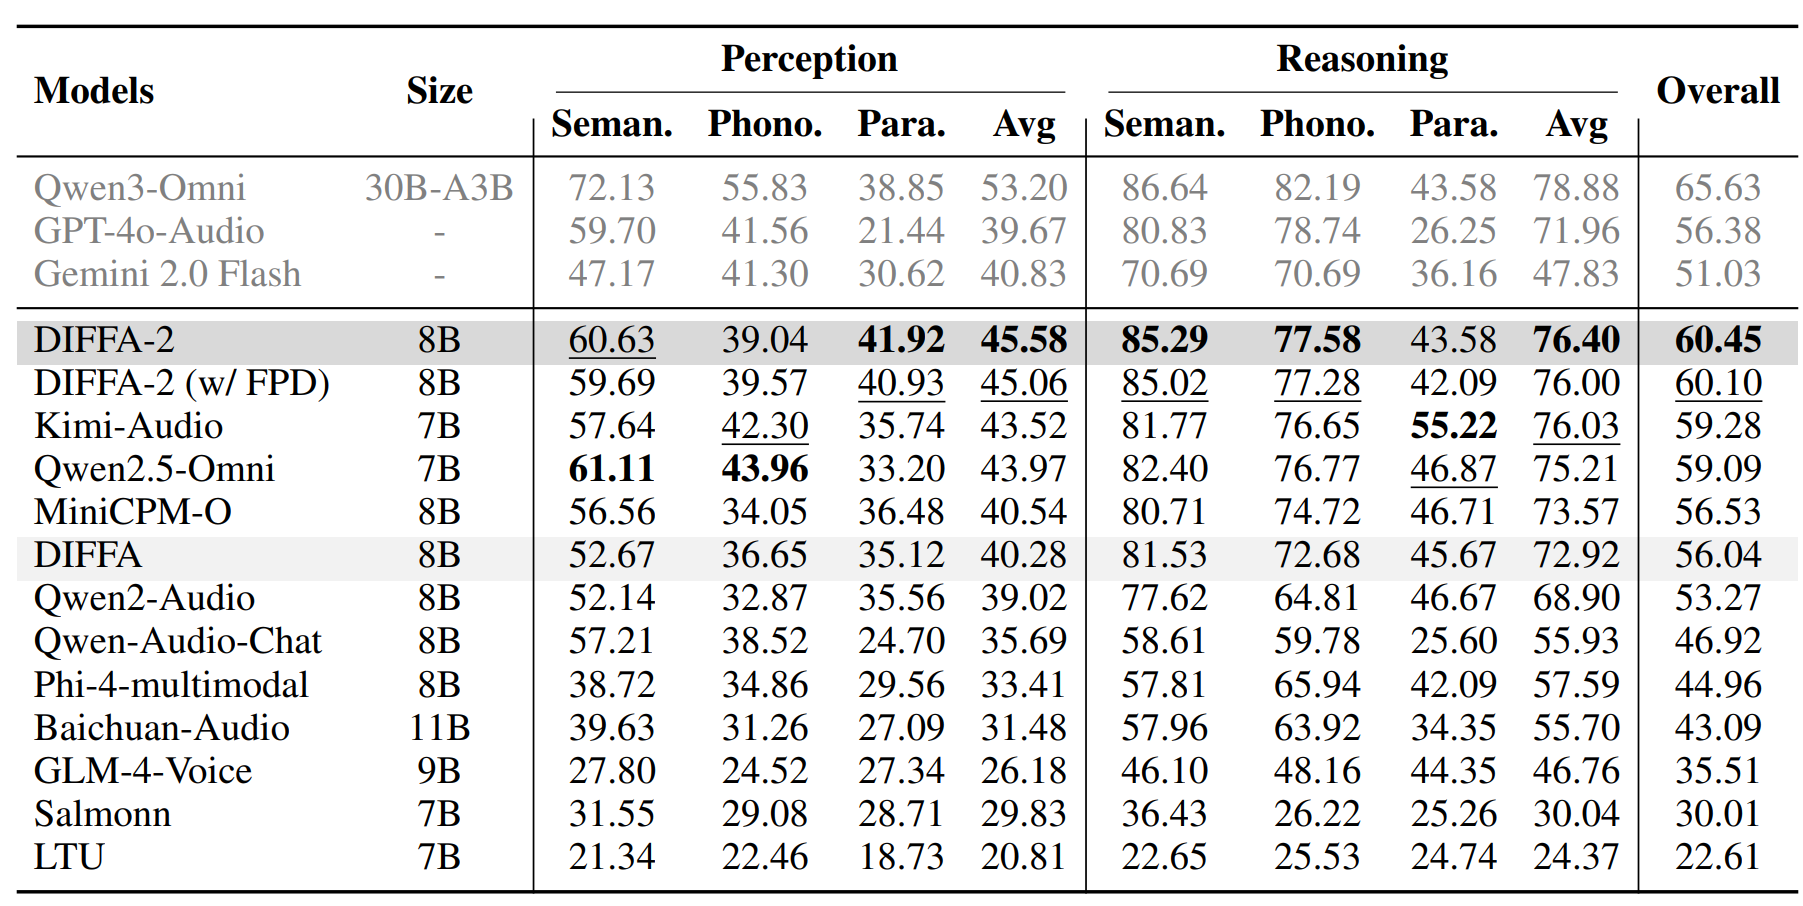
为系统评估DIFFA-2 的音频理解能力,团队选取了多个公开基准进行实验,如 MMSU、MMAU、MMAR 等。对比对象包括:团队早期提出的第一代 DIFFA 模型,若干同量级的开源自回归音频大模型,以及部分更大规模开源/闭源系统作为性能上界参考。
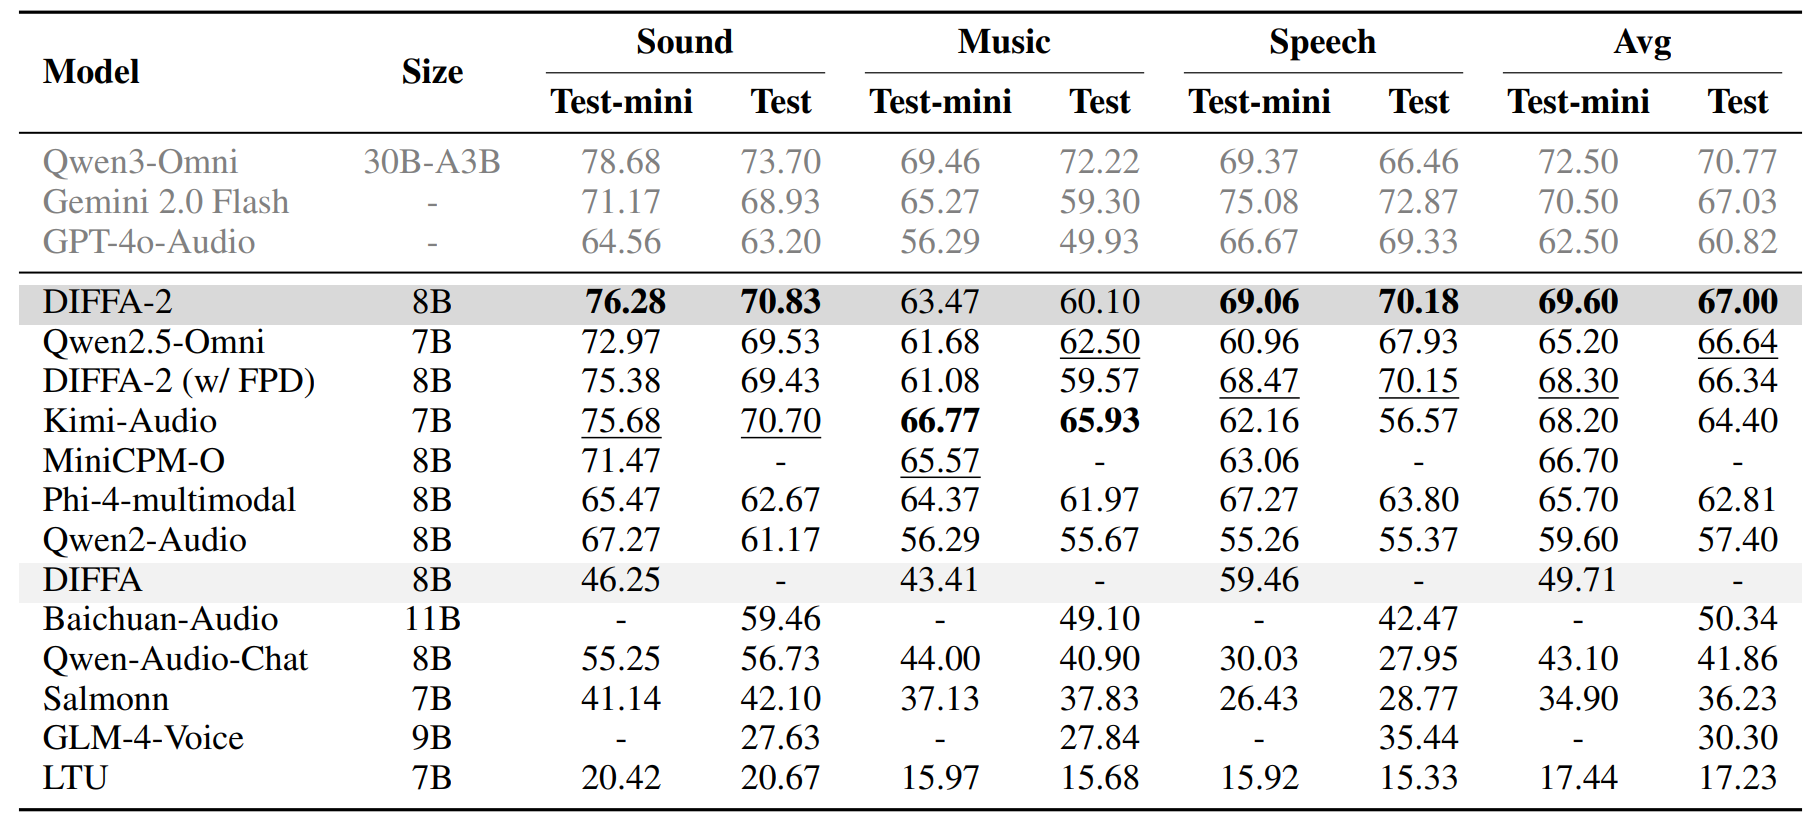
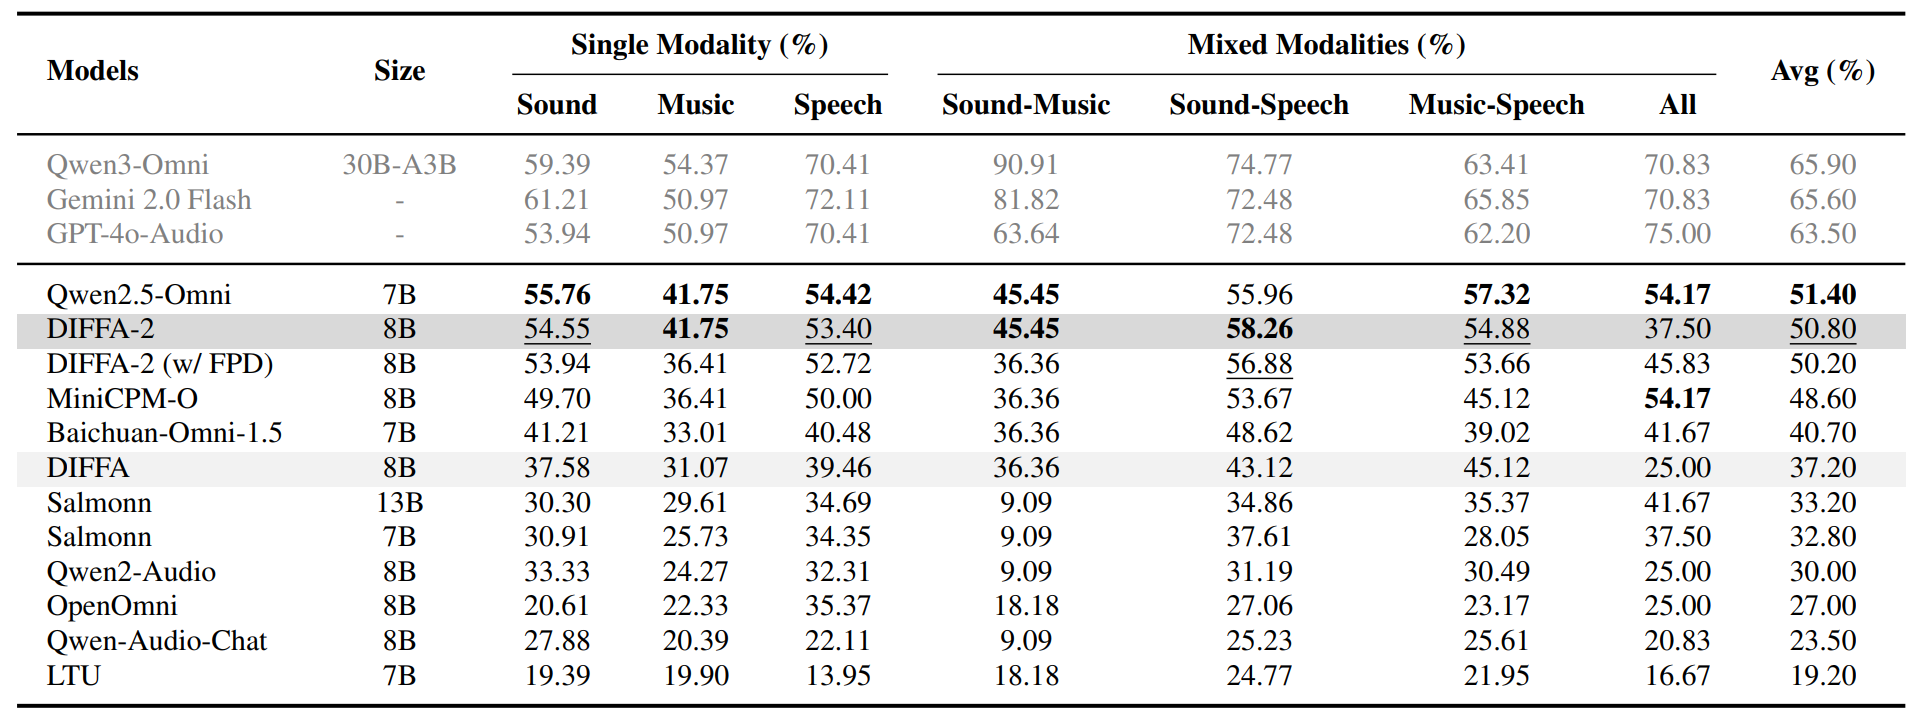
总体来说,在只引入约1.1%(约 99M)可训练参数、使用约 1.48 万小时开源数据的前提下,DIFFA-2 在 MMSU、MMAU、MMAR 等通用音频理解与推理基准上显著优于DIFFA,并与同量级AR 音频大模型(如 Qwen2.5-Omni、Kimi-Audio 等)整体表现大致相当,在部分子任务上取得了更优结果。具体实验结果如下:
1)MMSU(覆盖多种语义理解与推理题型的大规模口语理解基准)
2)MMAU(面向语音、环境音与音乐的综合评测基准)
3)MMAR(针对复杂声源组合和多模态交互的音频推理基准)
4)消融实验
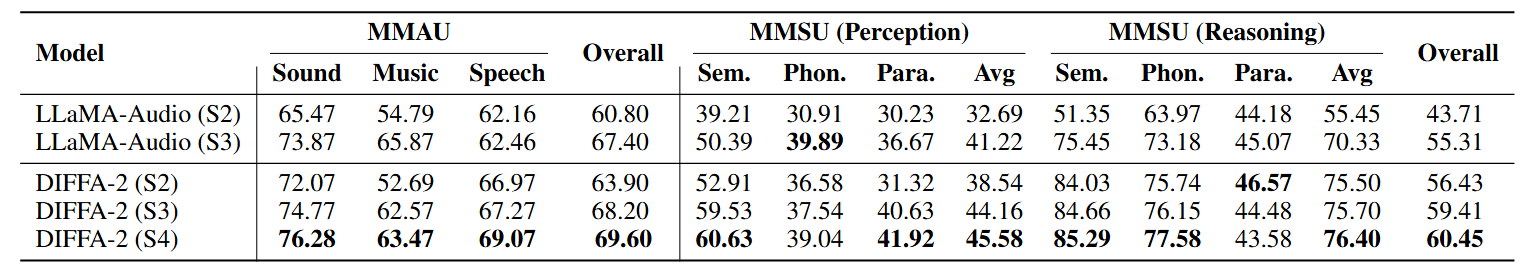
此外,消融实验表明:相较于自回归对照组LLaMA-Audio(在相同数据量、训练策略和双适配器设计下),DIFFA-2 在多个基准上取得了稳定的性能提升;同时,渐进式四阶段训练也是性能提升的重要来源,各阶段均对 MMSU/MMAU 等基准上的最终结果贡献明显。
综上所述,DIFFA-2 系统性探索了在有限的数据与算力预算下,如何利用扩散语言模型构建具有竞争力的音频理解大模型。通过双适配器结构、渐进式四阶段训练以及偏好优化方法,本研究在多个音频理解与推理基准上取得了接近 Qwen2.5-Omni 的整体表现,表明扩散语言模型在音频理解场景中具有较大的应用潜力。
Github: https://github.com/NKU-HLT/DIFFA
Huggingface: https://huggingface.co/zhoujiaming777/DIFFA-2
