
 语音小管家
「现存问题」
TTS(文本转语音)这两年进步很快,很多模型在测试集上能做到很低的 WER(词错误率),听起来“字面上没问题”。
但现实场景里,用户真正关心的往往不是“每个词都对”,而是:
这段语音里提到的关键信息我能不能抓住?例如:日期、金额、地点、人名、缩写、事件名称等
新闻/播报/客服这种信息密集场景,听懂重点比逐词对齐更重要
传统评测卡在两个瓶颈:
WER只关心逐词准确,不关心“关键事实有没有被听懂”
现有TTS测试集往往缺少真实世界中最容易出现的“非规则文本”
数字(2 vs 2000)
专有名词(地名、人名)
缩写(Ala. 这种)
时间、地点、事件等信息点
于是就出现一个典型现象:WER很低 ≠ 你真的听懂了关键内容。
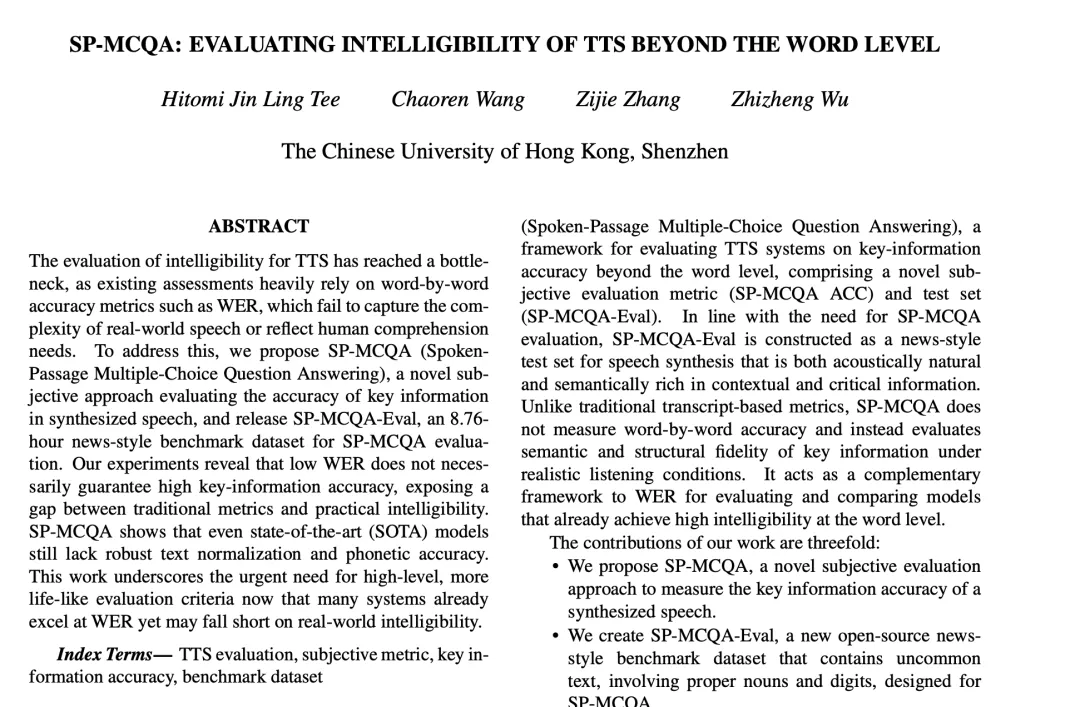
论文:https://arxiv.org/pdf/2510.26190
「解决方案」
我们提出一个更贴近日常“听懂”标准的评测框架:
SP-MCQA(Spoken-Passage Multiple-Choice Question Answering)用“听一段合成语音 → 做多选题”的方式,评测TTS是否准确传达关键信息。
并发布了配套基准集:SP-MCQA-Eval(新闻风格、信息密集)。
它的定位不是取代WER,而是作为补充:当模型WER已经很漂亮时,用SP-MCQA去拉开差距,看谁真正能“把重点说清楚”。
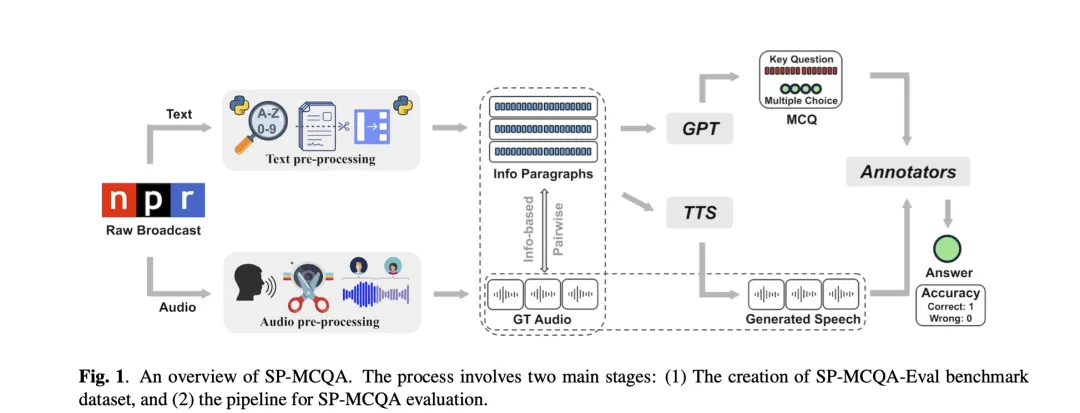
✅核心工作一:SP-MCQA-Eval——专门为“关键信息翻车点”设计的测试集
1)数据从哪来?
来源:NPR(美国国家公共电台)新闻
特点:口语化 + 信息密集(天然包含人名地名数字事件)
2)为什么它比传统测试集更“刁钻”?
我们专门筛选那些包含关键点的段落,比如:
至少包含一个3位数以上的数字
至少包含多个大写字母(常对应缩写/专名)
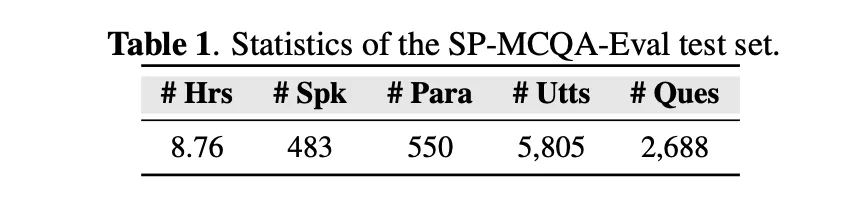
最终构建数据集规模如下:
8.76小时
483位说话人
550段信息段落(paragraph)
5,805条语音切片(utterances)
2,688道选择题(questions)
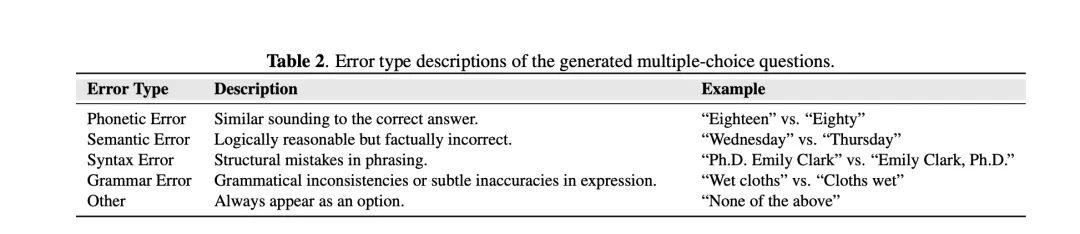
✅核心工作二:SP-MCQA题目怎么出?——把“常见听错类型”做成干扰项
每道题都是四选一:
1个正确答案
2个干扰项(对应不同错误类型)
1个固定选项:Other(以上都不是/音频里不是这么说的)
干扰项不是乱编的,而是刻意覆盖“合成语音最常见的误导方式”:
Phonetic Error(音近错误):听起来很像例:“Eighteen” vs “Eighty”
Semantic Error(语义合理但事实错):例:“Wednesday” vs “Thursday”
Grammar Error(语法/细微表达偏差):例:“Wet cloths” vs “Cloths wet”
Other:永远提供,兜底处理“都不匹配/听不清/内容缺失”
题目由GPT-4o-mini自动生成后,再进行人工检查,剔除幻觉题。
✅核心技术三:SP-MCQA怎么评?——让人按“听力考试规则”判卷
评测流程非常“考试化”:
听合成语音
看文本题目与选项
选“音频里明确说了什么”,禁止脑补推理
标注设置也比较严格:
40名标注者:英语母语者或雅思听力8.0+
每题至少2人作答,有分歧再加人,最多到4人
10%任务插入“金题”做质检:金题必须100%正确,否则该标注者数据作废并重分配
最终指标:SP-MCQA ACC(做题正确率的平均值)
「关键结果:WER低不代表关键信息说对了」
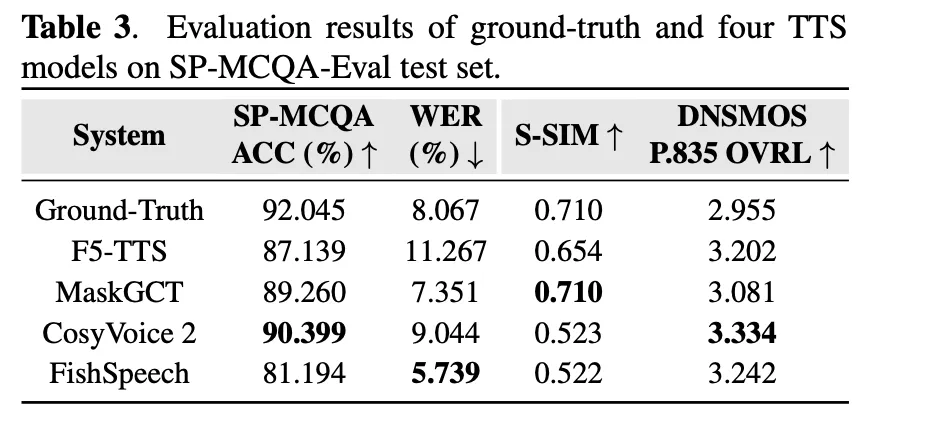
最核心的反直觉结论:
FishSpeech:WER最低(5.739%),但SP-MCQA正确率却最低(81.194%)
CosyVoice2:WER并不最低(9.044%),但SP-MCQA正确率最高(90.399%)
也就是说:“看起来对”的模型,可能在数字、缩写、人名等关键点上掉链子;而这些掉链子,正是现实应用最致命的。
「错在哪?」主要不是“理解能力”,而是两类硬问题
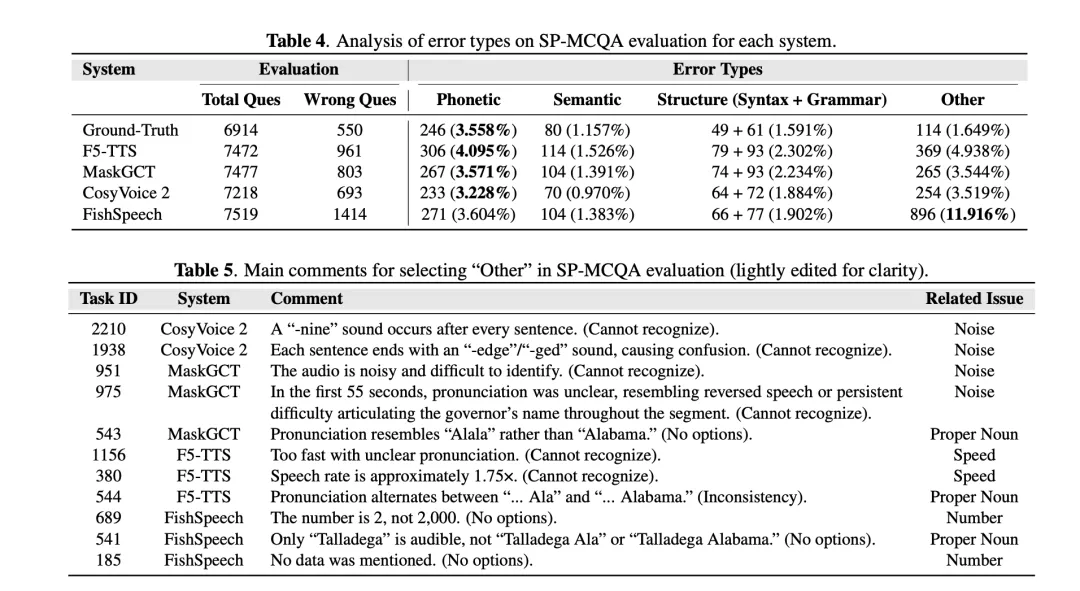
我们进一步做了错误类型统计与“Other”原因总结,结论很清晰:
1)最常见的是:音近/发音错误(Phonetic)
所有系统里占比最高,尤其在数字、专名、缩写上更容易发生。
2)其次是:结构/语义偏移(像“说着说着改了/漏了/编了”)
我们观察到:NAR(非自回归)模型(F5-TTS、MaskGCT)更容易出现这类结构/语义错误比例偏高的情况。
3)“Other”往往来自实际可用性问题
标注者选Other的典型原因包括:
句尾怪音/噪声(听不清)
语速过快(信息抓不住)
专名缩写读错(Ala.→Alala)
数字归一化出错(2→2000 或反之)
「总结」
SP-MCQA想推动的是一个评测观念转变:
当TTS已经能把WER做到很低时,行业需要更“像生活”的评测,尤其是新闻播报、客服、语音助手这种高风险场景:你到底有没有把关键事实说清楚?
未来方向:
用 Audio LLM 做更省人力、可规模化的评测(替代大规模人工做题)
扩展到更多语言,指导多语种TTS在“数字/专名/缩写”等关键点上的提升
