语音小管家
Project Page:https://soul-ailab.github.io/soulx-liveact/ Technical Report:https://arxiv.org/abs/2603.11746 Source Code:https://github.com/Soul-AILab/SoulX-LiveAct Hugging Face:https://huggingface.co/Soul-AILab/LiveAct
SoulX-LiveAct 亮点
1) 恒定显存:真正支持无限时长生成
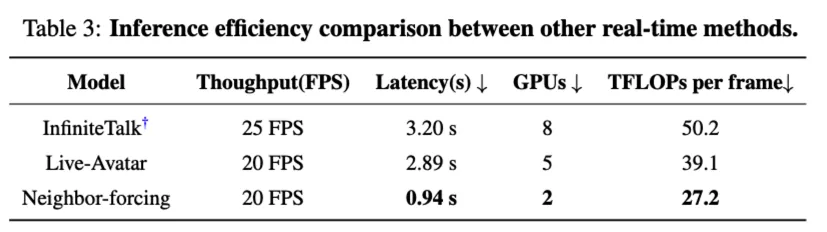
2) 实时吞吐:2 张 H100/H200 即可 20 FPS 流式推理
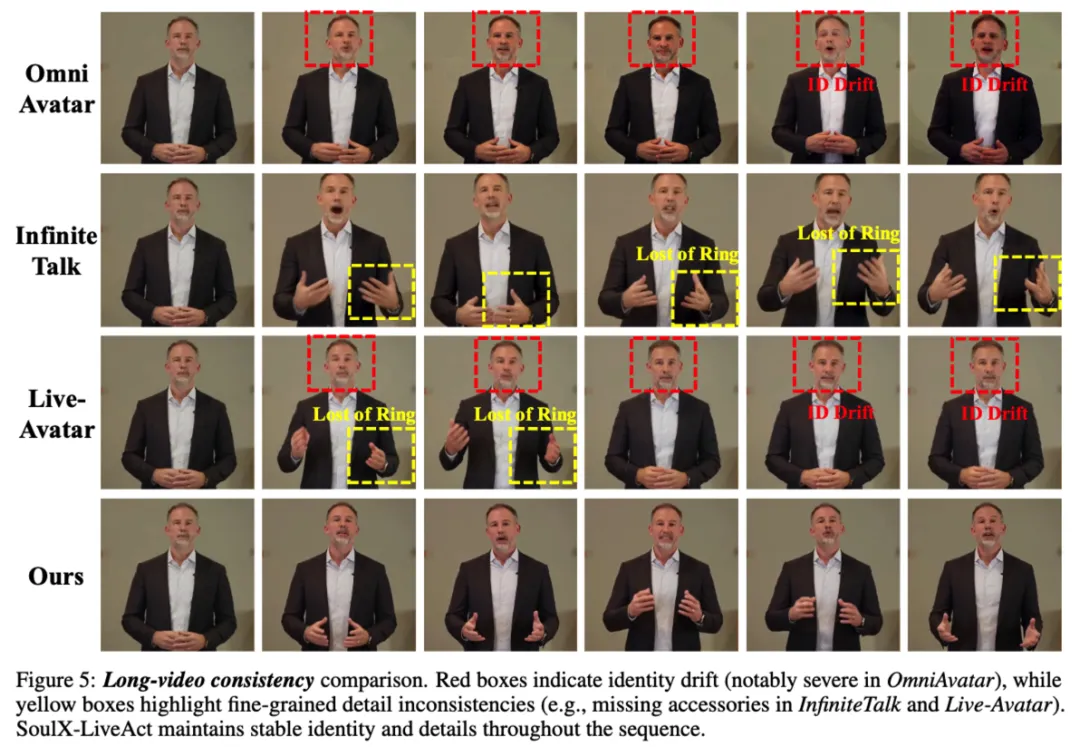
3) 长时一致:身份稳定 + 细节不“掉件”
Neighbor Forcing+ConvKV Memory
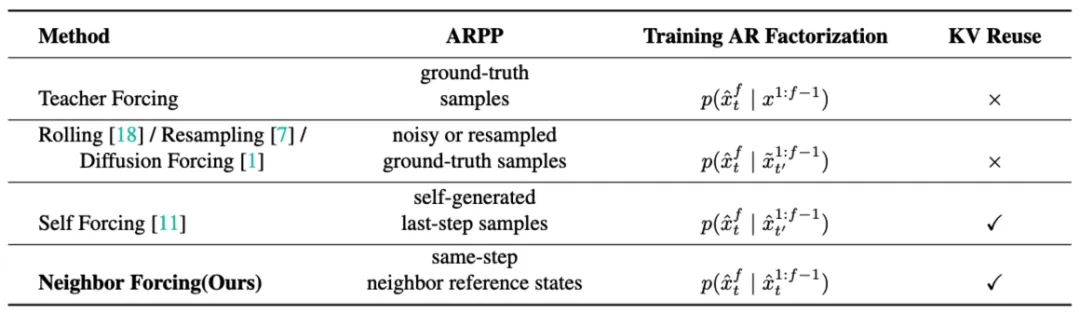
AR Diffusion 主干:按 chunk/帧块自回归生成,每个 chunk 内采用扩散建模细节,chunk 间通过条件上下文承接运动与身份信息,实现流式推理闭环。 Neighbor Forcing(邻近强制):在自回归链上,不传播“不同扩散步”的状态,而是传播 同扩散步 ttt 下的相邻帧 latent 作为条件,使上下文与当前预测处于同一噪声语义空间(step-aligned),显著降低训练/推理中的分布不一致。 ConvKV Memory(卷积式 KV 记忆):将历史 attention KV 记忆从“线性增长的 cache”改为“短期精确 + 长期压缩”的组合:近期 KV 保留高精度窗口(保证局部一致与细节稳定)、远期 KV 通过轻量 1D conv 按固定压缩比滚动压缩(例如报告示例 λ=5),把历史信息压缩进固定长度表示,从而实现常量显存推理。
RoPE Reset(位置对齐):配合 ConvKV Memory 的“压缩+滑动窗口”,通过 RoPE reset 做位置编码对齐,避免长序列位置漂移,强化长时稳定。
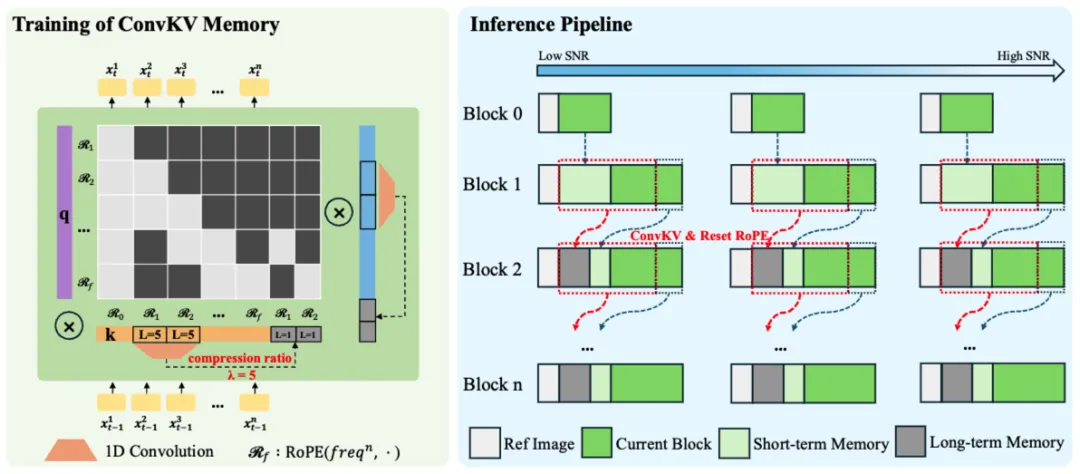
Neighbor Forcing 对齐训练分布:训练时强制模型在同扩散步语境下接收来自“相邻帧”的条件 latent,减少 AR 链中跨步噪声空间不一致带来的优化震荡,使模型更好学到稳定的时序承接规则。 长时一致性导向的自回归训练构造:训练样本按 chunk 方式组织,显式覆盖“连续 chunk 合成 → 误差累积 → 再纠正”的过程,让模型在训练期就暴露并学习处理长时漂移问题,而不是仅在短 clip 上拟合。 Memory-Aware 训练(与推理一致):训练阶段引入与推理一致的 ConvKV Memory 使用方式(短期窗口 + 长期压缩),让模型学会在“被压缩的历史记忆”条件下保持身份与细节一致性,避免训练/推理不一致导致的掉点。
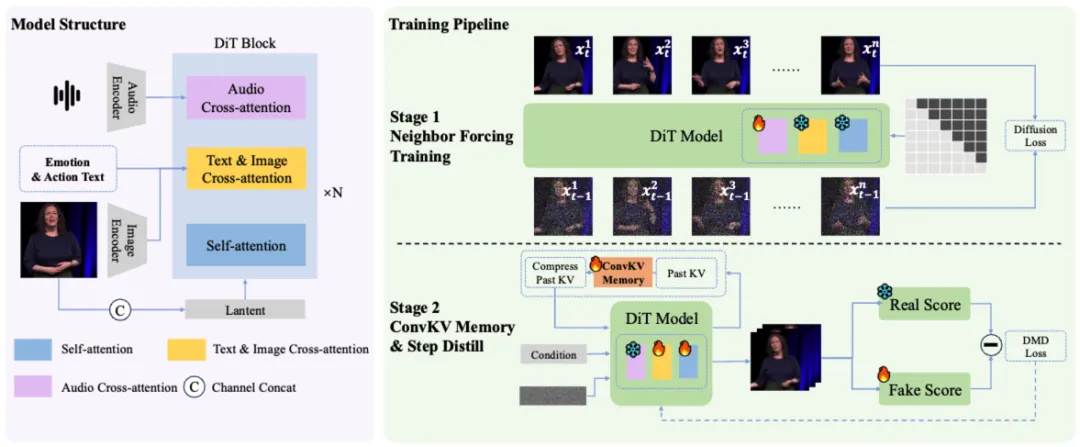
恒定显存(Constant-Memory Inference):ConvKV Memory 把历史 KV 从线性增长变为固定预算,推理显存随视频时长保持恒定,这是小时级在线生成的必要条件。 稳定延迟(Stable Latency):短期窗口 KV 保证局部质量,长期压缩 KV 保证全局一致;两者组合使每个 chunk 的计算与通信成本保持稳定,不会因为视频越长而拖慢。 端到端实时能力:在 512×512 下,系统可在 2×H100/H200 条件下实现 20 FPS 的流式推理,并给出约 0.94s 的端到端延迟与 27.2 TFLOPs/frame 的成本口径。
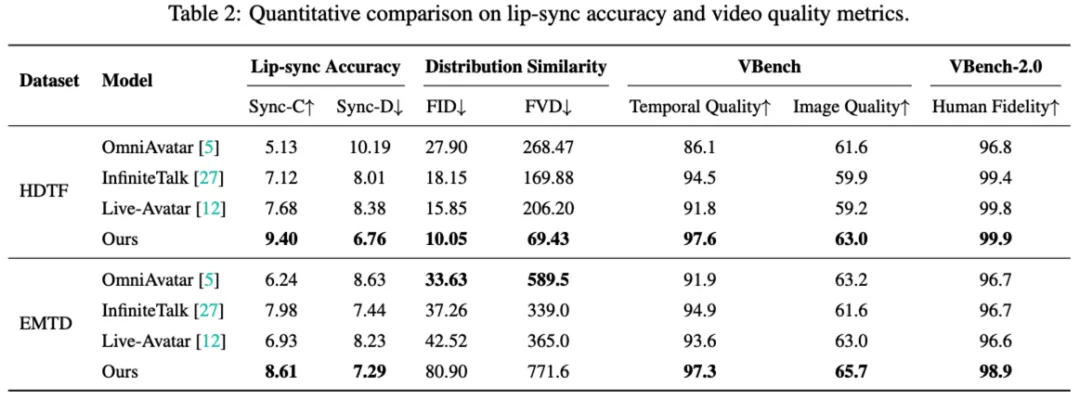
综合表现