
 语音小管家
Singing Accompaniment Generation(SAG,人声伴奏生成)想做的事很直观:给你一段干净的人声/旋律,模型生成一段和声、节奏匹配的伴奏。
但现实里,很多SAG系统都踩在同一个坑上:它们训练时用的“人声输入”,往往不是录音棚里的干声,而是通过源分离(Music Source Separation, MSS)从整首歌里“抠出来”的人声。
问题来了:源分离的人声通常带着各种“分离瑕疵”(artifact),比如:
频谱泄漏:伴奏残留混到人声里
失真、涂抹、金属感等分离噪声
而主流做法(用mel谱、或SSL特征如MERT/w2v-BERT)会忠实保留这些声学细节。
结果就是:
1)模型学到的不是“旋律→伴奏”,而是“瑕疵→伴奏”
训练集中,人声里总带着分离瑕疵,模型会把“瑕疵纹理”当成条件的一部分,甚至把它当成“该怎么配伴奏”的线索。
2)出现致命的 Train-Test Mismatch(训练-测试不匹配)
训练:输入=“带瑕疵的分离人声”
测试:真实应用常见输入=“干声人声(无瑕疵)/录音棚stem”
于是模型一到干净人声就“找不到它熟悉的线索”,直接崩盘:生成的伴奏跟旋律毫无关系。
3)更极端:给“乐器独奏旋律”配伴奏几乎完全失败
如果输入变成一段solo吉他/钢琴旋律(没有人声、没有分离瑕疵),很多现有SAG模型更是直接失效。
论文:https://arxiv.org/pdf/2509.14052
演示与数据主页:https://anyaccomp.github.io/
ANYACCOMP的核心思路一句话概括:
不要把“带瑕疵的声学细节”当条件。
先把输入压缩成“只剩旋律本质”的离散旋律码,再用生成模型去配伴奏。
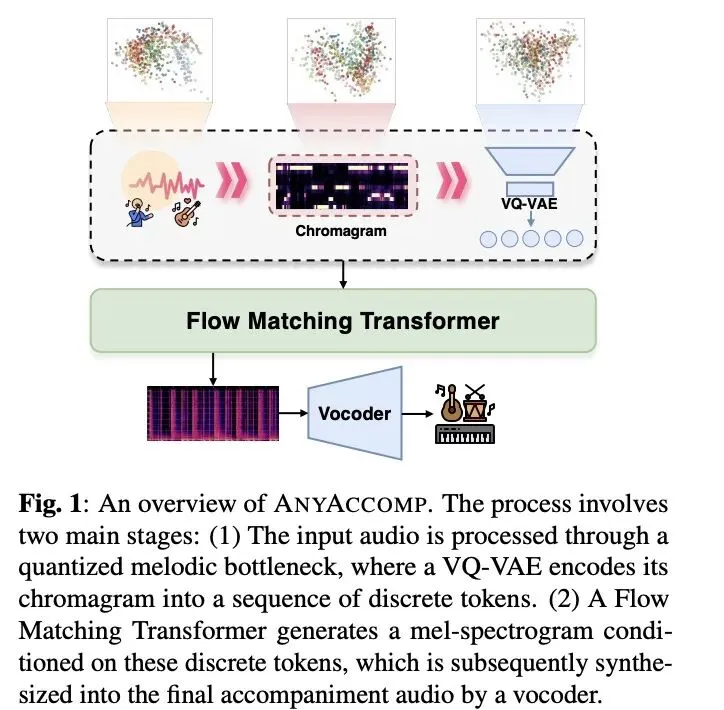
我们把它拆成一个两阶段框架:
✅核心工作一:Quantized Melodic Bottleneck(量化旋律瓶颈)——只保留旋律,抹掉音色/瑕疵
我们认为一个“靠谱的条件表示”要满足两个性质:
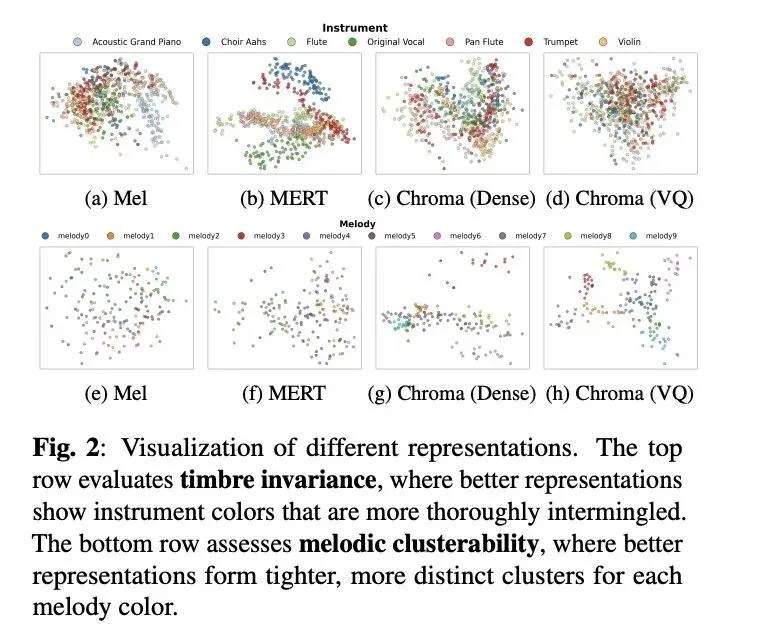
Timbre Invariance(音色不敏感)不管你是人声、钢琴还是吉他,同一段旋律在表示空间里应该差不多,不能被音色带跑。
Melodic Clusterability(旋律可聚类)同一段旋律(哪怕换了音色)应聚到一起;不同旋律要分得开——这样生成模型才“看得懂旋律结构”。
具体怎么做?
先把输入音频转成 Chromagram(色度谱):只看12个音高类别(及其扩展bin),天然比mel谱更弱化音色细节
再用 VQ-VAE 把chromagram进一步量化成离散token序列(相当于“旋律码”)
离散化会强迫模型用有限码本表达主要旋律结构,进一步丢掉与旋律无关的纹理(包括分离瑕疵)
我们用可视化对比了四种表示:Mel、MERT特征、Dense Chroma、VQ Chroma。
结论非常明确:
Mel / MERT:明显按“乐器类型/音色”聚类(音色不敏感做不到)
Dense Chroma:有所改善
VQ Chroma(ANYACCOMP用的):
不同乐器点云充分混合(音色不敏感最好)
同一旋律簇更紧、更分明(旋律可聚类最好)
这一步的本质是:把条件从“声学细节”升级成“更像符号的旋律结构”。
✅核心工作二:Flow-Matching Transformer ——用“旋律码”来生成伴奏(而不是用带瑕疵的人声谱)
第二阶段才进入生成:
条件:第一阶段输出的离散旋律码 c
目标:生成伴奏的mel-spectrogram,再通过vocoder合成音频
生成模型:Flow-Matching Transformer(FM)
训练上还加了一个REPA对齐损失:把模型中间层对齐到预训练音乐模型(MERT)的表征,帮助更稳的音乐感知
直观理解:
生成模型只“看旋律码”,不再“看分离瑕疵纹理”,从机制上切断了过拟合瑕疵的通路。
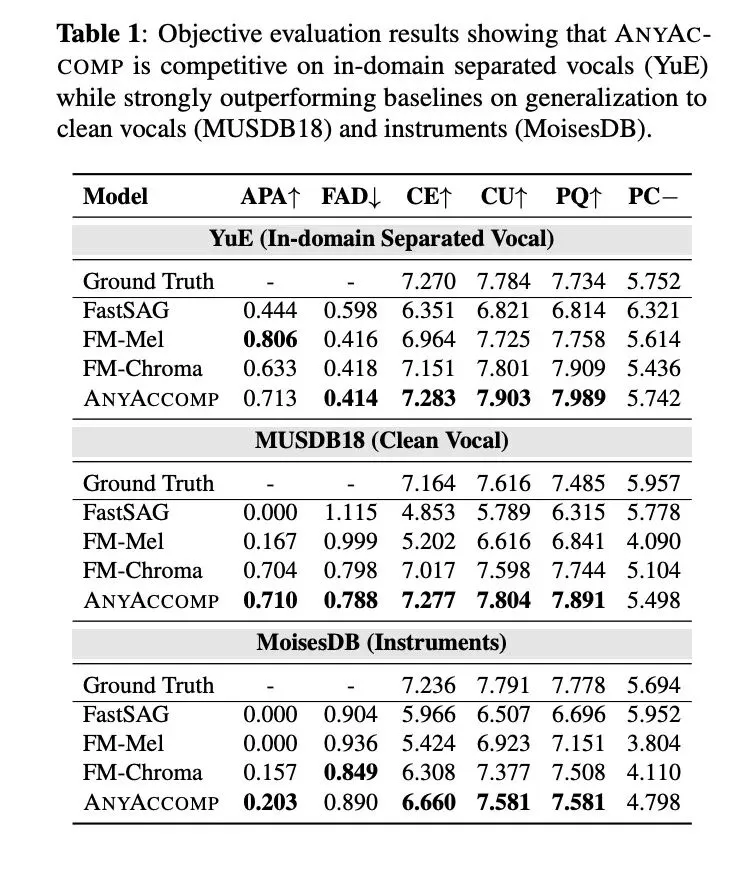
我们的评测设计也很“针对痛点”,分三套数据集(全部10秒clip):
YuE(域内):分离人声(跟训练分布相近)
MUSDB18(关键泛化):干净vocal stem(无分离瑕疵)
MoisesDB(极限泛化):solo乐器旋律(人声SAG模型最容易挂的场景)
关键客观结果
看伴奏和谐度就够了——它衡量“生成的伴奏是否跟输入旋律对得上”:
MUSDB18(干声)
FastSAG:APA 0.000(完全崩盘)
ANYACCOMP:APA 0.710(仍然能对齐旋律)
MoisesDB(乐器独奏)
FastSAG:APA 0.000(完全失败)
ANYACCOMP:APA 0.203(首次实现“对乐器旋律也能配伴奏”)
同时FAD等指标也显示ANYACCOMP在泛化集显著更好,说明不是“随便生成点音乐糊弄”,而是整体分布更接近真实伴奏。
典型失败案例
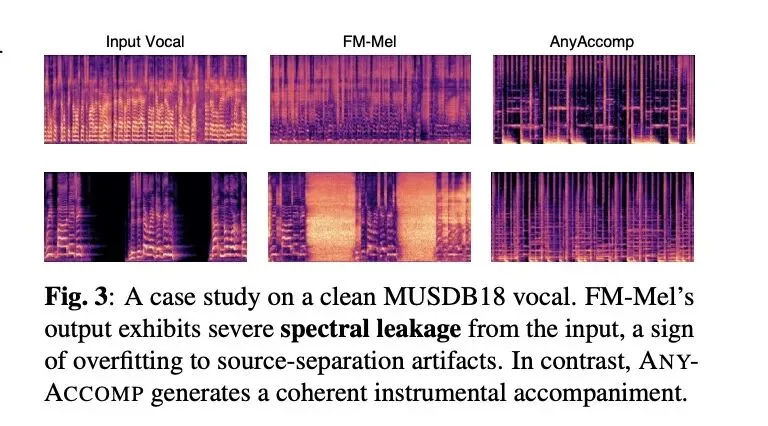
在干声输入上,使用mel条件的模型会出现严重spectral leakage(频谱泄漏):输出里直接抄进了输入的残留/纹理——这是典型“学会瑕疵相关性”的症状。ANYACCOMP则能生成更干净、更像独立伴奏的谱。
主观听感
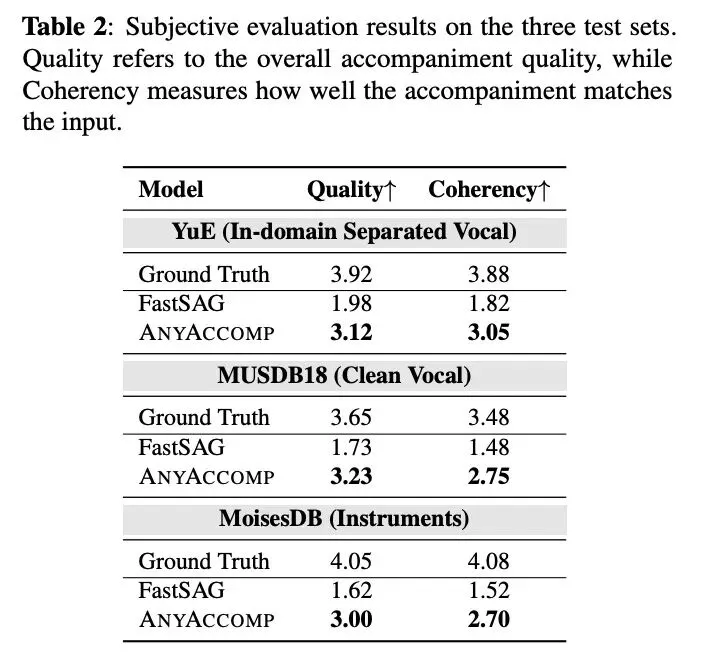
在三套数据上,听众都明显更偏好ANYACCOMP:
YuE:Quality 3.12 / Coherency 3.05(FastSAG仅约1.9/1.8)
MUSDB18:Quality 3.23 / Coherency 2.75(FastSAG约1.7/1.5)
MoisesDB:Quality 3.00 / Coherency 2.70(FastSAG约1.6/1.5)
一句话:不仅指标好,听起来也更像“真能用”。
ANYACCOMP解决的是SAG长期的“工程级痛点”:
过去:模型对“源分离瑕疵”形成依赖 → 一到干声就崩现在:用“量化旋律码”做条件 → 旋律与音色/瑕疵解耦 → 干声/乐器也能泛化
它最大的意义不只是把分数刷高,而是把SAG从“只能在分离人声基准上跑分”推进到更实用的场景:
录音棚vocal stem快速配伴奏
甚至给solo乐器旋律做自动配器/伴奏雏形(共创工具潜力很大)
