
 语音小管家
近日,Soul App AI 团队(Soul AI Lab)联合上海交通大学 X-LANCE Lab和西北工业大学 ASLP@NPU 团队,正式开源 SoulX-Duplug —— 一款面向 全双工语音对话系统(Full-Duplex Spoken Dialogue System) 的即插即用流式状态预测模块。
SoulX-Duplug 旨在解决当前语音对话系统中 实时交互能力不足、系统响应延迟高、模块耦合严重 等问题。通过将 语音活动检测(VAD)、语音识别(ASR)与对话轮次判断(Turn Detection)统一建模,SoulX-Duplug 可以帮助传统的半双工语音系统在 无需修改原有模型架构的情况下,快速获得 全双工语音交互能力。 项目还开源了 SoulX-Duplug-Eval,一个面向全双工语音对话系统的 双语评测基准,以促进该领域更标准化和可比较的研究。
Demo Page:https://soulx-duplug.sjtuxlance.com/ Technical Report:https://arxiv.org/pdf/2603.14877 Source Code: https://github.com/Soul-AILab/SoulX-Duplug HuggingFace: https://huggingface.co/Soul-AILab/SoulX-Duplug-0.6B SoulX-Duplug-Eval: https://huggingface.co/datasets/Soul-AILab/SoulX-Duplug-Eval 基于SoulX-Duplug的双工对话系统:https://github.com/Soul-AILab/SoulX-Duplug/tree/dialogue-system
传统语音对话系统通常采用 半双工(Half-Duplex)交互模式:系统在用户说话时只能“听”,而在系统回答时用户则无法打断。这种严格分离的听说流程,使得交互节奏显得机械,也限制了真实对话中常见的打断(interruption)、停顿(pause)、附和(backchannel)等行为。 相比之下,全双工语音对话系统允许系统在生成回复的同时持续监听用户输入,从而支持更加自然的实时互动体验。
端到端全双工语音对话模型
近年来,一些端到端全双工语音模型开始出现,但这类方法通常将 语言生成与交互控制强耦合 在同一个模型中,带来了新的挑战:
模型训练难度高 数据需求巨大 交互策略难以控制 系统扩展性受限
模块化全双工语音对话系统
在实际工业系统中,更常见的方案是通过 VAD + ASR + Turn Detection 等模块组成级联流水线,为半双工系统提供基本的全双工能力。然而,这种方式也存在明显问题:
传统 VAD 仅依赖声学特征,缺乏语义理解 非流式 ASR 会带来额外延迟 多模块级联导致系统响应速度下降
领域内目前仍缺乏开源的流式 semantic VAD 方案。SoulX-Duplug 正是在这样的背景下提出的一种独立、可扩展的解决方案。通过将语音交互中的双工控制能力从对话模型中解耦为独立模块并进行开源,SoulX-Duplug 旨在缓解全双工模型在数据规模与系统扩展性方面的挑战,使语音对话模型的优化能够更多聚焦于记忆能力、推理能力与共情能力等核心智能能力,而不必始终受到全双工交互机制的复杂约束。与此同时,通过引入文本引导的流式状态预测机制,SoulX-Duplug 能够更准确地理解用户语义意图,并在模块化架构下尽可能降低系统延迟,从而实现更自然、高效的实时语音交互体验。
SoulX-Duplug:为语音对话系统提供“即插即用”的全双工能力
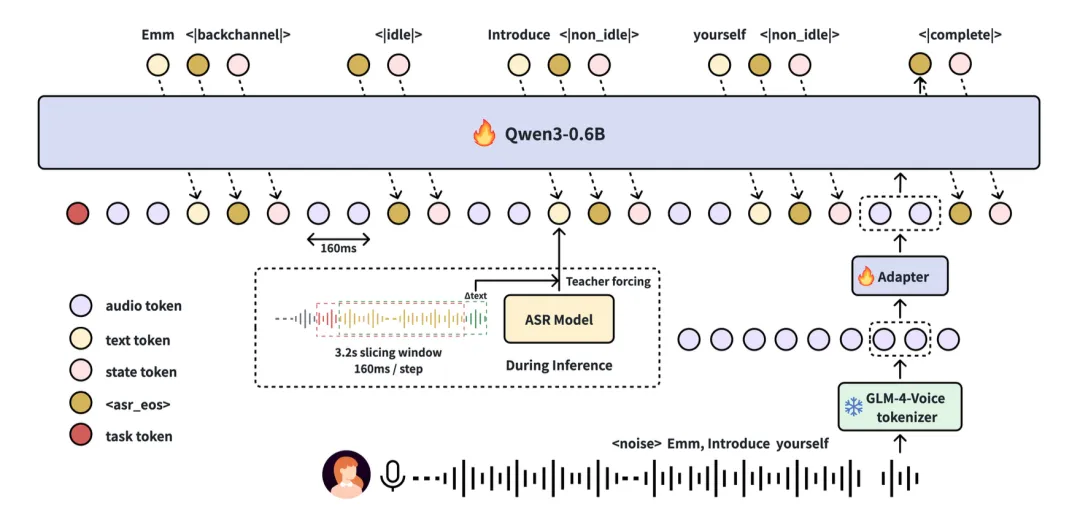
SoulX-Duplug 是一个面向实时语音交互场景设计的 统一流式状态预测模块。与传统基于多模块级联的全双工语音系统不同,SoulX-Duplug 在单一模型框架中同时完成:
语音活动检测(VAD) 流式语音识别(ASR) 对话状态预测(Dialogue State Prediction)
通过统一建模这些任务,SoulX-Duplug 能够在持续音频输入的情况下实时理解用户语音内容,并动态预测对话交互状态,从而实现更自然的全双工语音互动。总体架构上,SoulX-Duplug 采用 GLM-4-Voice speech tokenizer 以12.5Hz 的频率提取离散语音 token,取 160ms (2 token) 的处理窗口流式交替生成语音识别文本与对话状态 token。这种设计使模型能够通过语音识别理解语义并判断当前对话状态,从而实现低延迟的交互控制。
对话状态建模
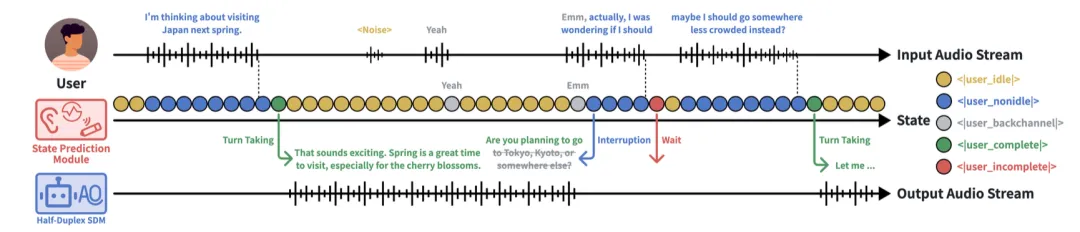
为了刻画全双工语音对话中的交互动态,SoulX-Duplug 定义了五种核心状态 token:
user_idle 表示当前音频片段不包含语义信息,例如静音或背景噪声。 user_nonidle 表示用户正在进行具有语义内容的语音输入。 user_backchannel 表示用户“嗯”“对”等 backchannel 行为。 user_complete 表示用户当前语句在语义上已经完成,系统可以接管对话轮次并进行回复。 user_incomplete 表示用户虽然暂时停顿,但语句在语义上仍未结束,系统需要继续等待用户输入。 通过这种定义方式对对话状态进行了清晰、结构化的建模。
文本引导的流式状态预测
SoulX-Duplug 的一个关键设计是 文本引导的状态预测(Text-Guided Streaming State Prediction)。传统语音活动检测方法主要依赖声学特征,难以理解语音的语义信息。而 SoulX-Duplug 通过在训练过程中引入 ASR 目标,使模型在进行状态判断的同时学习语义表示。在推理过程中,模型以 交替预测的方式生成: Audio tokens → ASR tokens → State tokens 这种设计使模型能够显式利用文本语义进行 turn detection,从而实现 语义感知的 VAD 能力(semantic VAD)。
训练 & 推理策略
SoulX-Duplug 采用 三阶段训练策略:
第一阶段:非流式 ASR 预训练
首先训练模型的基础语音识别能力,使其能够准确理解语音内容。
第二阶段:流式 ASR 适配
在流式推理设置下继续训练模型,使其适应实时语音输入场景。
第三阶段:对话状态预测微调
在该阶段联合优化VAD、ASR、对话状态预测,从而使模型具备完整的全双工交互控制能力。
在实际部署时,SoulX-Duplug 还采用了一种 Hybrid training–inference 策略:
训练阶段使用端到端联合优化,而推理阶段则可以接入高效的外部 ASR(如 Paraformer 或 SenseVoice)提供实时识别结果,从而进一步提升系统稳定性和部署效率。
客观表现
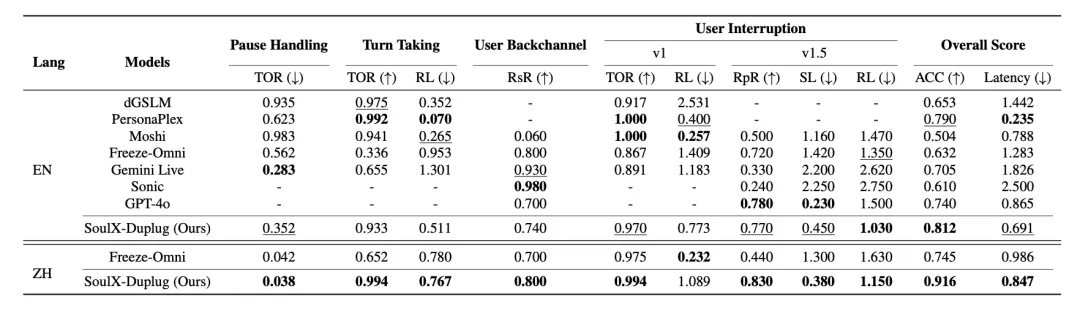
为了验证 SoulX-Duplug 在真实系统中的效果,团队以 SoulX-Duplug 作为对话状态控制模块构建了一个完整的全双工语音对话系统,并在中英双语的 Full-Duplex-Bench 基准上对系统进行了全面评测,该 benchmark 涵盖了:Turn Taking(轮次切换)、Pause Handling(停顿处理)、User Backchannel(用户附和)、User Interruption(用户打断)等多种全双工对话关键场景。
实验结果表明,基于 SoulX-Duplug 构建的系统在多个评测维度上取得了稳定且均衡的整体表现。在整体的 turn management 能力上优于现有模型,并在总体响应延迟指标上同样表现优异。这一结果充分验证了 SoulX-Duplug 的对话状态控制能力以及在系统构建中的实用价值。
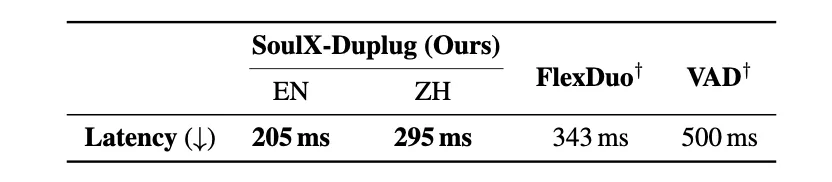
同时,实际部署环境中 SoulX-Duplug 的独立模块的平均延迟约为 250ms,接近其理论延迟 240ms。这一结果显著优于传统基于 VAD 的方案(约 500ms),也低于近期提出的 FlexDuo 模块(约 343ms)。
