
 语音小管家
论文标题:Covo-Audio Technical Report
当语音助手能听懂指令、生成语音时,却常陷入 “逻辑脱节、交互僵硬、音色难定制” 的困境,要么只会机械回应,缺乏深层语义推理;要么只能轮流对话,无法像人类一样自然打断、插话;想换个专属音色,还得重新训练大量对话数据。
腾讯 AI Lab 发布的 Covo-Audio,彻底打破了这一僵局:作为 7B 参数的端到端大型音频语言模型(LALM),它用统一架构直接处理连续音频输入、输出自然语音,不仅覆盖语音理解、音频推理、口语对话等全场景任务,还实现了低延迟全双工交互和灵活音色定制,在 URO-Bench、VCB Bench 等权威基准上全面超越同类模型,真正让语音交互从 “机械问答” 升级为 “人类级对话”。
今天,我们一步步拆解这款 “语音全栈高手” 的技术创新、实测表现和落地价值,看看它如何用 7B 参数实现 “听懂、会说、善思、共情” 的全方位突破。
一、基础概念
论文的所有创新都围绕 “端到端统一建模” 展开,我们先了解下面的关键概念,才能理解后续技术创新。
1.1 核心概念
1.2 传统语音系统 vs Covo-Audio
二、核心痛点
一直以来,语音交互难以实现 “人类级自然度”,核心问题集中在四点:
模块割裂:ASR、LLM、TTS 独立工作,文本中间表示导致语义损耗,还可能出现 “听懂却说错” 的逻辑脱节; 交互僵硬:只能 “你说我听、你听我说”,无法处理打断、插话等复杂交互,不符合人类沟通习惯; 音色绑定:端到端模型的 “对话智能” 与 “说话音色” 深度绑定,换音色需重新训练大量对话数据,成本极高; 共情缺失:仅能通过文本理解情绪,无法捕捉语音中的语调、语速等情感声学特征,回应缺乏温度。
Covo-Audio 的核心创新,就是用 “统一架构 + 专项优化” 一次性解决这四大痛点,让语音交互从 “功能实现” 走向 “体验升级”。
三、核心思路
3.1 创新1:统一架构设计 —— 端到端打通 “听 - 说 - 思”
这是论文最核心的突破:构建 “音频编码器 + LLM 骨干 + 语音令牌器 + 语音解码器” 的全栈架构,无需模块拼接,实现音频输入到音频输出的端到端流转:
核心组件
层级三模态交织策略
短语级交织:实现声学片段与词汇单元的细粒度对齐,保证韵律自然; 句子级交织:保留长文本的全局语义完整性,避免局部对齐破坏逻辑连贯; 三模态融合:统一连续声学特征(
3.2 创新2:智能说话人解耦技术 —— 音色定制无需重训对话
针对端到端模型 “音色与智能绑定” 的痛点,论文提出智声解耦策略,实现灵活音色定制:
核心逻辑:
多说话人训练:在预训练阶段融入大量多说话人数据,让模型的 “对话智能” 与 “语音渲染” 能力分离; 伪对话构建:将高质量 TTS 数据转化为 “提示 + 查询 + 文本回应 + 语音回应” 的伪对话格式,训练时屏蔽文本回应的损失计算,仅优化语音生成与智能对齐; 推理迁移:直接将 TTS 音色迁移到对话场景,无需为该音色收集专属对话数据。
关键优势:
数据高效:仅需少量 TTS 数据即可实现音色定制,大幅降低数据收集成本; 智能无损:迁移后模型的对话推理能力与原模型基本一致(URO-Bench 得分仅下降 1-2 个百分点); 自然度高:复用 TTS 的高保真音色,生成语音的自然度远超合成对话数据训练的模型。
3.3 创新3:原生全双工训练 —— 打破 “轮流对话” 限制
为实现人类级交互,Covo-Audio 将全双工能力融入预训练,而非后期适配:
架构适配:
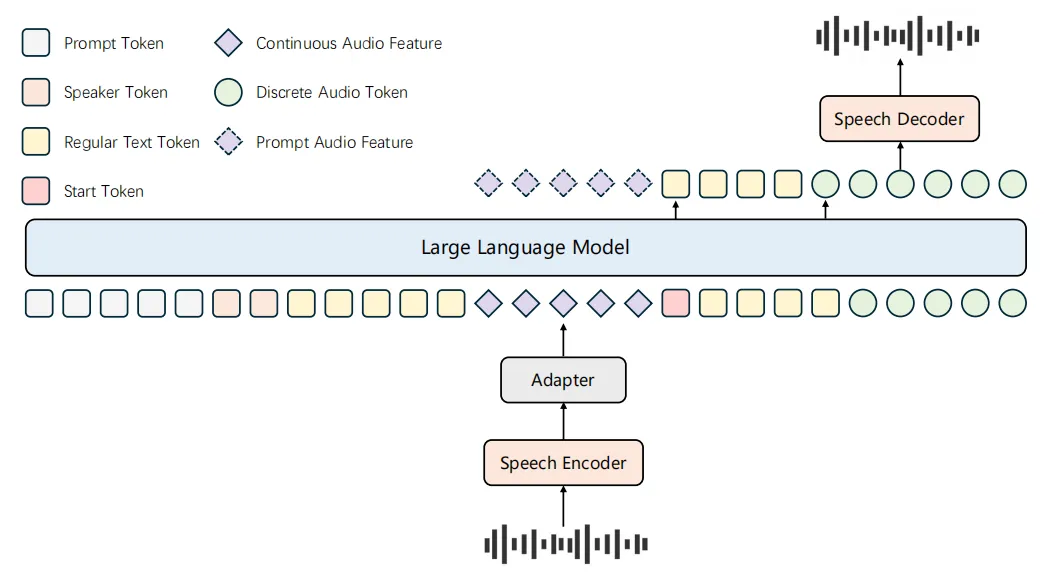
流式音频编码器:将原编码器改为块流式处理,支持实时接收用户音频流; 双流交织机制:用户流与模型流按 1:4 比例块交织,实现 “边听边说”; 专用控制令牌:引入 THINK(聆听状态)、SHIFT(切换说话)、BREAK(终止说话)令牌,精准控制交互状态。
训练策略:
预训练融入全双工任务:在 Stage 2 预训练中加入 5B 全双工令牌训练,让模型原生掌握复杂交互逻辑; 数据改造:将半双工对话数据转化为双声道格式,插入打断、插话等场景,强化模型对交互动态的适应。
核心能力:
流畅轮流对话(Turn-taking):识别用户说话结束时机,精准回应; 智能暂停处理(Pause Handling):区分用户短暂停顿与说话结束,不中断对话; 支持用户打断(Barge-in):用户中途插话时,模型及时停止说话并响应新指令; 主动插话回应(Backchanneling):在用户说话间隙给出 “嗯”“对” 等回应,增强交互自然度。
3.4 创新4:多阶段训练范式 —— 兼顾智能、自然与鲁棒
Covo-Audio 采用 “两阶段预训练 + 专项后训练” 的递进式训练流程,确保模型全方位能力均衡:
预训练阶段
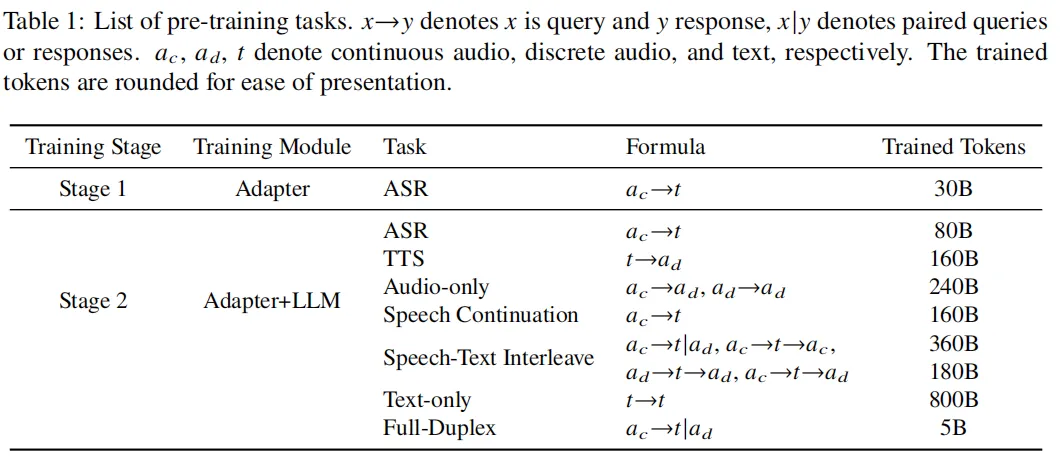
Stage 1:模态桥接预训练:
训练目标:建立音频编码器与 LLM 之间的语义关联,实现语音与文本模态的初步对齐; 训练配置:冻结音频编码器与 LLM 骨干,仅优化音频适配器;采用 20 万小时多语言 ASR 数据集进行训练;学习率采用余弦调度策略,峰值学习率 核心产出:模型具备基础的语音理解能力,能够将连续声学特征映射至 LLM 的语义空间。 Stage 2:模态融合预训练:
训练目标:实现语音与文本模态的深度融合,提升跨模态理解与生成能力; 训练配置:解冻音频适配器与 LLM backbone,联合优化;采用多任务训练目标,涵盖 ASR、TTS、纯音频建模、语音续写、语音 - 文本交织、纯文本建模及全双工交互任务;序列长度设为 8192,峰值学习率 数据规模:800 万小时多样化音频数据 + 3T 文本语料; 核心产出:模型形成统一的多模态表征空间,具备跨模态推理与生成的基础能力。
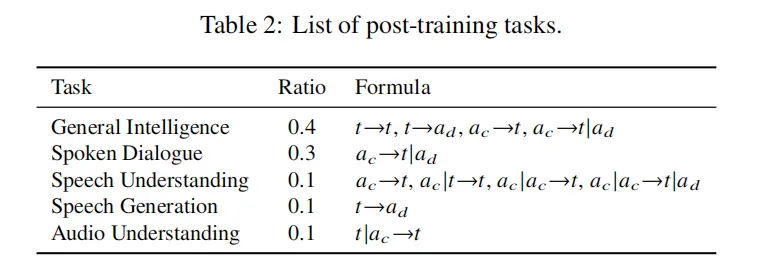
专项后训练
针对语音交互的实际需求,设计多维度后训练任务,进一步优化模型的对话能力、情感表达及多模态理解能力:
四、实验验证
论文通过构建全面的评估体系,在语音文本建模、口语对话、全双工交互、语音理解、音频理解等五大类任务中,对 Covo-Audio 的性能进行了系统验证,对比模型包括 Qwen2.5-Omni、Kimi-Audio、GPT-4o Audio 等主流音频语言模型及专用 ASR/TTS 模型。
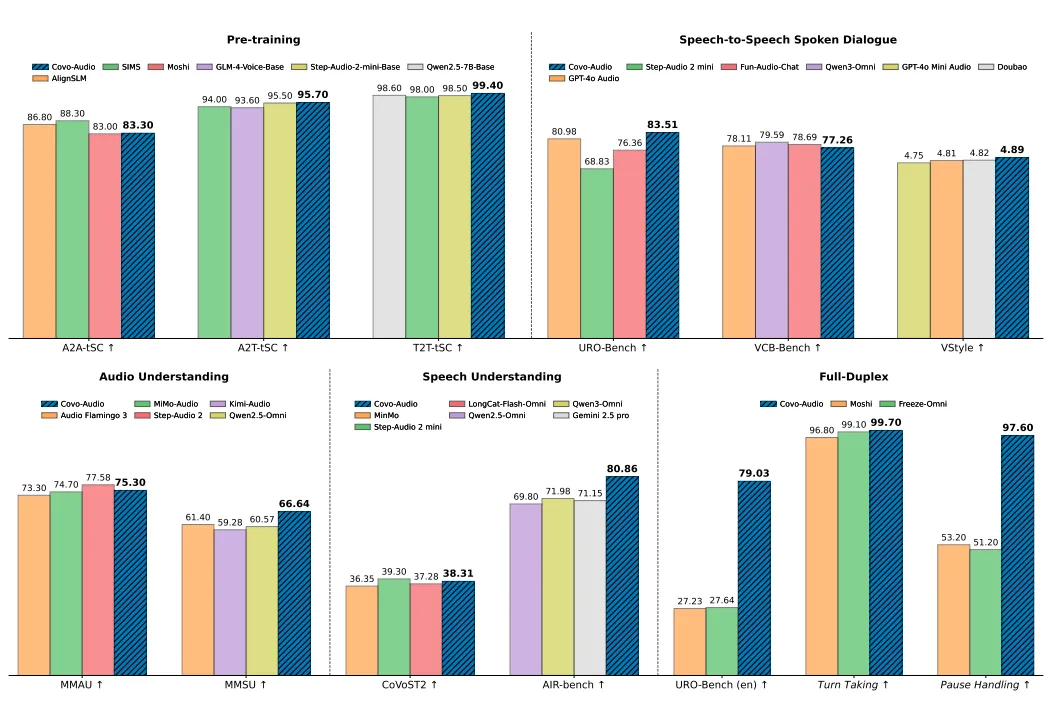
4.1 口语对话:URO-Bench/VCB Bench 双榜领先
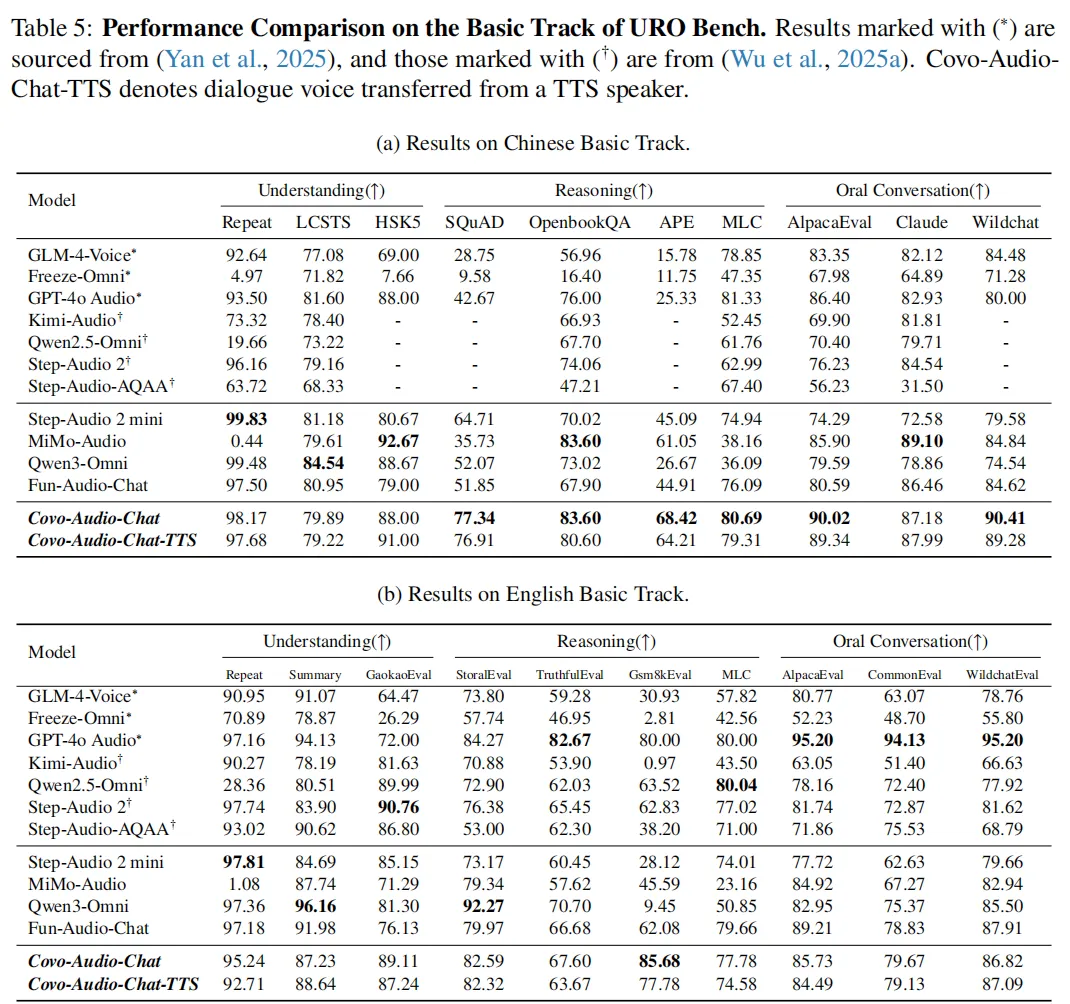
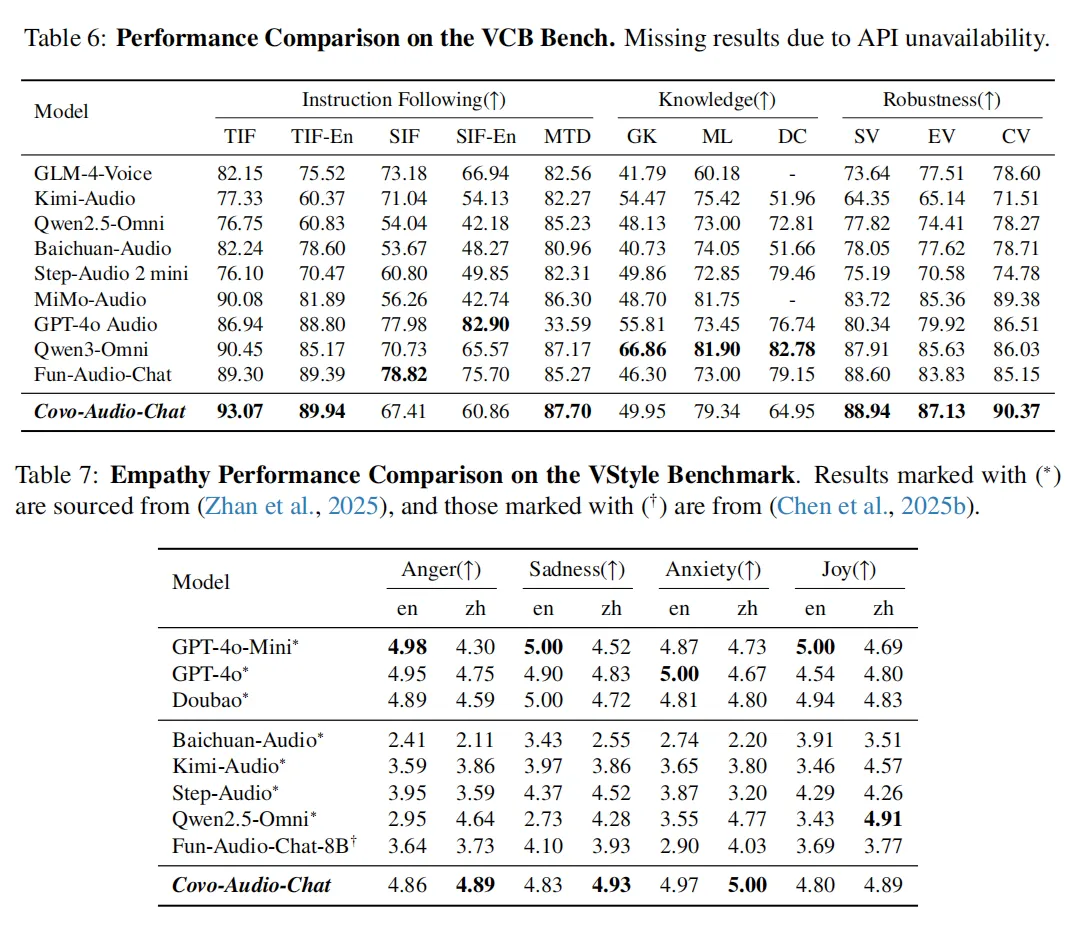
在核心口语对话任务中,Covo-Audio 以 7B 参数实现 “理解、推理、对话” 全维度领先:
URO-Bench(中文 / 英文基础赛道)
VCB Bench(语音交互综合评估)
4.2 全双工交互:碾压开源模型,接近人类体验
在全双工专属评估中,Covo-Audio-Chat-FD(全双工变体)表现惊艳:
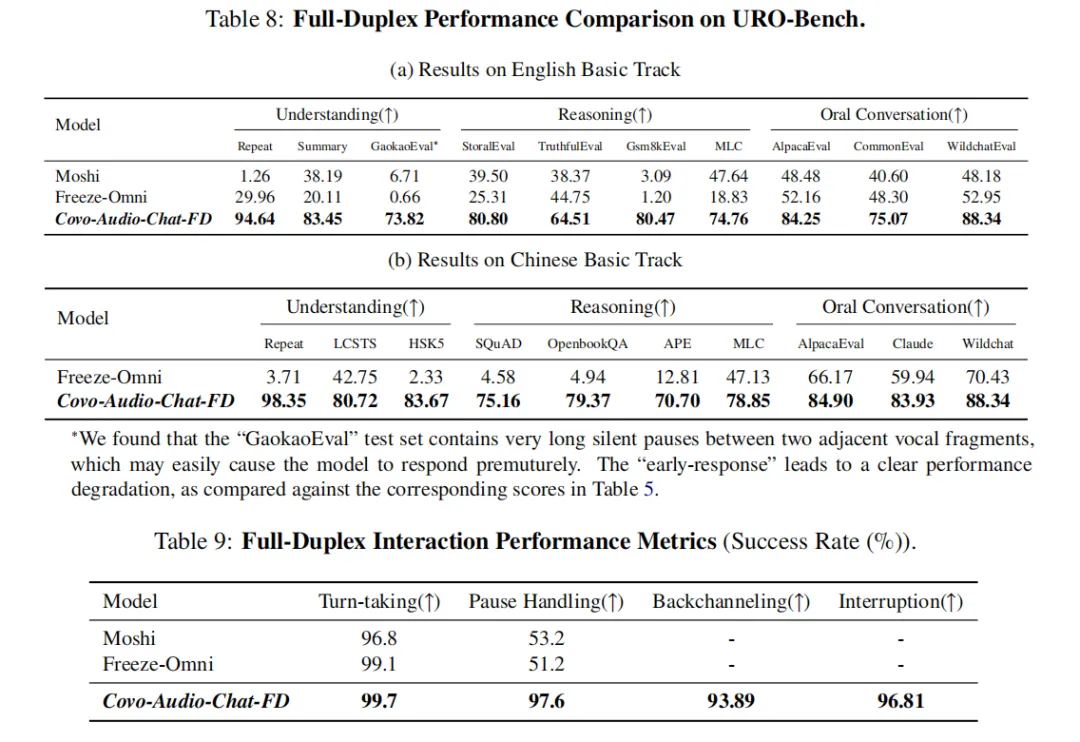
关键结论:全双工变体的对话能力仅比半双工版轻微下降,同时实现了工业级的交互鲁棒性,适配真实场景使用。
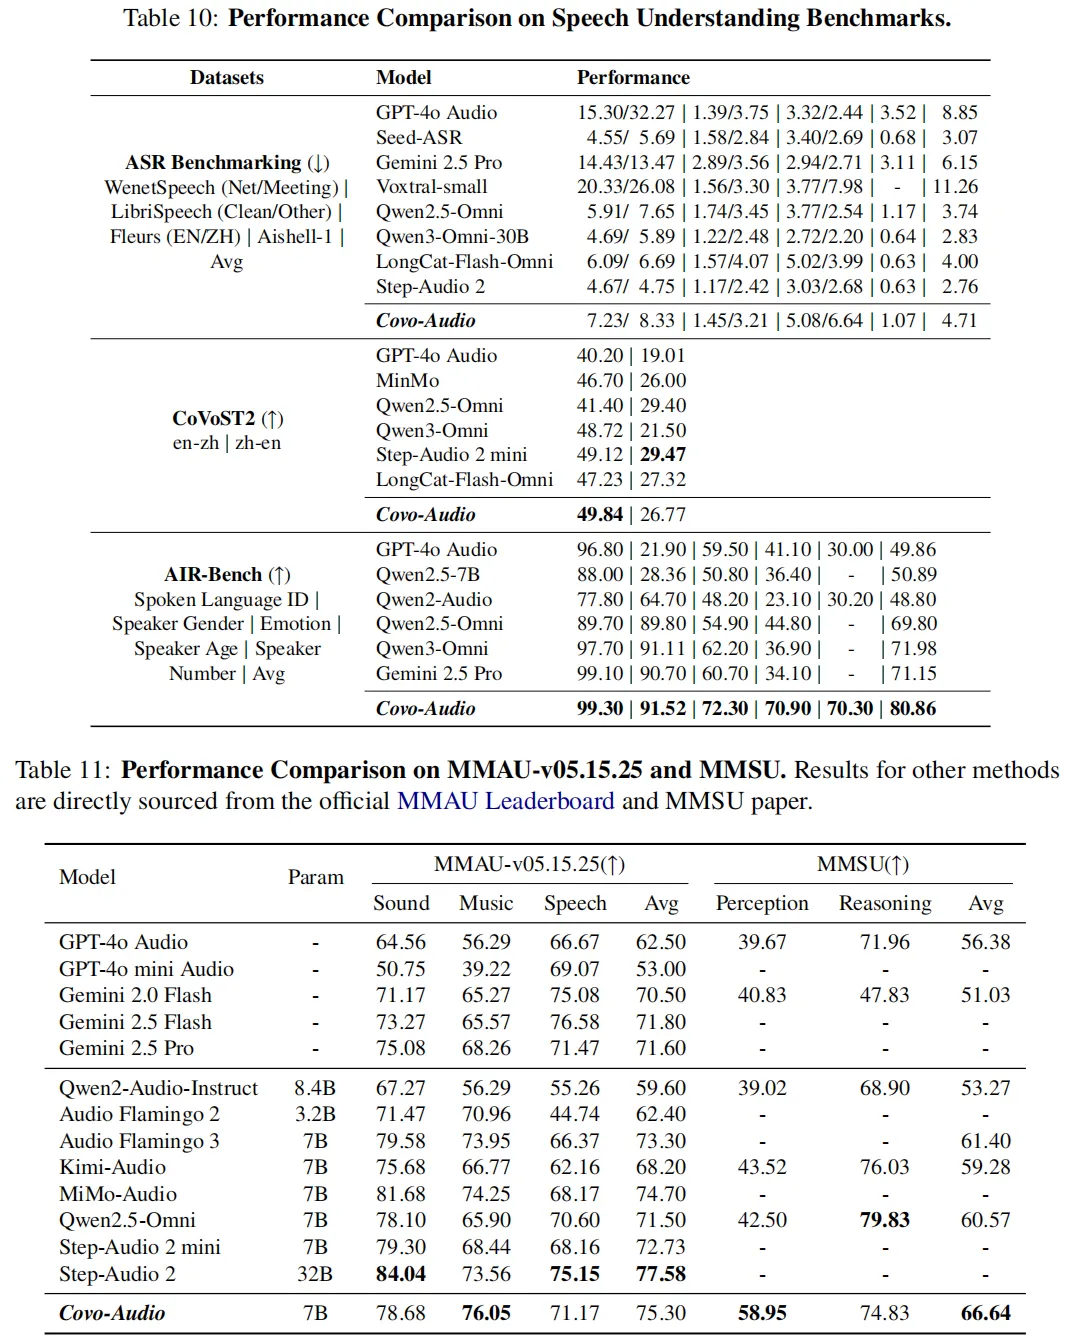
4.3 语音 / 音频理解:多任务全面开花
在语音识别、翻译、音频推理等任务中,Covo-Audio 展现出强大的通用能力:
4.4 情感共情:VStyle Benchmark 名列前茅
在情感交互评估中,Covo-Audio 的中文情感回应能力达到 SOTA 水平:
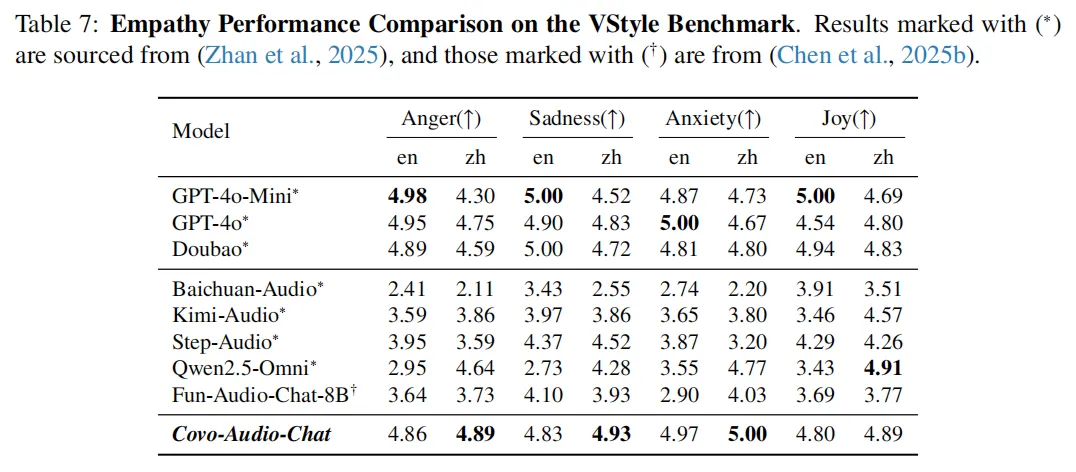
关键发现:模型不仅能识别文本中的情感词,还能捕捉语音中的语调、语速等声学特征,生成情绪适配的语音回应,共情自然度远超仅基于文本的模型。
4.5 智能说话人解耦验证:音色迁移无智能损耗
测试 Covo-Audio-Chat-TTS(TTS 音色迁移变体),结果显示:
对话性能:与原模型差异仅 1-2 个百分点(AlpacaEval=89.34% vs 原模型 90.02%); 音色自然度:与原生 TTS 音色一致性达 92%,无机械感; 核心结论:智能说话人解耦策略成功实现 “音色灵活切换 + 智能无损保留”。
五、研究价值
5.1 核心价值
范式革新:首次用 7B 参数实现端到端全栈语音交互,打破 “模块拼接” 的行业惯例,为轻量化、高自然度语音系统提供新范式; 技术突破:智能说话人解耦解决音色定制痛点,原生全双工提升交互自然度,层级三模态交织兼顾语义与韵律,三大创新直击行业核心需求; 性能均衡:在对话、理解、全双工、共情四大任务中全面领先,无明显短板,参数效率极高; 落地友好:模型轻量化(7B 参数),支持灵活音色定制,鲁棒性强,适配真实场景部署。
5.2 典型应用场景
智能语音助手:支持全双工对话、个性化音色,能听懂复杂指令、进行逻辑推理,交互体验接近人类; 虚拟人 / 主播:快速定制专属音色,无需重训对话模型,同时具备情感共情能力,直播、互动更自然; 智能客服:能处理用户打断、多轮追问,精准理解语音诉求,提升服务效率与用户满意度; 车载语音:低延迟全双工交互,适配驾驶场景的复杂沟通,如 “边导航边调整空调”; 教育 / 医疗:情感化语音回应,适配语言学习、心理疏导等场景,提升用户接受度。
六、总结
Covo-Audio 通过创新的架构设计、多阶段训练策略及专项技术优化,在 7B 参数规模下实现了端到端语音交互能力的全面突破,其核心贡献在于:构建了深度融合的多模态架构,提出了智声解耦与原生全双工等关键技术,验证了轻量化模型在复杂语音交互任务中的高性能潜力。该模型不仅在学术基准测试中表现优异,更具备明确的工业级落地价值,为语音交互技术的实用化发展提供了重要支撑。
未来研究可进一步探索:更大规模模型的性能提升空间、多语言与方言场景的适配能力优化、更细粒度的情感与韵律控制技术、以及与其他模态(视觉、文本)的跨模态融合深化等方向,推动语音交互技术向更自然、更智能、更通用的方向发展。随着 Covo-Audio-Chat 模型及推理流水线的开源,有望为音频语言模型领域的研究与应用带来新的发展机遇。
