
 语音小管家
通义实验室这次带来的是Mobile-Agent-v3.5以及最新的原生 GUI Agent 模型家族GUI-Owl-1.5:面向桌面 / 移动 / 浏览器等多端统一的基础模型与训练范式,并已全面开源。
模型链接:
GUI-Owl-1.5-2B-Instruct:https://modelscope.cn/models/iic/GUI-Owl-1.5-2B-Instruct
GUI-Owl-1.5-4B-Instruct:https://modelscope.cn/models/iic/GUI-Owl-1.5-4B-Instruct
GUI-Owl-1.5-8B-Instruct:https://modelscope.cn/models/iic/GUI-Owl-1.5-8B-Instruct
GUI-Owl-1.5-32B-Instruct:https://modelscope.cn/models/iic/GUI-Owl-1.5-32B-Instruct
GUI-Owl-1.5-8B-Think:https://modelscope.cn/models/iic/GUI-Owl-1.5-8B-Think
GUI-Owl-1.5-32B-Think:https://modelscope.cn/models/iic/GUI-Owl-1.5-32B-Think
项目地址:https://github.com/X-PLUG/MobileAgent
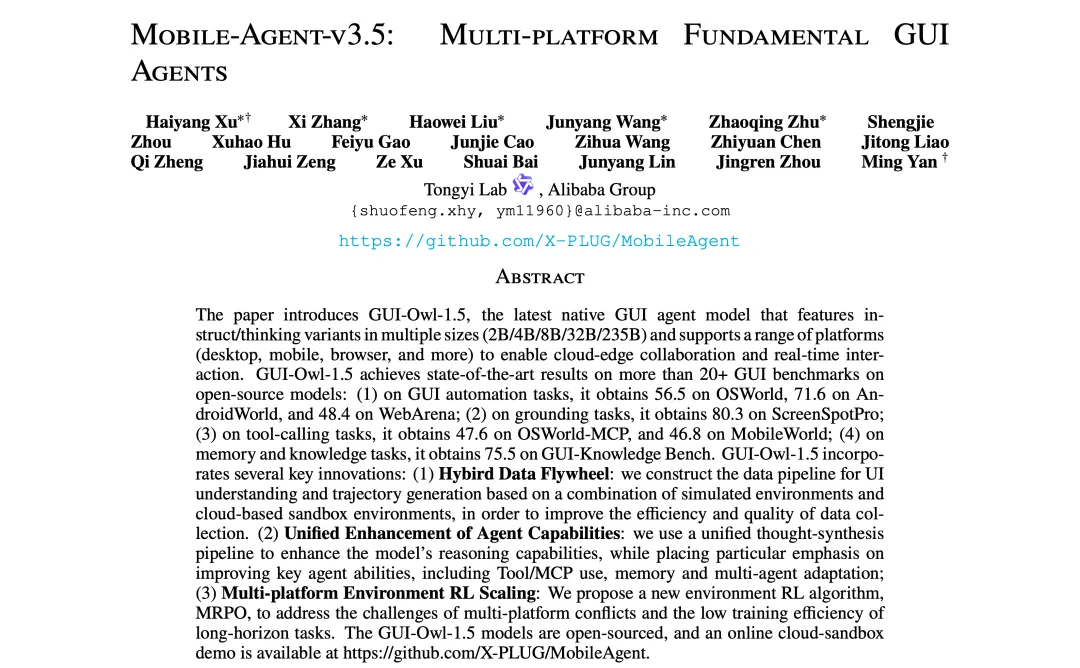
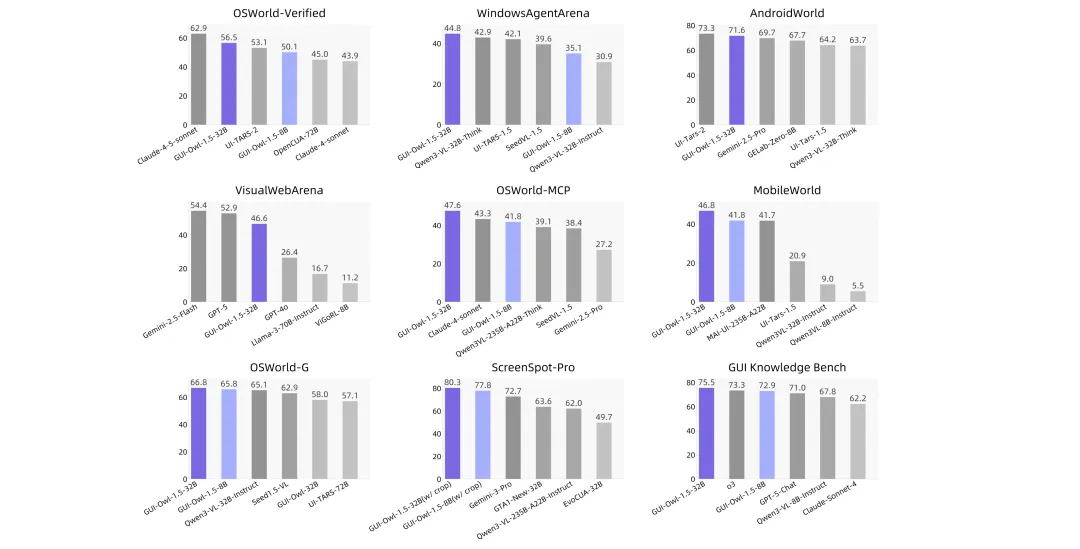
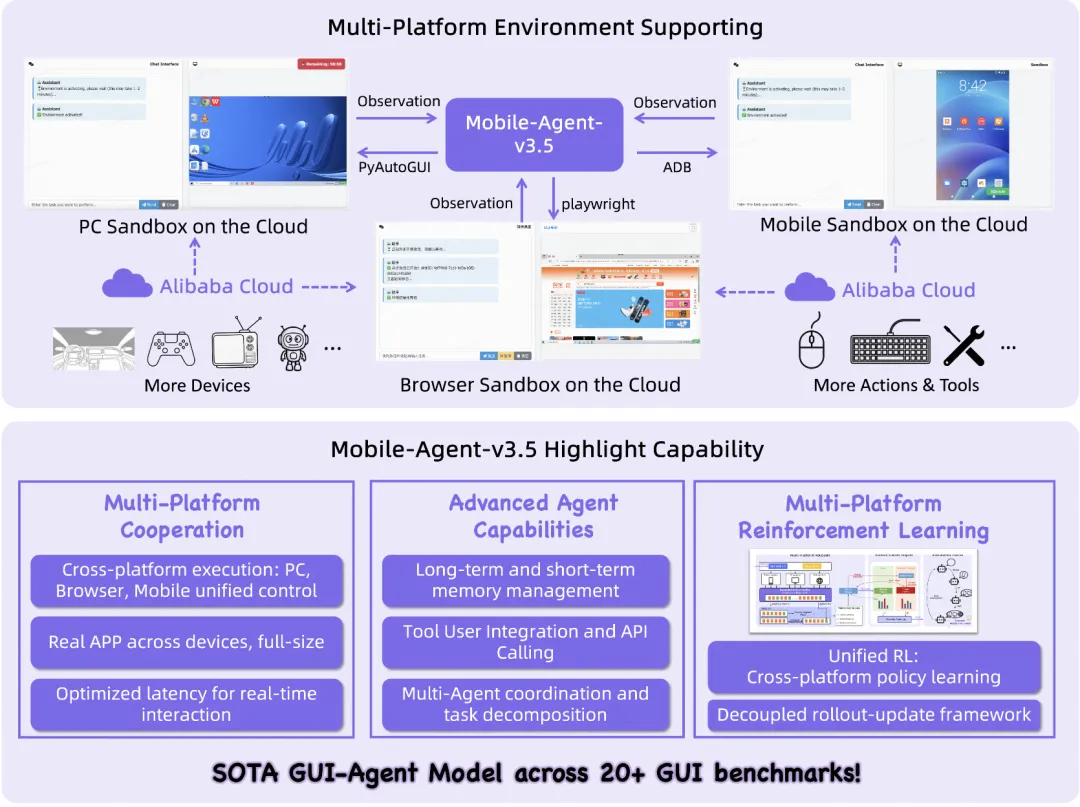
GUI-Owl-1.5 是一套基于 Qwen3-VL 训练的Native GUI Agent foundation model,覆盖2B/4B/8B/32B/235B多尺寸,并提供Instruct(不输出思考,轻量低延迟)与Thinking(更强规划反思)两种变体,支持边端部署 + 云端协同的真实使用形态。
为解决 GUI Agent 落地的三大卡点,研究团队引入三条关键技术主线:
Hybird Data Flywheel:
模拟环境 + 云端 sandbox 的混合数据飞轮,规模化生成高质量 grounding 与长程轨迹。
Unified Enhancement of Agent Capabilities:
统一的“思维合成”管线,系统强化 Tool/MCP、记忆、知识、多人协作等 agent 能力。
Multi-platform Environment RL Scaling(MRPO):
面向多平台冲突与长程低效的 RL 方法,保证训练稳定与跨端泛化。
关键能力 1:从“采数据”开始就做对—— Hybird Data Flywheel 混合数据飞轮
1、Grounding:不仅要“指得准”,还要覆盖“难场景”
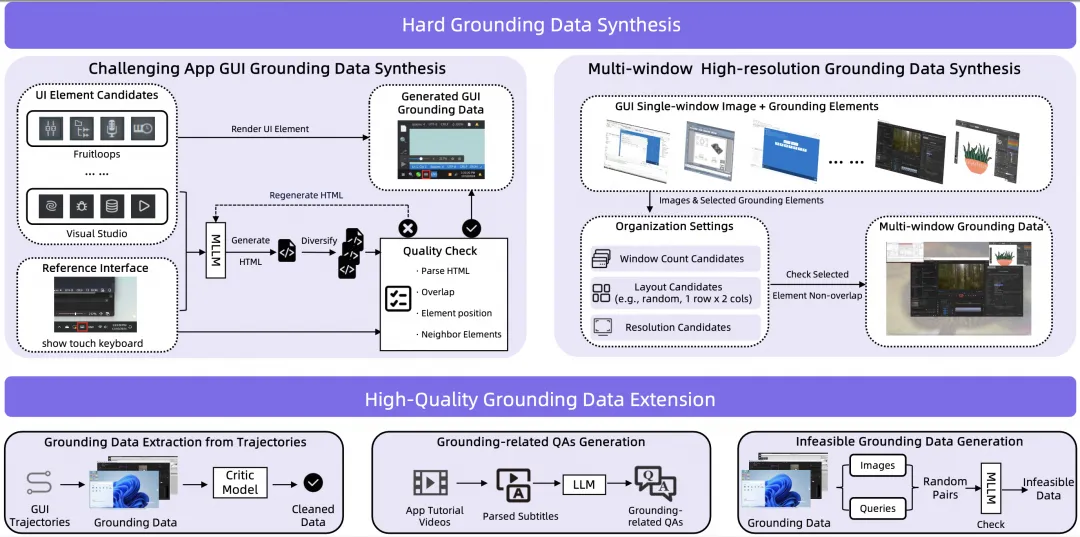
现有 GUI grounding 数据往往在分辨率、窗口复杂度、专业软件场景上明显不足。研究团队构建了一条完整的 grounding 增强流水线,核心分两类:
Hard Grounding Data Synthesis(高难合成)
专业/复杂 App GUI 合成:基于参考界面与元素标注,借助 MLLM 生成专业软件截图,并引入质量评估 + 迭代回炉机制确保可信度。
多窗口高分辨率合成:从单窗口数据出发,组合窗口数量/布局/分辨率候选池,生成复杂多窗口场景,并通过几何约束确保目标元素不被遮挡。
High-Quality Grounding Data Extension(可扩展增强)
轨迹挖掘 grounding:从 PC/移动仿真轨迹中抽取 grounding 对,并用 critic 过滤保真。
教程知识挖掘:解析 App 教程字幕,生成 grounding 相关 QA,覆盖真实使用语义。
不可行查询(infeasible)负样本生成:随机配对 query 与元素,再用多模型共识过滤,补齐“不存在该元素时如何判断”的关键能力。
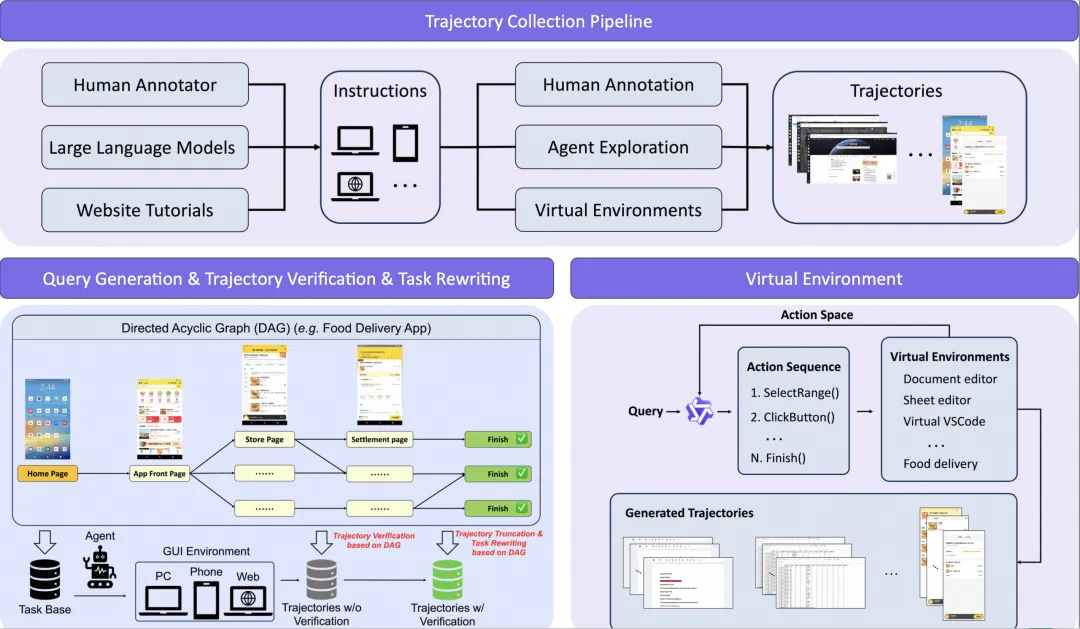
研究团队用DAG(有向无环图)组织应用内高频工作流,显式建模“可达子任务链”,并把数据生产分成四条腿:
DAG 任务合成:从起点集合 S 到终点集合 T 采样路径,组合子指令模板,降低 LLM 幻觉带来的分布漂移。
真实设备自动 rollout + checkpoint 验证:为每个 DAG 节点定义 predicate ϕk,做前缀完成度评估;失败则截断到最后验证点并“任务修复”(去掉已完成子任务),保证监督干净。
真实设备人工示范补洞:针对自动化仍无法覆盖的 hard cases,小量人工标注对齐真实 UI。
Web-rendering 虚拟环境:解决真实 App 中 CAPTCHA/反爬中断、反馈不精确导致的探索低效;并支持脚本/RPA 直接产出标准成功轨迹,低成本覆盖滚动、拖拽、文档/表格编辑等高频原子操作。
关键能力 2:让模型“像 Agent 一样思考”—— 统一 CoT 合成 + 知识注入 + 多 Agent 协作
GUI agent 的“可用”,从来不只看能不能点按钮,还看:
是否会计划长程步骤
是否能记住关键屏幕信息
是否能调用工具 / MCP完成 GUI 外操作
是否能在系统里扮演规划/执行/验证/记忆等角色
研究团队做了三件事把这些能力系统化打进模型:
1、GUI Knowledge Injection:从文档/论坛到可训练 QA
大规模爬取软件文档、教程、论坛与问答平台数据,清洗后用 LLM 重写为task-level QA或step-level VQA,让模型补足“软件功能与操作知识”的缺口。
2、World Modeling:训练“动作后界面会怎么变”
从轨迹中构造 action-conditioned 的状态转移描述:给定截图 + 动作,让模型学习预测下一屏变化(弹窗、焦点切换、字段变化等),形成对 GUI dynamics 的内化认知,减少盲点操作。
3、Unified CoT Synthesis:把观察、反思、记忆、工具选择写进每一步
对每个轨迹 step 合成结构化思维信息:
先用 VLM 做屏幕描述与关键信息抽取
再判定动作结果是否符合预期,生成反思与纠错信号
同步生成记忆条目(比如价格、天气、账号信息)
若涉及工具调用,把工具定义纳入推理,合成“为何选这个工具”的 reasoning
这一套让模型在长程任务里更稳、更会“复盘”,也更像真实 agent。
关键能力 3:多平台 RL 规模化训练—— MRPO 解决“冲突”和“训练不稳定”
多平台(mobile/desktop/web)统一训练最大的坑有两个:
不同平台 action space / UI 习惯差异巨大,直接混训容易梯度打架
长程任务用 GRPO 类 grouped rollout 时,经常出现“整组全成/全败”的 outcome collapse,训练信号直接废掉
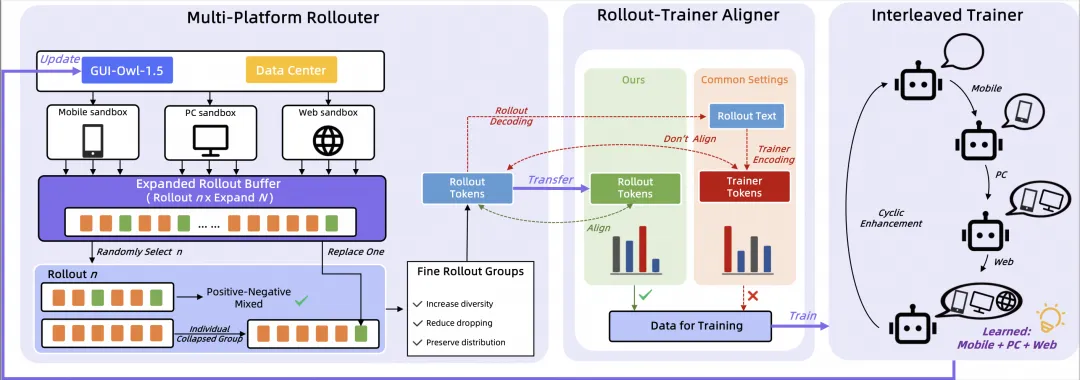
研究团队提出MRPO(Multi-platform Reinforcement Policy Optimization),核心设计包括:
统一 device-conditioned policy:一个策略 πθ(a | o, d) 同时覆盖多端。
在线 rollout buffer(oversample-then-subsample):对每个任务先 on-policy 采样 kn 条,再均匀抽 n 条组成训练组;若组内 outcome collapse 且池中存在正负样本,则用 Swap1 替换一条,显著提升有效组概率,同时保持 on-policy。
token-id transport 对齐训练与推理 logprob:环境侧推理返回的不仅是文本动作,还带上推理时使用的 token IDs,训练侧直接用 token IDs 计算 logprob,避免 tokenizer 差异导致 KL/PG 估计不一致。
交替多平台优化(interleaved / alternating):按平台轮转训练,降低跨端梯度冲突,稳定提升并保留泛化。
实验结果
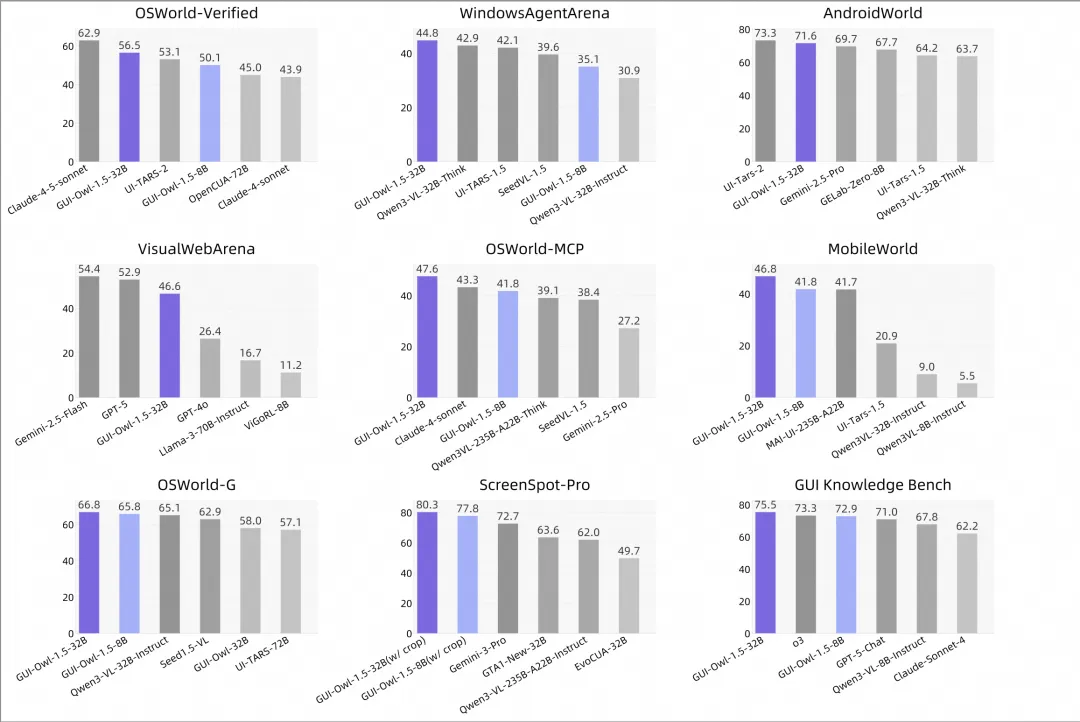
GUI-Owl-1.5 在 GUI 自动化、grounding、工具调用、记忆与知识等方向覆盖20+ GUI benchmarks,其中多项达到开源 SOTA或显著领先同量级模型。
端到端自动化(在线环境)
OSWorld-Verified:56.5(GUI-Owl-1.5-32B-Instruct)
AndroidWorld:71.6(GUI-Owl-1.5-8B-Thinking)
VisualWebArena:46.6(GUI-Owl-1.5-32B-Thinking)
WebArena:48.4(GUI-Owl-1.5-32B-Thinking)
工具 / MCP 调用(GUI + Tool 协同)
OSWorld-MCP:47.6(GUI-Owl-1.5-32B-Instruct)
MobileWorld:46.8(GUI-Owl-1.5-32B-Instruct)
Grounding(高分辨率/专业软件场景尤其强)
ScreenSpot-Pro:72.9(不使用 crop)
ScreenSpot-Pro:80.3(两阶段 crop refine)
记忆与知识
GUI Knowledge Bench:75.5(GUI-Owl-1.5-32B-Instruct)
MemGUI-Bench(Easy):27.1(GUI-Owl-1.5-32B,native 模型显著领先)
为边端与实时交互准备的 Instruct 系列
研究团队并没有把“强”只押在大参数上。GUI-Owl-1.5 提供2B/4B/8B的 Instruct 版本,定位非常明确:
不输出思考链→ 更低延迟、更适合边端部署
与云端 Thinking 大模型形成边-云协同、多 agent 组合:小模型高频执行,大模型复杂规划/反思/校验
不是所有任务都需要 32B,但每个场景都需要“可部署”。
开源内容与使用方式
目前已开源:
GUI-Owl-1.5 多尺寸模型(Instruct/Thinking)
Mobile-Agent-v3.5 多端 agent 框架
cloud sandbox demo(可在线体验端到端 GUI 操作)
结 语
GUI agent 的下一步不是“再做一个炫酷 demo”,而是:
数据可持续(flywheel)
多端可泛化(multi-platform)
训练可稳定扩展(MRPO)
端云可协作(instruct + thinking + multi-agent)
