
 语音小管家
以下文章来源于AI随想录,作者William
论文标题: GSRM: Generative Speech Reward Model for Speech RLHF
GPT-4o Voice Mode、Gemini Live 等语音大模型已经能流畅 “说话”,但合成语音的自然度始终差着人类 speech 的 “那味儿”,要么语调生硬像机器人,要么情感表达 “踩空”,要么节奏忽快忽慢。
问题的核心在于:没有一个靠谱的 “裁判” 来指导模型优化。传统语音评估工具要么只给一个冰冷的数字分数,说不清 “哪里不自然”;要么泛化能力差,换个场景就失灵,根本没法支撑语音大模型的 RLHF(基于人类反馈的强化学习)。
Meta 与 MIT 联合推出的 GSRM(Generative Speech Reward Model) ,终于解决了这个痛点。它不像传统工具那样 “一评了之”,而是像人类评委一样,先拆解语音的声学特征,再用 “思维链(CoT)” 推理出打分依据,不仅能给语音打分,还能说清 “为什么打这个分”。
更绝的是,它还能直接作为语音大模型的 RLHF 奖励信号,经实测,用 GSRM 优化后的语音模型,自然度在人类 A/B 测试中赢率高达 82%,彻底拉开与基线模型的差距。
今天,我们就从核心概念入手,一步步拆解 GSRM 的设计巧思、技术细节和实测效果,看看这个 “会推理的语音裁判” 是如何让 AI 语音更像人类的。
一、基础概念
在深入技术细节前,先扫清关键概念障碍,这是理解 GSRM 创新点的基础
1.1 语音自然度(Speech Naturalness):不只是 “听得懂”,更要 “像人说”
语音自然度是多维度的综合指标,不是单一维度的 “清晰” 或 “流畅”,论文明确其核心包含 7 个细分维度,这也是 GSRM 的评估核心:
1.2 生成式奖励模型(GRM):不止打分,更会 “说理”
与传统 “输入语音→输出分数” 的判别式模型不同,生成式奖励模型(GRM)的核心是 “先推理,后打分”:
输出不仅包含数值评分,还附带完整的推理过程(如 “因为语音中元音 /ɪ/ 的音调变化过大,导致语调不稳定,所以自然度评分较低”); 推理过程完全可解释,能精准定位语音的问题所在,为模型优化提供明确方向;
GSRM 是专为语音设计的 GRM,也是首个用于全双工语音大模型在线 RLHF 的生成式奖励模型。
1.3 语音 RLHF:让语音模型 “自主优化” 的关键
RLHF 是提升模型对齐人类偏好的核心技术,但语音领域的 RLHF 面临特殊挑战:
语音是高维连续信号,无法像文本那样简单对比; 评估需兼顾声学质量(语调、节奏)和语义质量(语境贴合、表达恰当); 传统奖励信号要么不可靠,要么缺乏解释性。
GSRM 的出现填补了这一空白,为语音 RLHF 提供了 “可靠、可解释、多维度” 的奖励信号,让语音模型能自主迭代优化。
二、核心痛点
论文通过试点研究(Pilot Studies),一针见血地指出了传统语音评估方法的 3 大致命问题,而这些正是 GSRM 的破局点:
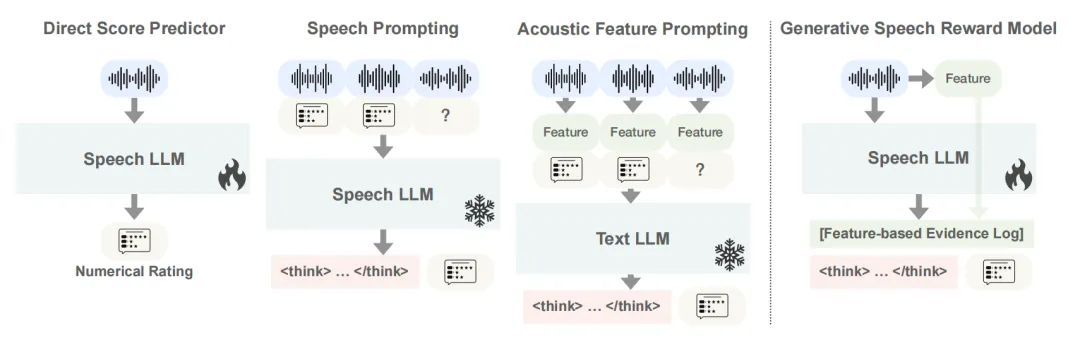
2.1 问题1:直接评分模型(DirectScore Predictor)—— “只给分,不讲理”
这类模型(如微调后的语音 LLM)直接输出评分,没有任何中间推理过程:
问题:无法定位 “为什么不自然”,模型优化如同 “盲人摸象”; 实测表现:在 ConvTTS 测试集上,与人类评分的皮尔逊相关系数仅 0.215,远低于人类评分一致性(0.533)。
2.2 问题2:语音模型提示(Speech Prompting)—— “听不懂细粒度声学线索”
直接用 Gemini-2.5-Pro 等前沿语音模型做零样本 / 少样本评估:
问题:语音模型难以从原始音频中提取细粒度声学特征(如元音的音调变化、节奏的细微差异); 实测表现:在 ConvTTS 测试集上,与人类评分的相关系数为 - 0.050(几乎无相关性),完全无法可靠评估。
2.3 问题3:声学特征提示(Acoustic Feature Prompting)—— “有线索,不会用”
提取声学特征后提示文本 LLM 评估:
问题:文本 LLM 能利用声学特征,但缺乏对语音自然度的专业判断逻辑; 实测表现:相关系数仅 0.133,虽优于直接语音提示,但仍远未达到实用标准。
2.4 GSRM 的破局思路
针对以上问题,GSRM 提出 “声学特征提取 + 特征驱动的 CoT 推理” 两步法:
先从原始音频中提取可解释的细粒度声学特征(如元音的音调、强度、时长),解决 “提取不到关键线索” 的问题; 再基于这些特征生成 CoT 推理,将特征与自然度评分关联起来,解决 “不会说理、无法定位问题” 的情况。
三、技术细节
GSRM 的架构看似复杂,实则可拆解为 “特征提取→推理生成→模型训练→RLHF 应用” 四个核心环节,每个环节都藏着可落地的巧思:
3.1 环节 1:声学特征提取 —— 聚焦元音,抓准核心线索
论文发现,元音是承载语音韵律信息(语调、节奏、表达强度)的核心单元,因此 GSRM 采用 “元音级特征提取” 策略,而非传统的帧级或 utterance 级提取:
具体流程:
预处理:将音频重采样至 24kHz,保留系统响应通道,用 Silero 语音活动检测器去除超长静音,保留自然停顿; 音素对齐:通过神经对齐模型,将语音与转录文本进行音素级强制对齐,精准定位每个音素的时间边界; 元音筛选:从对齐结果中筛选出元音片段(含单元音和双元音),忽略辅音(辅音对韵律信息贡献较小); 特征提取:对每个元音片段,提取 6 类核心声学特征,并离散化为 “极低、低、中、高、极高” 等可解释类别:
特征日志生成:将所有元音的特征按 utterance 整理,形成结构化的 “元音级声学特征日志”,作为后续推理的核心依据。
要点总结:
3.2 环节 2:推理生成 —— 两步法合成 CoT,让评分 “有理有据”
GSRM 的推理生成分为 “utterance 级证据日志合成” 和 “全局判断 CoT 合成” 两步,最终形成完整的推理 - 评分链条:
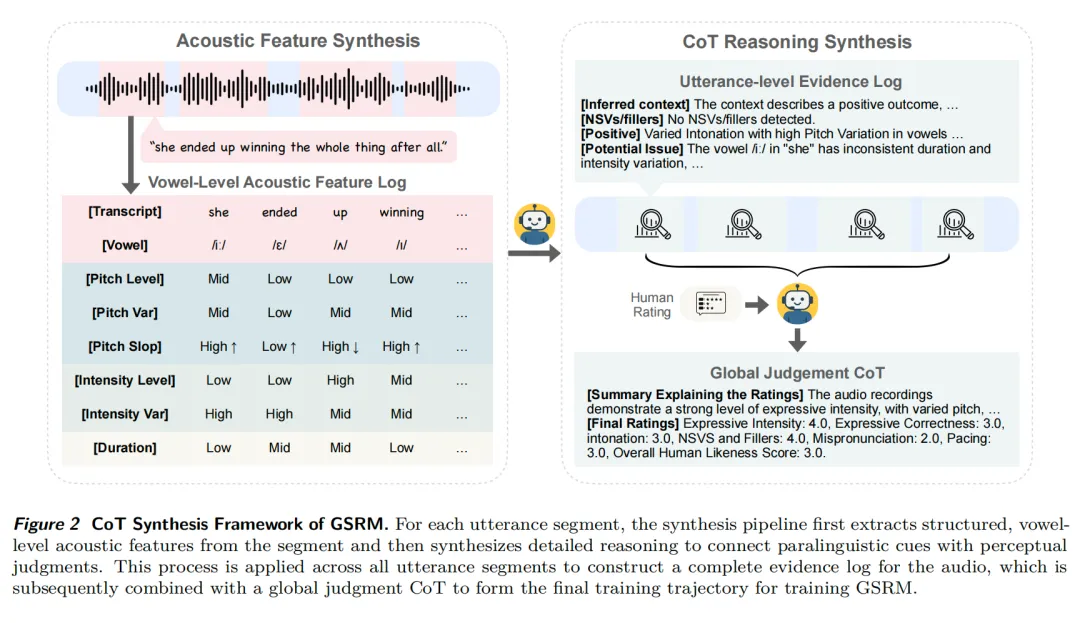
步骤 1:utterance 级证据日志合成
对每个 utterance(句子),基于其声学特征日志和转录文本,用 GPT-4o 生成结构化分析,包含 4 个维度:
步骤 2:全局判断 CoT 合成
将所有 utterance 的证据日志汇总,结合人类标注的真实评分,用 GPT-4o 生成全局推理和最终评分:
推理过程需明确关联声学特征与 7 个自然度细分维度(如 “因多个元音的音调变化过大,导致语调维度评分较低”); 评分需严格匹配人类标注,同时推理过程需显得 “自主推导”,不暴露已知标注; 最终输出格式为:证据日志 → 推理总结 → 各维度评分 + 整体类人性评分。
推理示例(强度水平): 音频在 “oh, that’s so sweet” 中,元音 /o/ 和 /iː/ 音调变化高、斜率清晰,表达强度充足;但 “think” 中元音 /ɪ/ 音调极高,导致表达不稳定。综合来看,表达强度评 3.0 分。
要点总结:
推理全程 “特征接地”:所有判断都必须基于提取的声学特征,不做无依据猜测; 结构高度结构化:从局部(utterance)到全局(整个对话),推理逻辑清晰可追溯; 兼顾声学与语义:后续扩展后,还能融入语义质量评估(语言复杂度、语境贴合度等)。
3.3 环节 3:模型训练 —— 从合成数据到实用模型
GSRM 的训练基于 “合成 CoT 数据 + 监督微调”,具体流程如下:
数据准备:使用 ConvTTS 数据集(6579 个对话样本,含 62.8 小时音频)和 FDX-Conv 数据集(490 个全双工对话样本,作为域外测试集); CoT 数据合成:对每个样本,按上述 “特征提取→推理生成” 流程,用 GPT-4o 合成完整的 “语音→证据日志→CoT 推理→评分” 数据; 模型选择与微调:选用 Qwen2.5-Omni-7B 作为基础模型(因其强语音理解能力和高效推理特性),进行全参数微调; 学习率:2×10⁻⁵,采用余弦学习率调度器; 批次大小:32,最大序列长度:4096; 训练轮数:10 轮,选择验证损失最低的 checkpoint; 推理优化:采用测试时缩放(Test-time Scaling),对每个语音样本进行 16 次随机推理,平均后得到最终评分,减少预测方差。
3.4 语音 RLHF 应用 —— 让模型自主优化
GSRM 不仅能评估,更能作为奖励信号驱动语音模型迭代,具体流程如下:
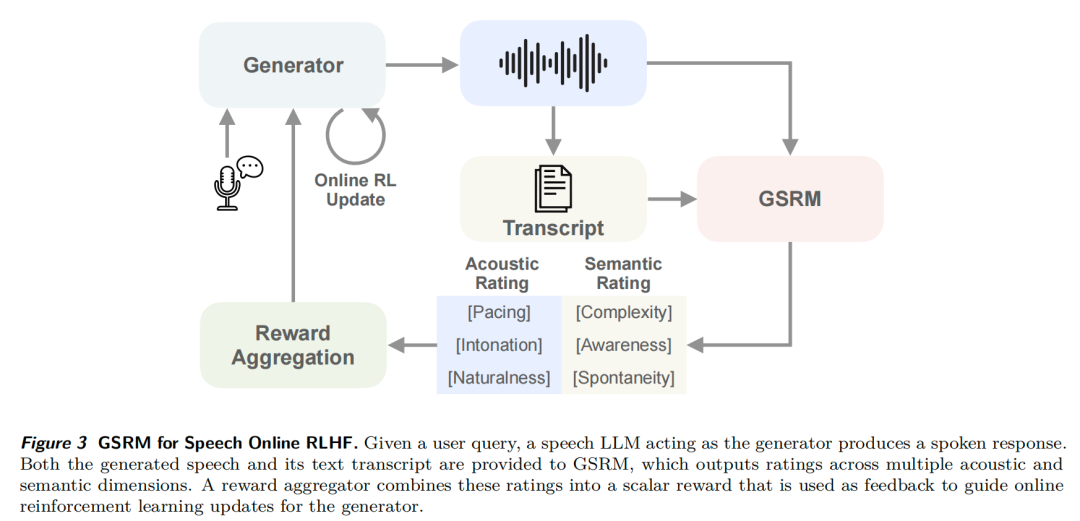
生成语音:全双工语音大模型(Generator)接收用户查询,生成语音响应; 双维度评估:GSRM 同时接收生成的语音(评估声学质量)和对应的转录文本(评估语义质量),输出多维度评分; 奖励聚合:将各维度评分(声学 6 个维度 + 语义 3 个维度)均匀加权,得到 scalar 奖励信号; 模型更新:用 GRPO(组相对策略优化)算法,以该奖励信号更新生成模型,迭代提升自然度。
语义质量评估扩展:
为兼顾语义层面的自然度,GSRM 还扩展了 3 个语义评估维度,仅需文本转录即可完成:
四、实验验证
论文通过多组实验,从 “评估准确性”“缩放特性”“消融实验”“RLHF 效果” 四个维度验证了 GSRM 的性能:
4.1 核心指标
在关键评估指标(皮尔逊相关系数 PCC、斯皮尔曼相关系数 SCC、均方误差 MSE)上,GSRM 大幅超越所有基线方法:
关键结论:GSRM 在域外集上的 PCC 达 0.465,已逼近人类评分一致性(0.532),远超传统方法(最高仅 0.236);这意味着 GSRM 的评估结果几乎可媲美人类评委,且能批量自动化完成。
4.2 缩放特性:数据越多,推理越多,效果越好
论文分析了 GSRM 在 “训练数据规模” 和 “测试时推理次数” 上的缩放特性:
训练数据规模:从 500 样本到 4579 样本,域外集 PCC 稳步提升,说明更多高质量标注数据能进一步提升性能; 测试时推理次数:从 1 次到 16 次,PCC 从 0.35 左右提升至 0.465,且前 4 次提升最显著,之后趋于平稳,证明测试时缩放能有效降低方差,且性价比极高。
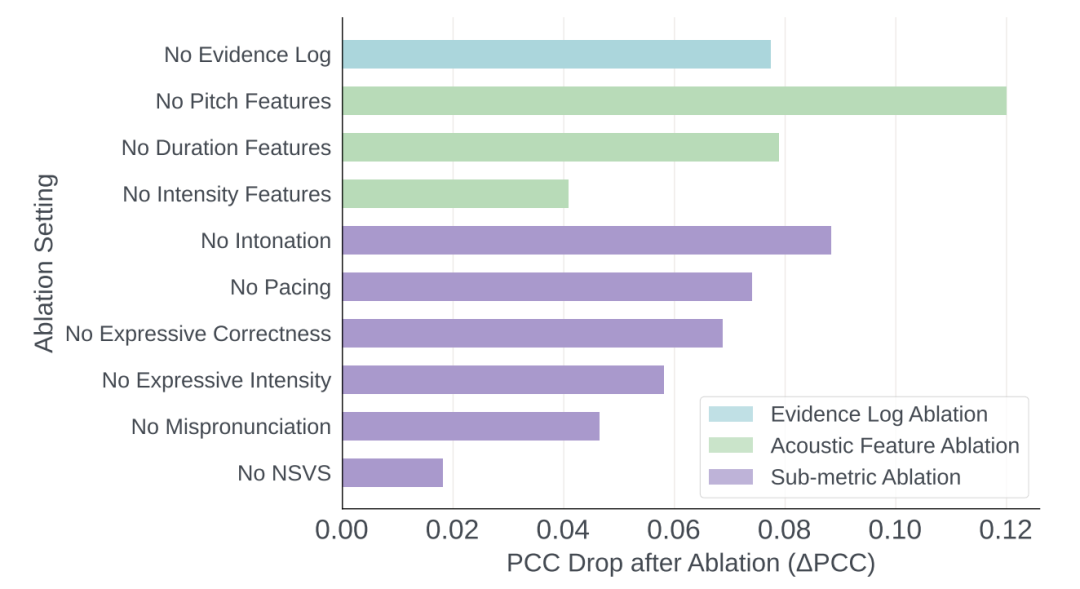
4.3 消融实验:哪些部分是核心?
通过消融实验,论文验证了各组件的必要性:
4.4 RLHF 实测:自然度赢率 82%
关键结论:RLHF 优化后的模型在整体自然度上以 82% 的赢率大幅超越基线,且在所有细分维度上均表现更优,证明 GSRM 是高效的 RLHF 奖励信号。
五、研究价值与未来展望
5.1 核心价值
技术层面:首次提出 “声学特征接地 + CoT 推理” 的语音生成式奖励模型,解决了传统评估 “不可解释、泛化差” 的痛点,为语音 RLHF 提供了可靠工具; 应用层面:大幅降低语音模型自然度优化的成本,无需大量人工标注,自动化完成评估与迭代,且效果已逼近人类水平; 生态层面:支持全双工语音大模型的在线 RLHF,填补了语音领域自主优化的技术空白,推动语音大模型从 “能说话” 向 “会说话” 迈进。
5.2 未来展望
多属性扩展:除自然度外,可扩展至情感表达一致性、说话人相似度等其他语音属性评估; 模型轻量化:当前基于 7B 模型,未来可通过量化、蒸馏等技术,适配边缘设备部署; 联合进化:探索 GSRM 与生成模型的联合 RL 框架,让评估模型和生成模型相互促进、共同迭代; 多语言支持:当前聚焦英语,未来可扩展至多语言场景,尤其关注低资源语言的评估适配。
六、总结
GSRM 的核心创新,在于把语音评估从 “黑盒打分” 变成了 “白盒推理”—— 它不再是简单的数值输出,而是能像人类评委一样,精准指出 “元音音调变化过大导致语调不自然”“节奏不均匀影响类人性” 等具体问题,为模型优化提供明确方向。
更重要的是,它打通了 “评估→优化” 的闭环,让语音大模型能自主迭代提升自然度,实测 82% 的人类偏好赢率证明了其有效性。对于语音技术开发者来说,GSRM 不仅是一个评估工具,更是一套可直接落地的语音 RLHF 解决方案;对于普通用户来说,这意味着未来的 AI 语音交互将更自然、更拟人,不再有 “机器人说话” 的违和感。
随着 GSRM 的普及,语音大模型的自然度优化将进入 “自动化、高精度” 时代,而这仅仅是语音生成技术的一个缩影,AI 语音不仅能 “说得像人”,更能 “说得懂人、说得贴心”。
