
 语音小管家
语音合成(TTS)领域长期存在一个矛盾:机器判断的“自然”与人类主观感受脱节。
这样的场景常常出现:你让AI生成一段语音,客观指标显示“完美”(如WER=0、FAD极低),但听起来却像机器人在背书。
如何让机器get到人类觉得“自然”的点?现有方案普遍陷入困境:
客观指标失效
预测模型拉垮
人类反馈缺失
「解决方案」
核心技术一:SpeechJudge-Data——大规模人类反馈数据集
高质量的标注数据是训练模型理解“自然度”的前提,SpeechJudge-Data通过系统性设计解决了数据规模与质量问题。
1.数据集构建策略
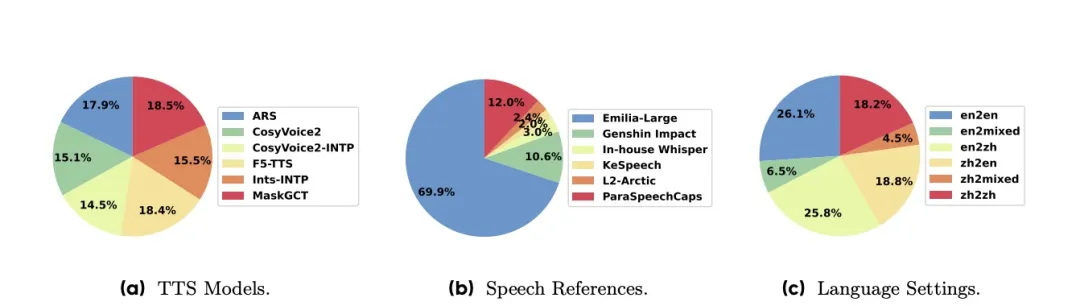
规模&覆盖度:包含99,000组语音对比样本(每组含2条语音及对应文本),覆盖全面:
TTS模型:覆盖3种架构的6个主流零样本模型(AR类的CosyVoice2、FM类的F5-TTS、MGM类的MaskGCT等),确保语音多样性;
风格:风格上涵盖常规语音(Emilia-Large数据集)、情感语音(ParaSpeechCaps情感库、原神角色语音)、带口音语音(L2-Arctic)及中英混码场景,确保风格多样性;
场景:场景上覆盖单语(如中-中、英-英)与跨语言(如中-英、英-混码)转换任务,模型、语音来源及语言分布均衡,确保场景多样性(图2)。
语音对来源:分“模型内对比”(同一TTS生成俩语音)和“模型间对比”(不同TTS生成),避免数据单调。
2. 标准化人类标注流程
标注团队:69名标注员(中文母语者、英语CET-6水平)经严格培训后上岗,历时2个月完成标注,累计投入约50万元人民币;
双维度标注任务:
数据质量筛选:
从99K原始数据中过滤“可懂度差异过大”样本(WER差距>12%,避免可懂度干扰自然度判断),得到44K高质量(hq)子集,进一步划分为42K训练集与1K验证集。
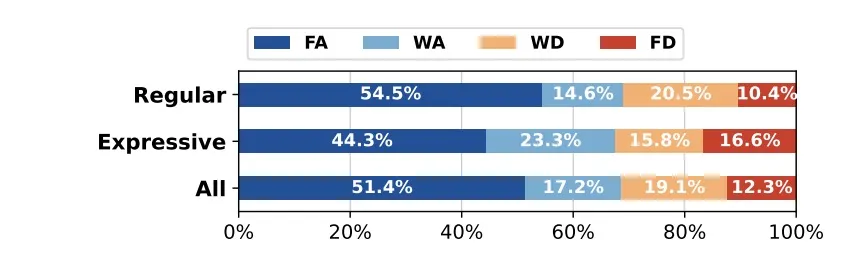
3. 标注一致性分析
核心技术二:SpeechJudge-Eval——自然度判断基准
1. 基准任务定义
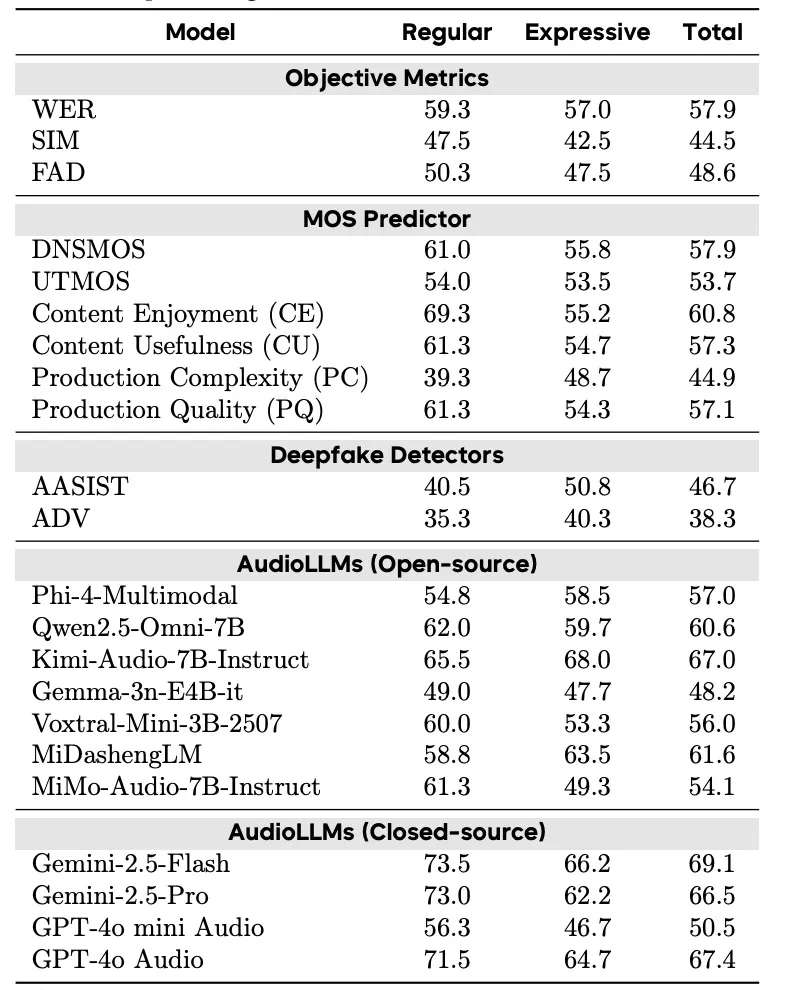
给定目标文本及两条语音样本(a1、a2),模型需判断“哪条语音更自然”,本质为二分类任务,以人类标注为金标准,通过准确率评估模型性能。
2. 基准数据集来源
3. 现有模型测试表现
核心技术三:SpeechJudge-GRM——生成式奖励模型
1. GRM创新点
2. 两阶段训练流程
SFT阶段(冷启动):
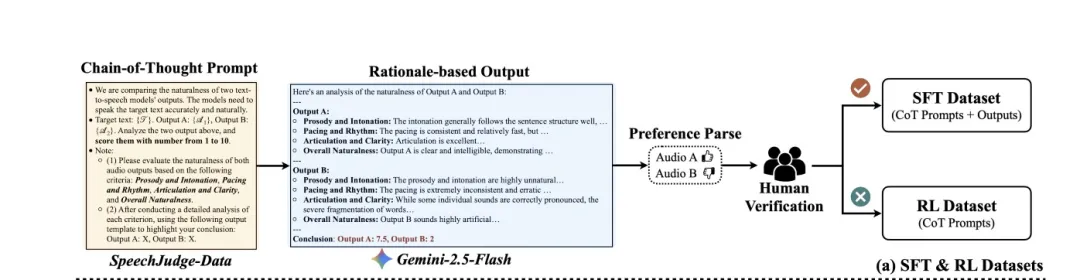
针对Qwen2.5-Omni-7B指令跟随能力不足的问题,利用Gemini-2.5-Flash对25K“人类与Gemini判断一致”样本生成CoT推理文本(如韵律、清晰度分析),微调模型以提升理解与推理能力。
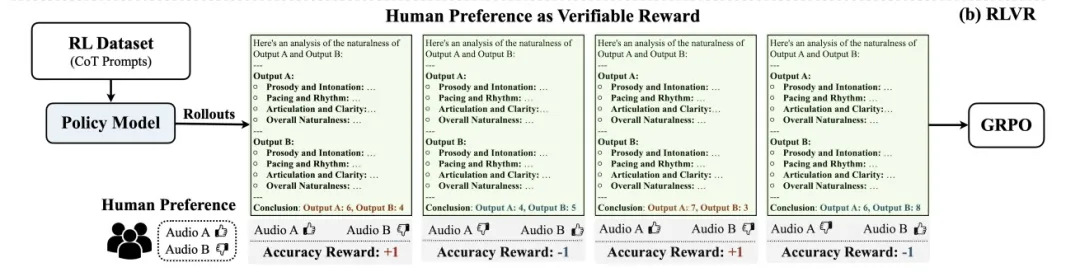
RL阶段(难样本优化):
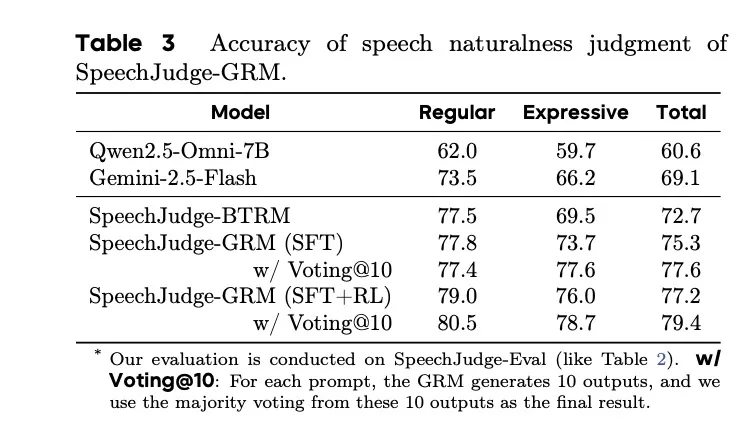
3. GRM表现绝对领先
「应用验证:TTS后训练优化」
两个实验测试GRM实际应用能力,结果遥遥领先:
1. 高质量语音筛选
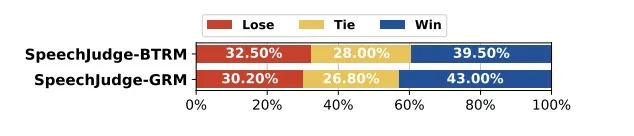
场景:让Qwen2.5-Omni-7B生成100个语音样本,对比GRM与传统模型(BTRM)选择“最自然样本”的能力。
结论:GRM选中样本“优于随机样本”的比例显著高于BTRM,证明其符合人类偏好。
2. TTS模型后训练优化
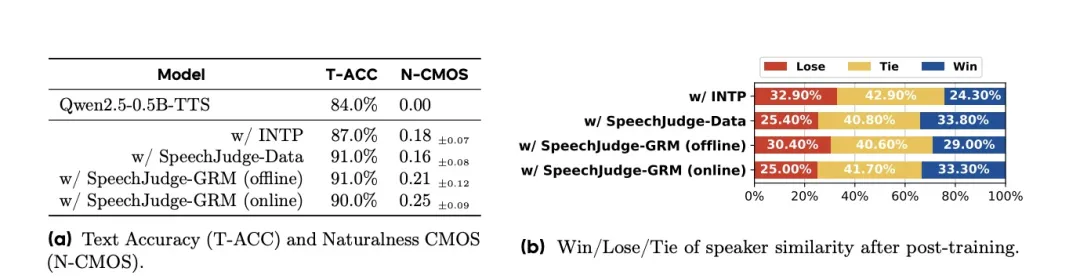
「结论与展望」
总结
构建99K大规模人类反馈数据集,填补行业空白; 提出SpeechJudge-Eval基准,揭示现有方法缺陷; 创新GRM模型,实现79.4%的自然度判断准确率,可直接用于TTS模型优化。
未来方向
扩展评估维度(如说话人相似度、情感表达准确性);
开发多目标奖励模型,同步优化自然度、可懂度与相似度。
