
 语音小管家
大年三十,当全国人民都在忙着包饺子、看春晚、抢红包的时候,阿里通义实验室却悄无声息地在 GitHub 上丢下了一枚“核弹”。
没有预热,没有发布会,Qwen3.5就这样在除夕夜正式发布了。
当我们还在讨论 DeepSeek 的性价比、GPT-5 的难产时,Qwen3.5直接甩出了一张颠覆认知的成绩单:
它开源了 Qwen3.5-397B-A17B 模型,以仅仅 170 亿(17B)的激活参数,在性能上硬刚甚至反超了自家万亿参数的 Qwen3-Max,以及 Gemini-3-Pro、GPT-5.2 等顶级闭源模型。
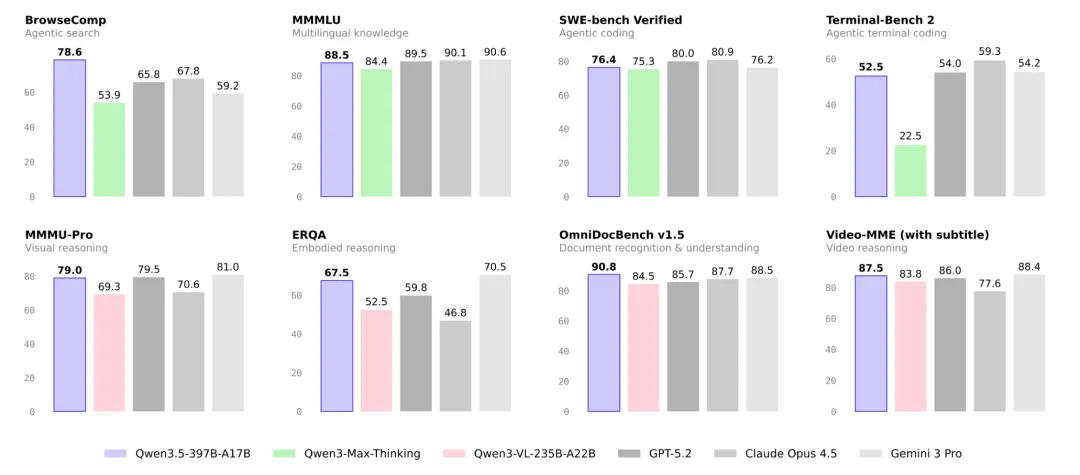
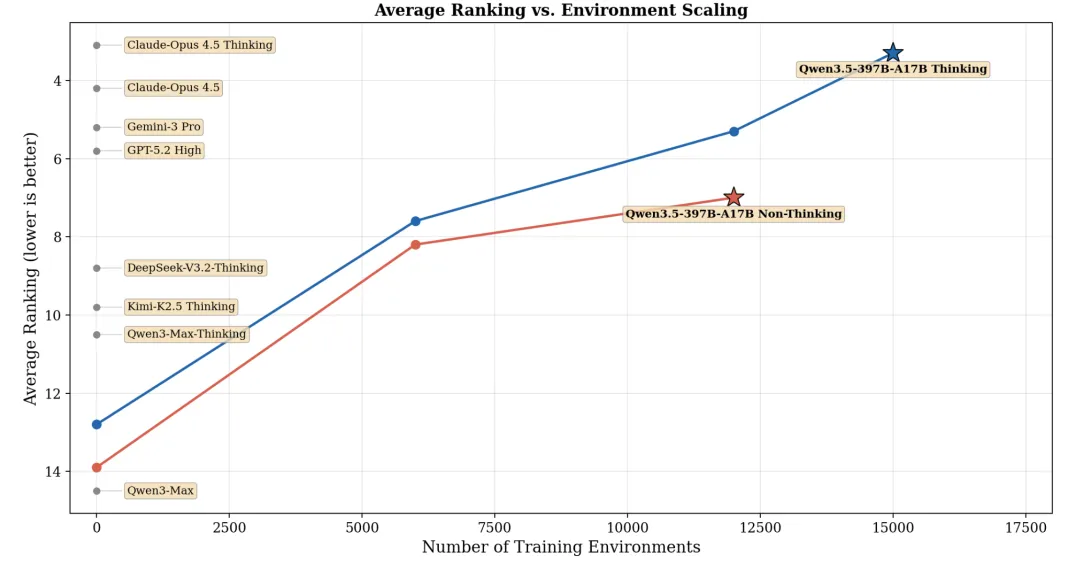
直接登顶最强开源模型宝座。Qwen3.5-Plus为该模型的 API 版本,现在可以直接在阿里云百炼调用。
今天,咱们就先吃吃饺子🥟,然后深度扒一扒这个“除夕特别版”的开源新王,到底强在哪里,又为何能让整个 AI 圈在春节期间炸锅。
核心突破
Qwen3.5的核心突破,在于它重新定义了“有效算力”。
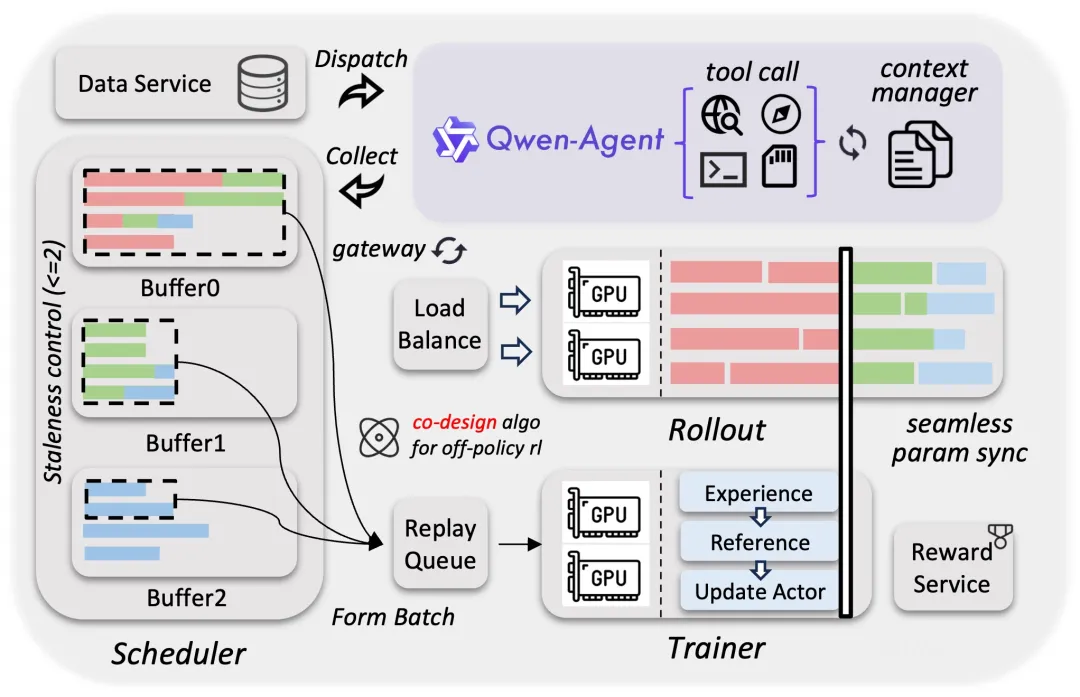
Qwen3.5-397B-A17B采用的是MoE(混合专家)+ 线性注意力(Linear Attention)的混合架构。
简单来说,模型虽然有 3970 亿个参数(总参),但在每次处理 Token 时,它并不是调用所有参数,而是像医院分诊一样,只激活最懂这个领域的 170 亿 参数(专家)来工作。
这意味着你拥有了一个“万亿级大脑的智商”,但每次思考时只消耗“百亿级模型的能量”。
而且性能并没有因大参数量而减弱,根据官方数据,在 256k 的超长上下文下,Qwen3.5-397B-A17B 的解码吞吐量是 Qwen3-Max 的19 倍! 即使是对比 Qwen3-235B-A22B,也快了 7.2 倍。
原生多模态
Qwen3.5 不再是一个“外挂眼睛”的盲人,它是原生视觉-语言模型(Native Vision-Language Model)。
它不需要外挂任何视觉编码器,它的神经网络天生就能看懂像素。
以前的多模态模型,是把图片编码成 Token 喂给 LLM,中间会有大量的信息损耗。而 Qwen3.5 从训练之初,就是视听语言一体的。
1M 上下文:支持 100 万 token 的超长上下文窗口。 真·Agent 能力:它具备了“边思考、边搜索、边调用工具”的能力。也就是俗话说的边想,边看,边干活。
完整智能体执行能力如下:
自动搜索 自动调用工具 自动写代码 可操作电脑/手机界面 支持与 OpenClaw 等系统集成
这一特性使其可以完美集成到我们之前提到的 OpenClaw 等 Agent 框架中,成为驱动自动化任务的最强大脑。
201 种语言的通天塔
阿里在多语言支持上一直很激进,这次更是把技能点点满了。
Qwen3.5 的词表扩展到了25 万,支持的语言数量从 119 种直接暴增到201 种。
除了常见的中英法德,它对小语种的支持也达到了可用级别。同时,编码/解码效率提升了 10-60%。
对于出海企业来说,你可以用一套模型,搞定全球 200 多个国家的用户客服和内容生成,无需针对每个语言单独微调。
快速入手
Qwen-3.5-Plus 可以通过以下方式直接体验:
QwenChat:https://chat.qwen.ai/ 阿里云百炼:https://bailian.console.aliyun.com/cn-beijing/?tab=model#/model-market/detail/qwen3.5-plus Hugging Face:https://huggingface.co/spaces/hadadxyz/ai 魔搭社区:https://modelscope.cn/models/Qwen/Qwen3.5-397B-A17B
当然了,上面的方式我都不用。我们可以直接在夸克浏览器或千问APP上直接就用使用最新的 Qwen3.5-Plus 模型能力。
比如夸克浏览器,只需要左上角点开模型切换,然后选择Qwen3.5-Plus即可。
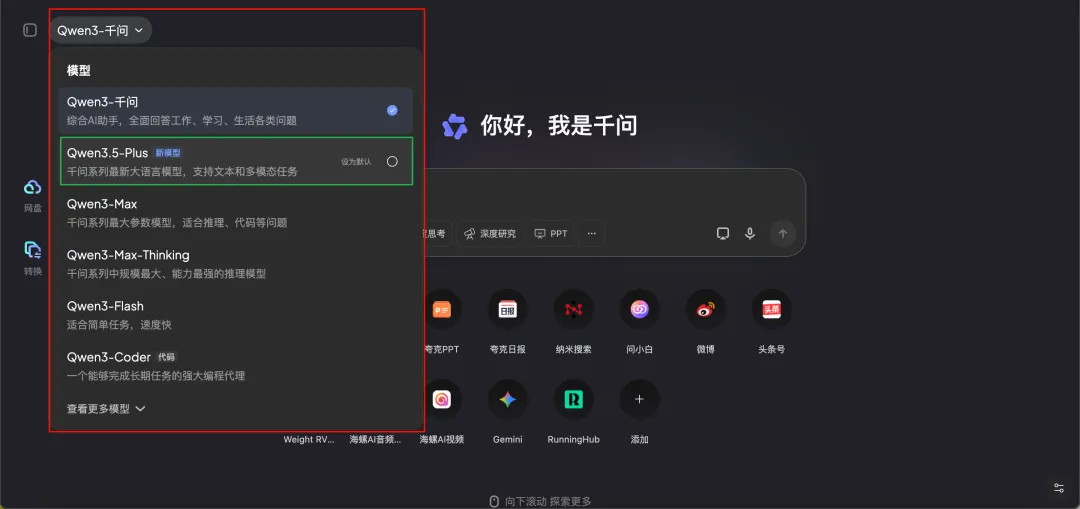
(夸克浏览器)
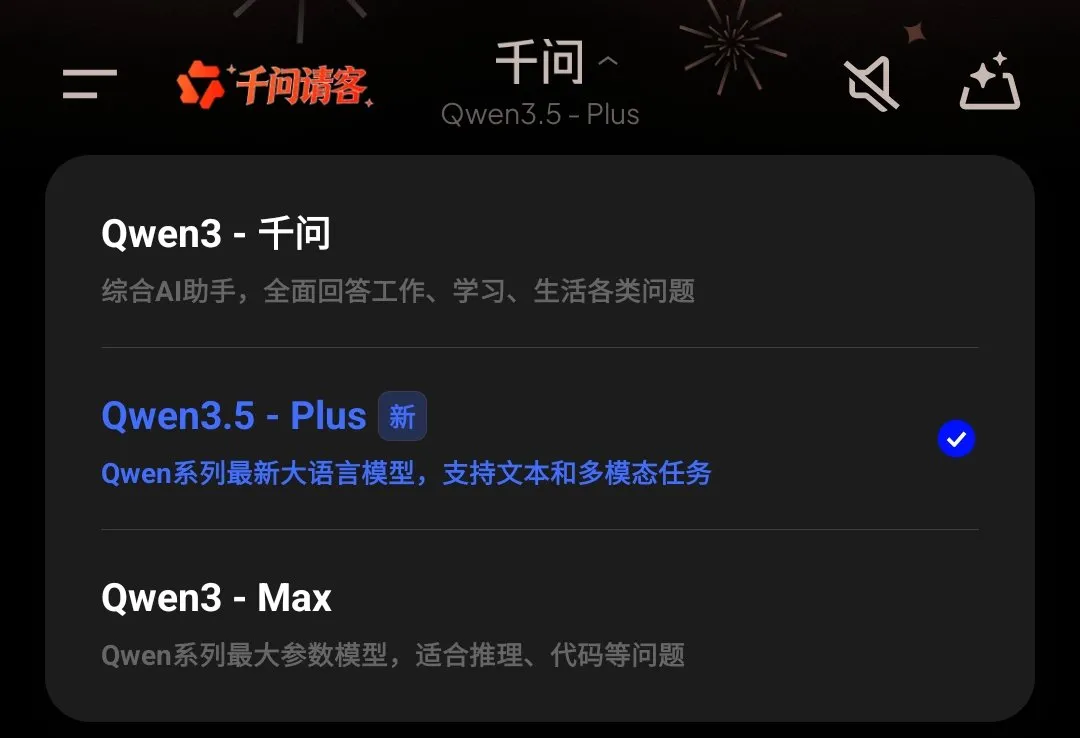
(千问APP)
我们可以让它给我们写新年祝福、快速开发一个应用、为我们规划春节最佳出行路线、为孩子寒假作业做解答等等都可以。
写在最后
在昨天的除夕夜,Qwen3.5的发布有着特殊的意义。
当闭源模型还在按 Token 计费、还在搞封闭生态时,阿里选择把这样一个媲美 GPT-5.2 级别的“核武器”直接开源。
397B 的参数,17B 的激活。这组数字背后,是阿里对未来 AI 趋势的精准预判:未来的 AI,不是比谁更大,而是比谁更聪明、更高效、更易用。
对于开发者而言,这个春节注定不平静。你的本地知识库、你的 Agent 助手、你的代码补全工具,可能都要在年后迎来一次彻底的“换心”手术。
