
 语音小管家
近日,ICASSP 2026会议发出了审稿结果通知,上海交通大学跨媒体语言智能实验室共12篇论文被会议接收。我们将用两期推送介绍接收论文,本文是第二期。
07、Task Vector in TTS: Toward Emotionally Expressive Dialectal Speech Synthesis
论文作者:凤鹏超*,萧遥*,马子阳,牛志康,樊帅,李曜,王盛,陈谐
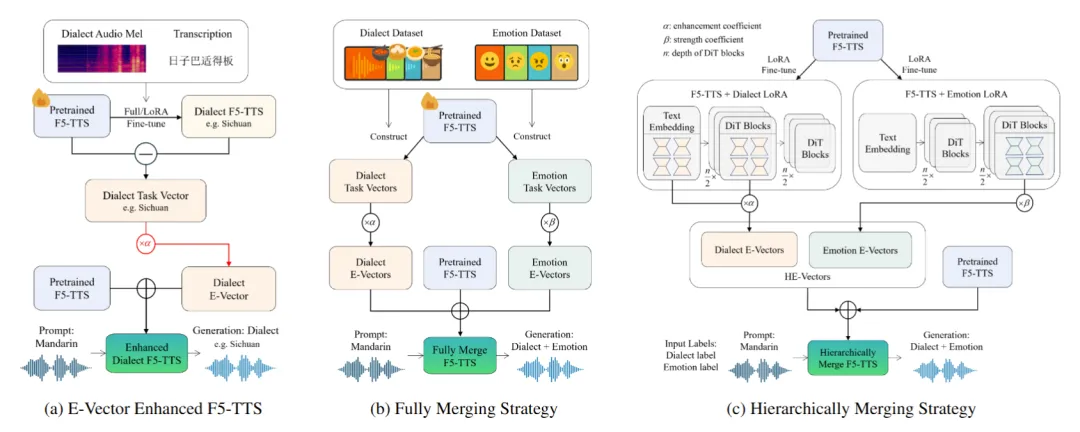
论文简介:语音合成(TTS)技术在自然度与可懂度方面已取得显著进展。在此基础之上,研究正日益转向提升合成语音的表现力,例如支持方言与情感合成。然而,将方言与情感相结合的跨风格语音合成仍面临较大挑战,相关研究尚不充分,主要原因是同时具备情感标签的方言数据十分稀缺。为解决该问题,本文提出一种两阶段的层次表达向量(Hierarchical Expressive Vector,HE-Vector)方法,用于情感方言语音合成。第一阶段,通过构建不同的任务向量分别对方言风格和情感风格进行独立建模,并借助权重调节优化单风格合成效果,该向量称为表达向量(E-Vector)。第二阶段,对这些表达向量进行分层融合,实现无需联合标注数据即可完成可控的情感方言语音合成,对应方法即为层次表达向量(HE-Vector)。实验结果表明,该方法在方言合成任务中性能优越,并在零样本条件下合成带有情感色彩的方言语音方面表现良好,推动了语音合成技术向更具表现力的方向发展。
08、Cross-Lingual F5-TTS: Towards Language-Agnostic Voice Cloning and Speech Synthesis
论文作者:刘庆宇,陈禹伸,牛志康,王春惠,杨云亭,张博文,赵剑,朱鹏程,俞凯,陈谐
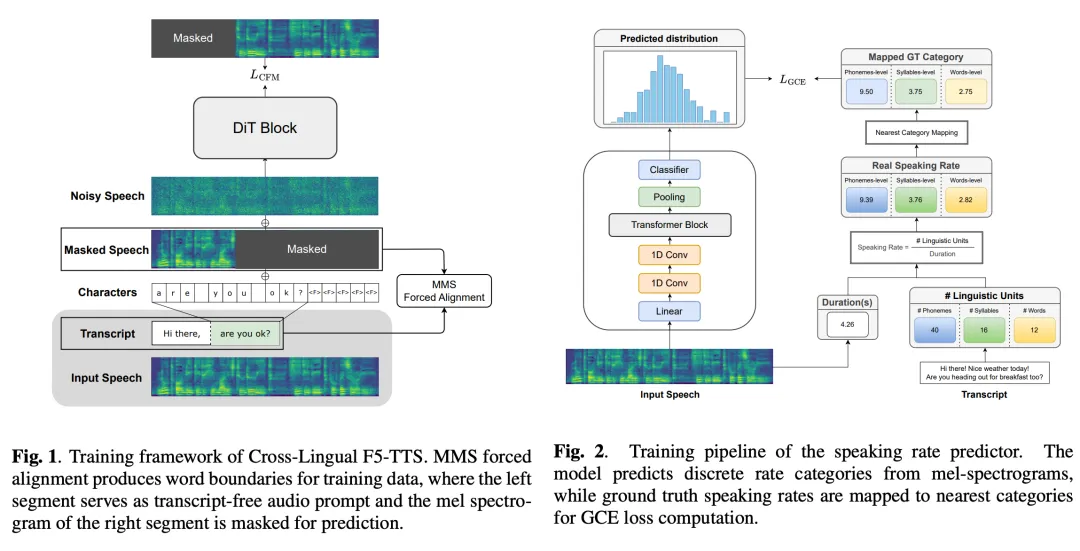
论文简介:基于流匹配的文本转语音(TTS)模型已展现出高质量的语音合成能力。然而,目前大多数基于流匹配的TTS模型在合成时仍需依赖与音频提示相对应的参考文本。这种依赖性导致在音频提示文本不可用时无法实现跨语言声音克隆,尤其是面对未见过的语言时更是如此。对于基于流匹配的TTS模型而言,移除音频提示文本的关键挑战在于训练阶段如何识别词边界,以及推理阶段如何确定合适的时长。本文提出了Cross-Lingual F5-TTS,这是一个无需音频提示文本即可实现跨语言声音克隆的框架。我们的方法通过强制对齐对音频提示进行预处理以获取词边界,从而在训练过程中无需文本即可直接从音频提示进行合成。为解决时长建模的挑战,我们在不同语言粒度上训练语速预测器,根据说话人的语速来推导时长。实验表明,我们的方法在性能上与F5-TTS相当,同时实现了跨语言声音克隆的能力。
09、PicoAudio2: Temporal Controllable Text-to-Audio Generation with Natural Language Description
论文作者:郑子豪,谢泽宇,徐薛楠,吴雯,张超,吴梦玥
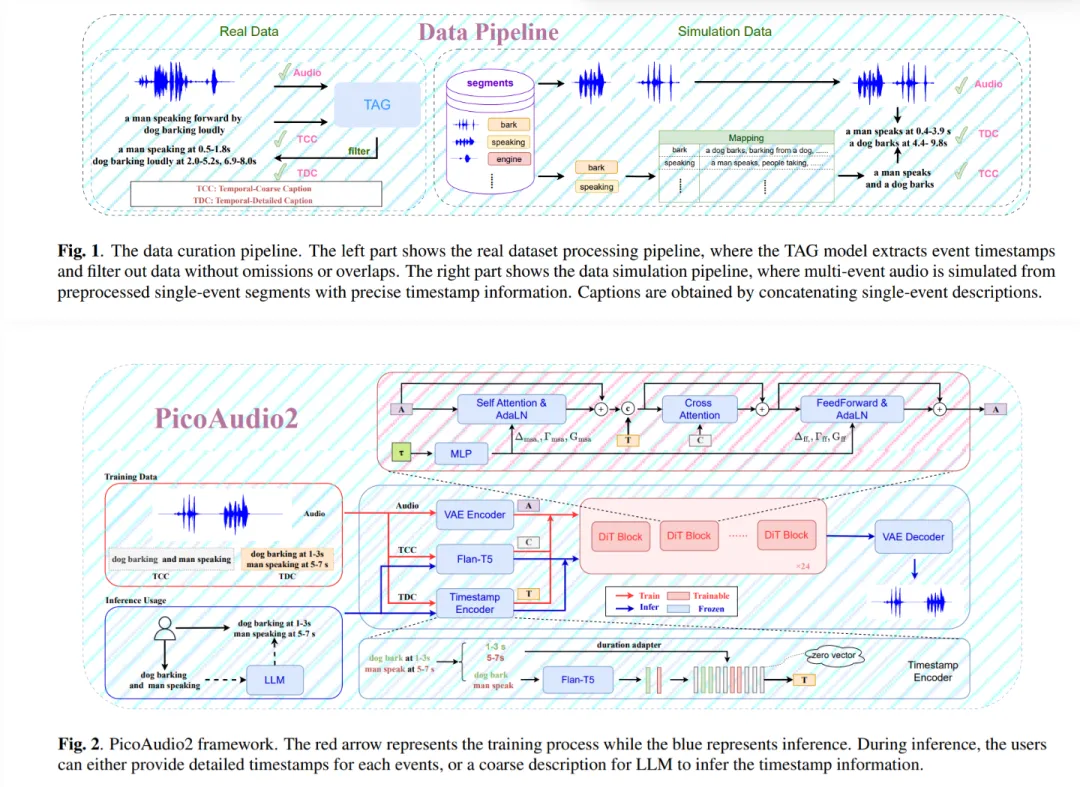
论文简介:尽管近期在可控文本到音频(TTA)生成领域,基于时间戳条件的方法实现了更精细的生成控制,但其应用仍受限于音频质量和输入格式。由于仅依赖模拟数据,这类模型在真实数据集上的音频质量通常不佳。此外,一些模型受限于声音事件的封闭词汇表,无法针对开放式、自由文本查询控制音频生成。本文提出了PicoAudio2框架,有效缓解了现有方法在数据和架构上的不足,提升了时间可控的TTA任务表现。具体而言,我们使用一个锚定模型来标注真实音频-文本数据集中的事件时间戳,筛选出强时间信息的真实数据,同时结合现有工作中的模拟数据。该模型在真实数据和模拟数据的组合上进行训练。此外,我们提出了一种增强型架构,将时间戳矩阵中的细粒度时序信息与自由文本的粗粒度语义信息相融合。实验结果表明,PicoAudio2在时间可控性及音频质量方面均实现了显著提升。项目主页可见:https://HiRookie9.github.io/PicoAudio2-Page
10、Why Do Speech Language Models Fail to Generate Semantically Coherent Outputs? A Modality Evolving Perspective
论文作者:王翰坤,王浩然,郭奕玮,李之涵,杜晨鹏,俞凯
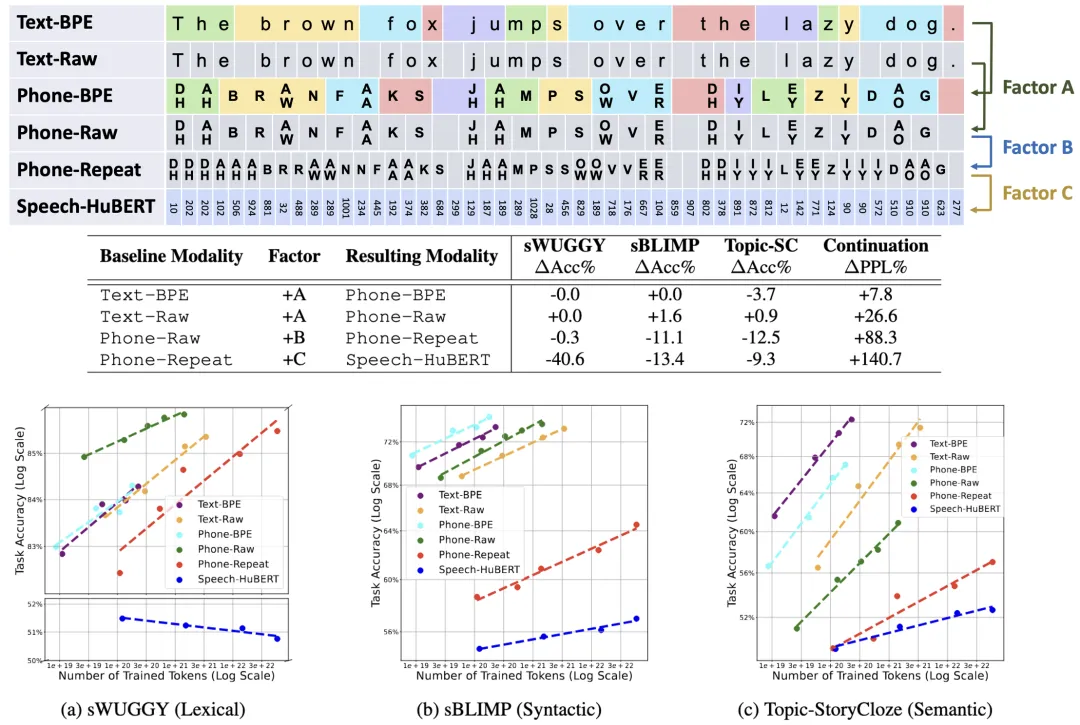
论文简介:尽管基于文本的大语言模型已展现出接近人类水平的写作能力,但端到端语音语言模型(SLM)在缺乏显式文本转写的情况下,仍难以生成语义连贯的输出。造成这种性能退化可能有多方面原因:(A) 语音 token 主要承载的是语音/音素层面的信息而非语义信息;(B) 语音序列长度远长于文本序列;(C) 韵律、口音等副语言信息带来了额外的变异性。本文通过以渐进方式将模态从文本过渡到语音,分别探究上述三项关键因素的影响。研究发现,三者的影响程度并不相同:因素 A 的影响相对较小;因素 B 对句法与语义建模的影响更为显著;而因素 C 的影响最大,尤其体现在基础词汇建模上。基于这些发现,我们总结了训练语音语言模型所面临的独特挑战,并指出了构建更有效端到端语音语言模型的潜在路径。
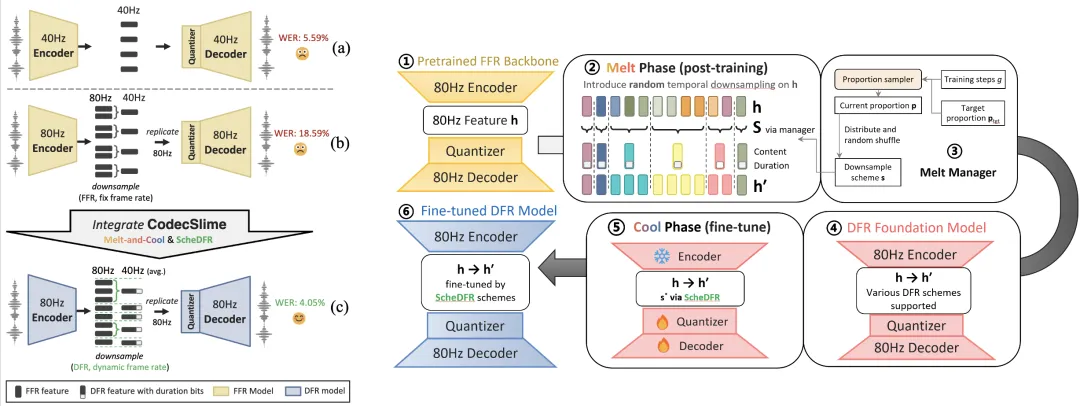
11、Codecslime: Temporal Redundancy Compression of Neural Speech Codec via Dynamic Frame Rate
论文作者:王翰坤,郭奕玮,邵重天,李波含,俞凯
论文简介:当前主流的神经语音编解码器多采用固定帧率(FFR)。然而,语音在时间维度上的信息密度天然是不均匀的,因此大量 token 会浪费在长元音、静音等稳态片段上。为解决这种不匹配,我们提出 CodecSlime:一种插件式方法,通过在神经语音编解码器中支持动态帧率(DFR)来压缩时间冗余。该方法无需监督、与具体架构无关,并包含两项关键创新——ScheDFR 与 Melt-and-Cool,分别用于适配推理与训练。当将其集成到典型的 VQ-GAN 编解码骨干中,并以 40 Hz 的动态帧率(≈600 bps)运行时,在相同模型架构且码率相近的条件下,CodecSlime 的重建 WER 相比传统 FFR 基线最多降低 28%,同时其他指标也具有竞争力。CodecSlime 还支持在重建质量与码率之间进行灵活权衡:单一模型即可在多种帧率下推理,并在对应帧率上持续优于 FFR 模型。更多音频样例与实验结果见:https://x-lance.github.io/codecslime/
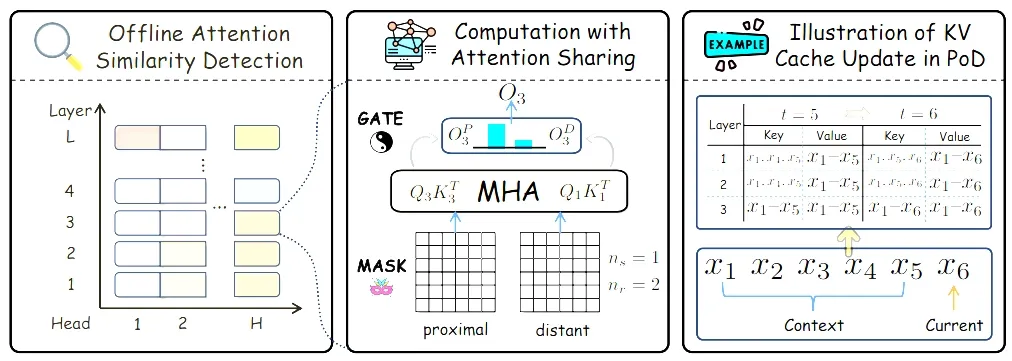
12、Compressing KV Cache for Long-Context LLM Inference with Inter-Layer Attention Similarity
论文作者:马达,陈露,张思拓,苗语洵,朱苏,陈志,许洪深,李瀚奇,樊帅,潘磊,俞凯
论文简介:大型语言模型(LLMs)中上下文窗口规模的快速扩展,使其能够处理涉及超长文档的日益复杂的任务。然而,这一进展也带来了推理阶段内存使用量的大幅增加,其主要原因在于键值(Key-Value,KV)缓存随上下文长度线性增长。现有的 KV 缓存压缩方法通常通过丢弃相关性较低的 token 来节省内存,但当关键信息被丢弃时,往往会导致显著的性能下降。本文提出了一种新的 KV 缓存压缩框架 PoD(Proximal tokens over Distant tokens,近端 token 优先于远端 token),根据 token 的重要性来分配内存:对于不太重要的 token,不是直接丢弃,而是以更紧凑、共享的形式进行保留。该方法基于两个关键观察:(1)近端 token——即位于上下文开头和结尾的 token——对下一 token 预测的重要性显著更高;(2)远端 token 的注意力分数在相邻层之间具有高度冗余性。基于这些洞察,PoD 对近端 token 保留完整的 KV 缓存,而对于远端 token,则在不同层之间共享其 key 状态。由于注意力分数由 query 和 key 共同决定,共享 key 状态可以使多个层复用同一组远端 token 的 key,从而在不丢失关键上下文信息的前提下,大幅降低 KV 缓存的内存开销。我们还引入了一种轻量级的后训练自适应方法,使模型能够适应这种新的注意力共享结构。在合成任务(Needle in a Haystack)和真实世界长上下文基准上的大量实验表明,PoD 在不牺牲性能的情况下,最多可将 KV 缓存的内存使用量降低 35%。此外,该方法与现有基于 token 选择的技术相互正交,可与其结合以实现进一步的 KV 缓存压缩。
