
 语音小管家
标题:TagSpeech: End-to-End Multi-Speaker ASR and Diarization with Fine-Grained Temporal Grounding
链接:https://arxiv.org/pdf/2601.06896
发表时间:2026年1月11日
作者单位:伊利诺伊大学厄巴纳-香槟分校、约翰霍普金斯大学
01、为啥要做TagSpeech?
传统级联方法太麻烦:先做语音活性检测(VAD)、再分离说话人、再ASR,步骤多,前面错了后面全歪(比如VAD漏检一段,ASR就没这部分了),还容易出现“说话人和文本对不上”的情况。下图就是这种级联流程,能看到步骤拆分导致的问题。
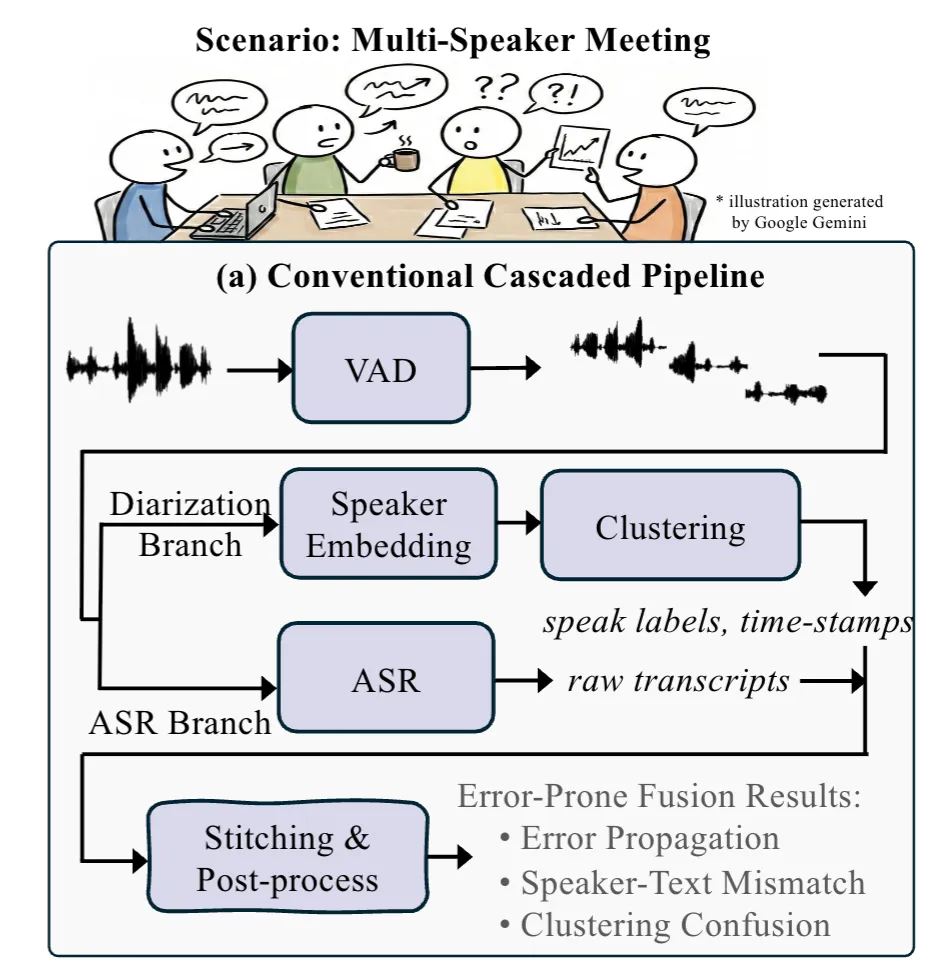
现有端到端方法不完整:很多方法号称“联合ASR和分离”,但要么没有明确的时间戳(比如SpeakerLM、JEDIS-LLM),没法用标准的“分离错误率(DER)”评估;要么处理不了重叠语音(比如多人同时说话时,模型会把语音排成“你说完我再说”的顺序,不符合实际)。
02、TagSpeech核心怎么设计的?
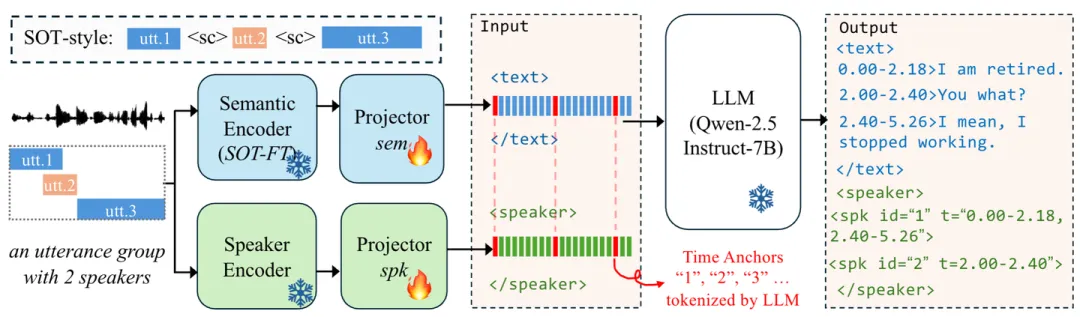
语义编码器(Semantic Encoder):负责“听清楚内容”,用的是Zipformer结构,还做了 SOT微调 (Serialized Output Training,序列化输出训练)。具体来说,就是把参考转录文本改成“带说话人切换标记的时序序列”——比如用 标记区分不同说话人,让模型学会“谁说完该谁了”,尤其能处理重叠语音(比如两个人同时说话时,模型能分清各自的内容)。
说话人编码器(Speaker Encoder):负责“认人”,用的是Auden-Voice模型,提前在“说话人识别、性别/年龄判断、情绪识别”等任务上预训练过。这样它输出的特征只认“人”,不管这个人说什么内容,避免被语义干扰。
在两个编码器的输出序列里, 每隔m帧插入一个离散的数字token (比如“1”“2”“3”),这些数字对应实际时间(比如每8帧插一个,对应1.28秒)。 这个锚点有两个用:一是给模型提供“时间刻度”,让它能预测精确时间戳;二是同步“语义流”和“说话人流”——因为两个流插锚点的间隔一样,模型能对应上“某个时间点的内容是谁说的”。 最关键的是:不用改LLM的词汇表,直接用现成的数字token,成本很低。
输入时,把语义编码器的特征包在 标签里,说话人编码器的特征包在 标签里,LLM一看就知道哪部分是内容、哪部分是说话人信息。 输出时,也按这个结构来,直接生成“时间戳+说话人+文本”的格式(比如“0.00-2.18 spk1: Welcome to the meeting”),不会乱输出,失败率很低。
03、实验怎么做的?结果怎么样?
AMI(英文):远场单麦克风(SDM)子集,有自然的多人对话、重叠语音,训练集65小时,测试集7.3小时。
AliMeeting(中文):远场子集,重叠语音更多(30%-40%),训练集103.4小时,测试集9.9小时。 数据分割:把“相邻且无间隙的utterance(话语段)”当成一个样本,更贴近真实会议场景。
评估指标:
DER(分离错误率):衡量“谁在什么时候说”的准确性,算三种错误:漏检(该有说话人没预测到)、误检(没说话人却预测有)、混淆(说话人标签搞反),用0ms“宽容度”(最严格的标准),还包含重叠区域。
cpWER(拼接最小置换词错误率):先把每个说话人的预测文本拼起来,再找“预测说话人”和“真实说话人”的最佳匹配,既看ASR准不准,也看说话人分配对不对。
gWER(全局词错误率):不管说话人,把所有文本按时间拼起来算WER,只看ASR本身的质量。
SCA(说话人数量准确率):预测的说话人数量和真实数量一致的比例。
失败率:模型输出无效内容(比如格式错、幻觉)的比例,失败率高的话,其他指标就不可信了。
基线模型对比了主流的端到端模型和级联模型:
端到端:Gemini-2.0-flash、Qwen2.5-Omni-7B、Qwen3.0-Omni-30B。
级联:Pyannote 3.1(专门做分离)+ Whisper-large-v3(专门做ASR)——这是分离任务的强基线。
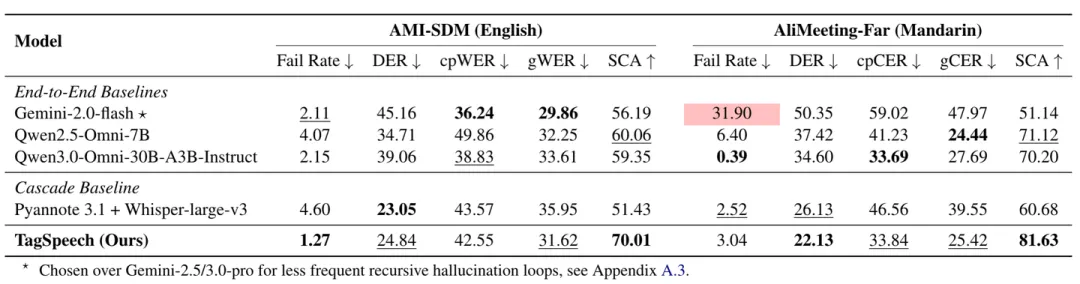
DER指标上TagSpeech在两个数据集上都比所有端到端基线好:
1、AMI上:TagSpeech的DER是24.84%,比Gemini(45.16%)、Qwen2.5(34.71%)、Qwen3.0(39.06%)低很多,相对提升约28%;只比级联的Pyannote+Whisper(23.05%)稍高一点,但TagSpeech是端到端,不用拆步骤。
2、AliMeeting上:TagSpeech的DER是22.13%,比Qwen2.5(37.42%)、Qwen3.0(34.60%)低,相对提升约36%,甚至比级联的Pyannote+Whisper(26.13%)还低!
SCA(说话人数量准不准):TagSpeech是所有模型里最高的——AMI上70.01%,AliMeeting上81.63%,说明它能准确判断“有几个人在说话”,这对分离很重要。
失败率:TagSpeech很低,AMI上1.27%,AliMeeting上3.04%,比Gemini(AMI 2.11%、AliMeeting 31.90%)、Qwen2.5(AMI 4.07%)稳定多了,不会乱输出。 ASR质量(cpWER/gWER):TagSpeech不是最好的,但很稳——比如AMI上cpWER 42.55%、gWER 31.62%,虽然比Qwen3.0的cpWER(38.83%)稍高,但在AliMeeting这种高重叠场景下,表现比很多基线好,说明它处理重叠语音时ASR也不拉垮。
编码器设计的影响(AMI数据集)
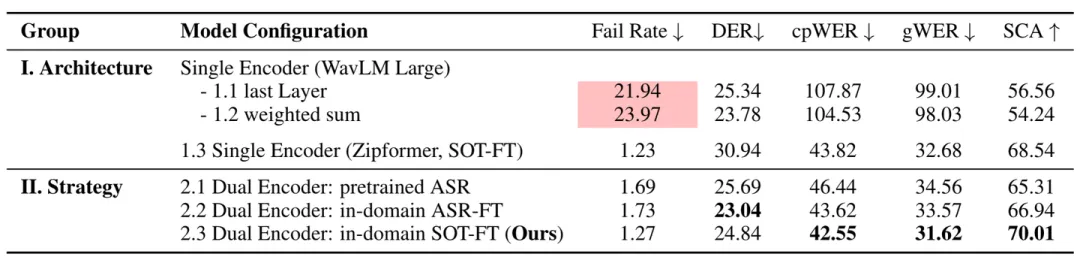
单编码器不行:不管用WavLM-Large(强语音模型)还是自己的Zipformer,单编码器的失败率超高(WavLM甚至20%+),cpWER也崩了(100%+),说话人分配完全乱了。这说明“语义”和“说话人”必须分开处理,混在一起会互相干扰。
SOT微调很关键:双编码器架构下,用SOT微调的语义编码器(咱们的方法)效果最好——DER 24.84%、cpWER 42.55%、SCA 70.01%,比“预训练ASR编码器”“域内ASR微调编码器”都好。因为SOT能让模型学会处理说话人切换和重叠语音。
SOT微调的泛化性(AliMeeting数据集)
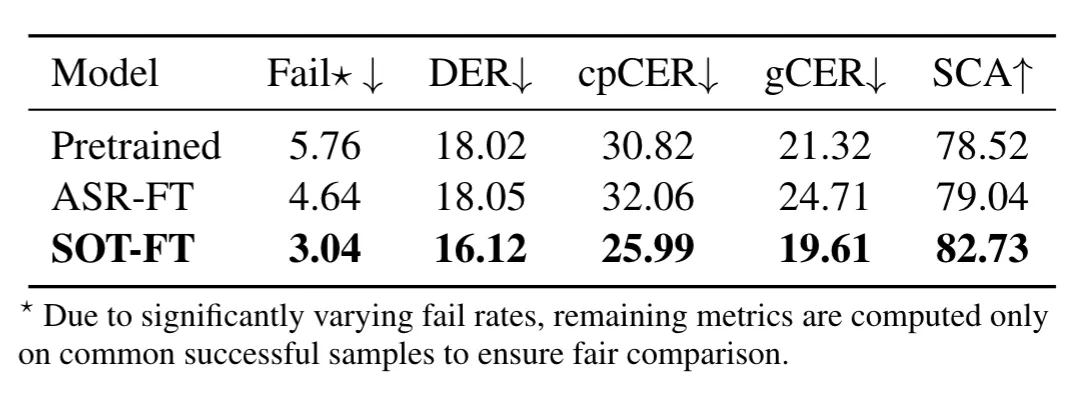
04、深入分析:TagSpeech为啥这么好?
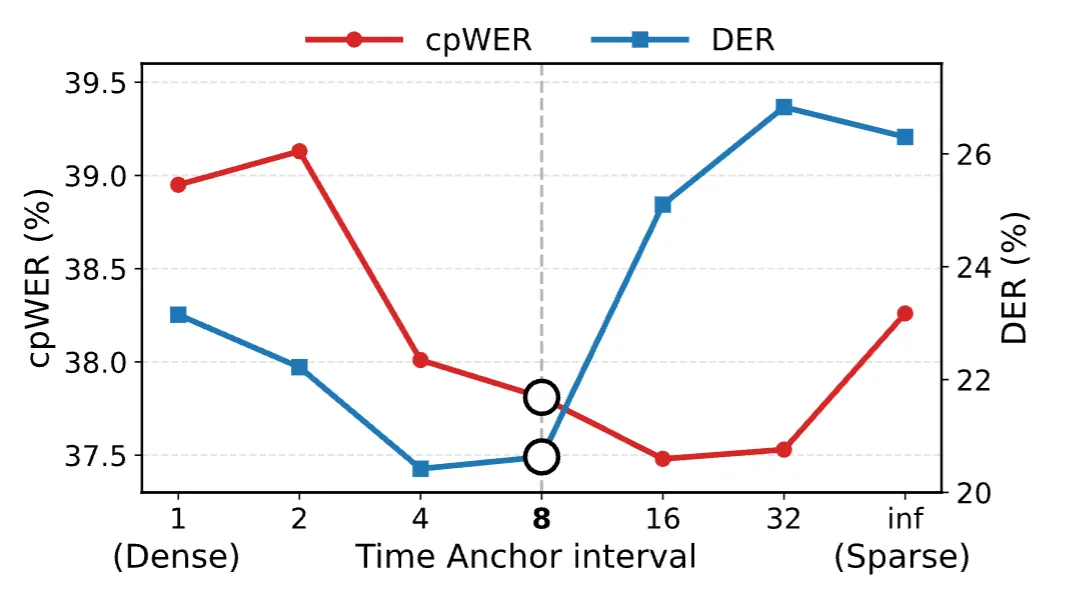
结果是 U型曲线 :太密(每1帧)会让序列里全是时间token,打乱语义和说话人的特征,DER和cpWER都升高;太疏(≥16帧)则时间信息不够,DER飙升(比如32帧间隔时DER快25%); 8帧间隔(对应1.28秒)是甜 spot ,既能提供足够的时间定位,又不干扰语义,DER和cpWER都最低。
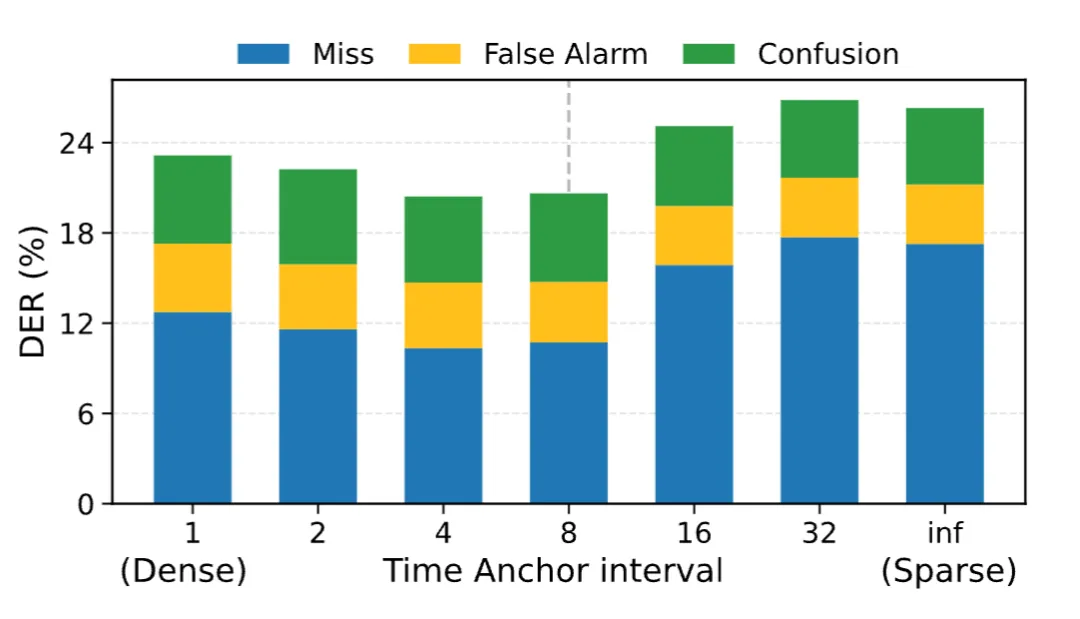
发现漏检是主要误差来源,尤其是锚点疏的时候(比如32帧间隔,漏检率很高)。这说明时间锚点的核心作用是“减少漏检”——比如重叠区域里,模型能更准确地检测到所有说话人,不会漏掉某个人的语音。
连续嵌入(比如正弦嵌入):最差,DER 27.22%,因为LLM对连续信号不敏感。
固定token(比如重复“ANCHOR”):比连续好,但只能提供“节奏”,没有实际时间信息,DER 22.57%。
文本锚点(比如
数字锚点(咱们的方法,1-2个token):DER 21.75%,只比文本锚点稍高一点,但token成本低很多,不用额外处理,更适合长音频(比如1小时会议)。
短音频幻觉:Gemini处理0.21秒的短音频(真实只有“Yep”一个词),居然生成了28秒的对话,全是幻觉——因为它没有时间锚点,不知道输入实际很短,只靠自己的语言先验乱编。而TagSpeech因为有时间锚点,能准确匹配输入时长,不会幻觉。
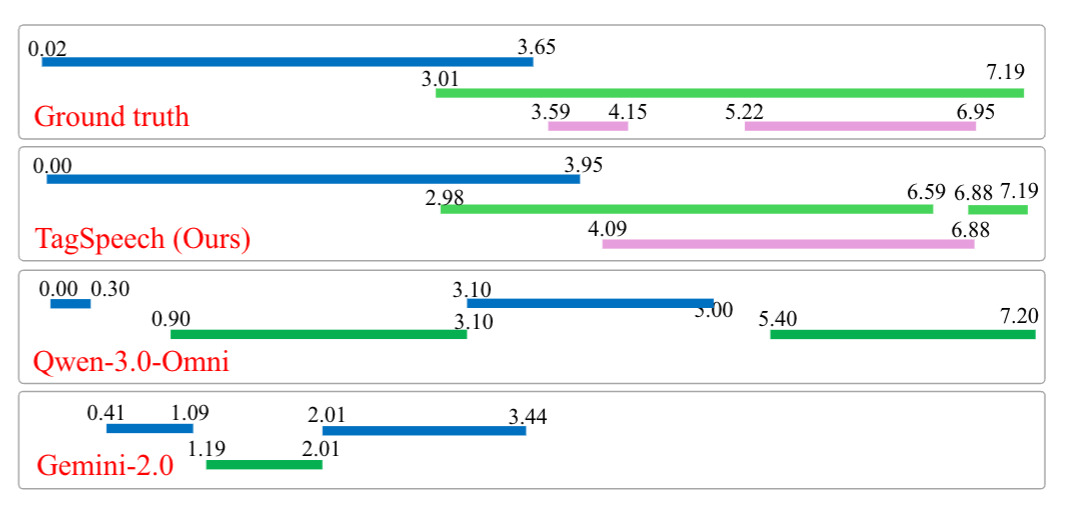
重叠语音线性偏差:Qwen和Gemini处理重叠语音时,会强行把“同时说”排成“顺序说”(比如A说0.0-2.0秒,B必须说2.1-4.0秒),这就是“线性偏差”。而TagSpeech能正确输出重叠的时间线(比如A 0.0-2.0秒,B 1.5-3.0秒),符合实际对话情况。
05、总结和局限性
第一个端到端框架,能同时输出“转录文本+说话人标签+精确时间戳”,解决了之前方法“缺时间戳”的问题。
用“双流解耦编码器+SOT微调”处理重叠语音和说话人切换,用“交错数字时间锚点”同步信息,不用改LLM,成本低。
在AMI和AliMeeting上,DER比主流端到端模型好28%-36%,SCA最高,失败率低,还能处理重叠语音的线性偏差。
训练数据少:AMI只有65小时,AliMeeting 103小时,泛化到更多语言、更多场景(比如嘈杂环境)还需要更多数据验证。
推理慢:因为是LLM自回归生成,比级联模型(比如Pyannote+Whisper)慢,实时场景(比如直播字幕)可能不适用。
没评估副语言信息:虽然说话人编码器Auden-Voice能处理性别、情绪,但数据集没标注这些,所以没验证这部分能力。
