
 语音小管家
本系列十篇文章,旨在对之前提到的十大趋势进行详细剖析。系列中将穿插科普、技术综述、技术发展路线,以及来自我个人与其他行业专家的思考。希望不论读者此前对语音技术与应用了解多少,都能从这一系列文章中获得有价值的观点。
本篇将围绕趋势五和六——“具身智能落地之后的语音交互与理解、多模态技术变革”展开。将两者合并讨论,是因为具身产品是多模态技术天然的载体。具身智能融合了视觉、听觉、触觉等感知能力,并能完成复杂、通用的任务,重点不在于它的外形,而在于它能解决多少真实世界的问题。
具身智能中语音感知能力仍大幅落后
无论是学术界还是工业界,当前对具身智能的研究主要集中在视觉感知与运动控制上,这的确得益于视觉-语言模型(VLA)、自动驾驶等相关技术近年的快速发展。一台价值十几万甚至几十万的机器人,可能连最基本的语音功能都不具备。这一方面是因为研发重心还无暇顾及,另一方面,大多数人对语音交互的认知仍停留在“语音控制”阶段,而这的确是现状。
听觉感知,不仅仅是发号施令
在真实的智能环境中,听觉与视觉无疑是生物感知世界最重要的两个通道。我用一个“T”字形来比喻二者的特点:
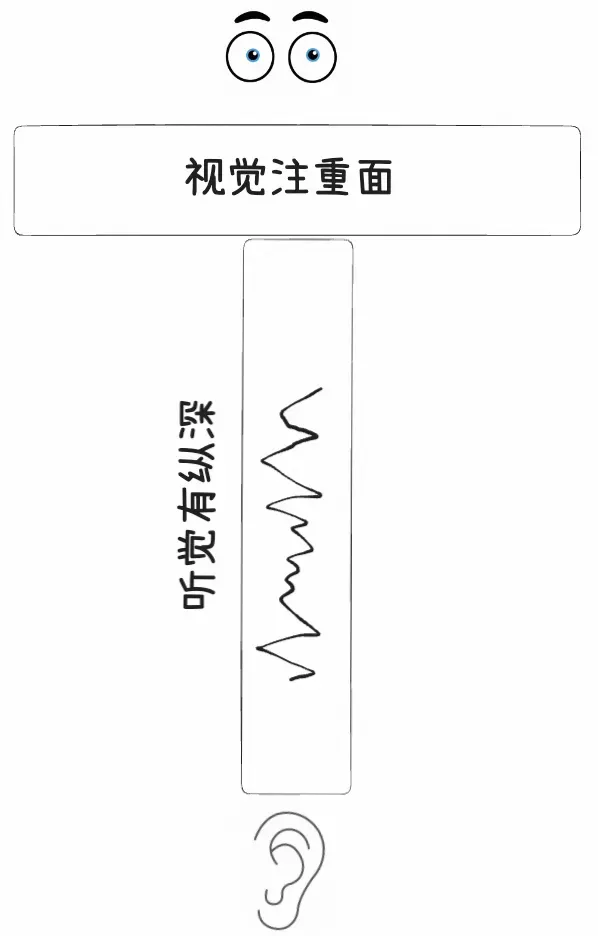
视觉注重广度,最直观,确定性与可解释性相对较高,但也容易受遮挡等干扰,且往往缺乏深度信息; 听觉更注重深度,对遮挡不敏感,但不够直观,确定性与可解释性相对较低(此处不仅指语音,也包括广义的环境声音)。
从手机语音助手、智能音箱、车载语音,到更自然的语音类陪伴产品,语音交互的自然度已大幅提高。但截至目前,用户仍习惯采用“指令式”交互,即机器被动地执行某个预设命令。这种方式虽然简单高效,却远不能称为真正的“听觉感知”。
无论具身智能以何种形态进入家庭,听觉感知都是不可或缺的一环,包括对语音及各类环境声音的感知。它应像家庭中的一员,即使看不见,也能通过声音识别是谁在说话、是否在对自己说话、哪些声音是熟悉的、哪些是陌生的,甚至能感知婴儿是否饿了困了、家人是否发生争执……
这听起来或许像是天方夜谭,但若将这些能力拆解为独立的原子任务,在现有技术条件下都已能实现,只是系统集成复杂度高;而采用端到端的统一语音理解模型,也已出现如 Gemini 这类表现突出的产品。因此,这并非遥不可及,很可能在未来一两年内就能逐步落地。
音频感知硬件方案尚不成熟
最近有不少朋友询问,能否为他们的机器人外挂一个语音交互模块。我略感惊讶:几十万的机器人,竟未内置基础的语音交互功能?这也反映出当前具身行业对语音交互方案的重视不足。麦克风应如何布局以减少噪声干扰、采用何种拓扑、是否需具备指向性等,都直接影响最终体验,而目前显然尚未形成成熟的硬件方案。
在智能音箱蓬勃发展的时期,行业已沉淀出一批麦克风阵列与音频芯片的软硬件方案。而在具身智能时代,也必将如此。未来的音频硬件可能不再局限于规则拓扑(如直线或环形排列的 2 麦、4 麦、6 麦),而会走向更灵活的分布式布局方案,配合更精准的声源感知算法。随之而来的将是技术升级,并催生产业链的一系列调整。
移动的算力中心
感知的第一步是数据采集,第二步是数据处理。具身智能在体积与使用环境上的优势,使其完全可能成为一个家用的移动算力中心。这不仅能更好地保护用户数据隐私,也能提升交互的实时性与体验流畅度。
多模态技术赋能的交互
如前所述,视觉与听觉在交互中形成“T”字形的互补结构,缺乏任一模态都会导致信息大量损失。从模型到硬件,从各类穿戴设备如智能眼镜、智能耳机(例如近期光帆科技发布的带摄像头的耳机),其实都在探索多模态的交互形态。
多模态理解架构的合理性探讨
当前如 Omni 等主流多模态架构,大多将不同模态离散化,再以自回归方式进行预测。这类架构虽取得了一定效果,但未必是最合理的框架。我认为现有架构存在如下局限:
模态扩展性较差 模态间的序列对齐易被破坏
直觉而言,人类处理多模态信息时,往往遵循“模态间并行、模态内串行、高层信息融合”的原则。将所有模态数据统一串行处理,未必是最优选择。未来在算法层面,或许还需探索更高效的多模态建模方式,当前“全部离散为 Token + 自回归预测”的范式也值得重新思考。
算力成本降低是多模态交互的重要前提
视频与音频的处理对算力要求极高。然而,算力成本势必持续下降,计算能力也会不断增强,这为多模态交互与理解提供了关键的基础。
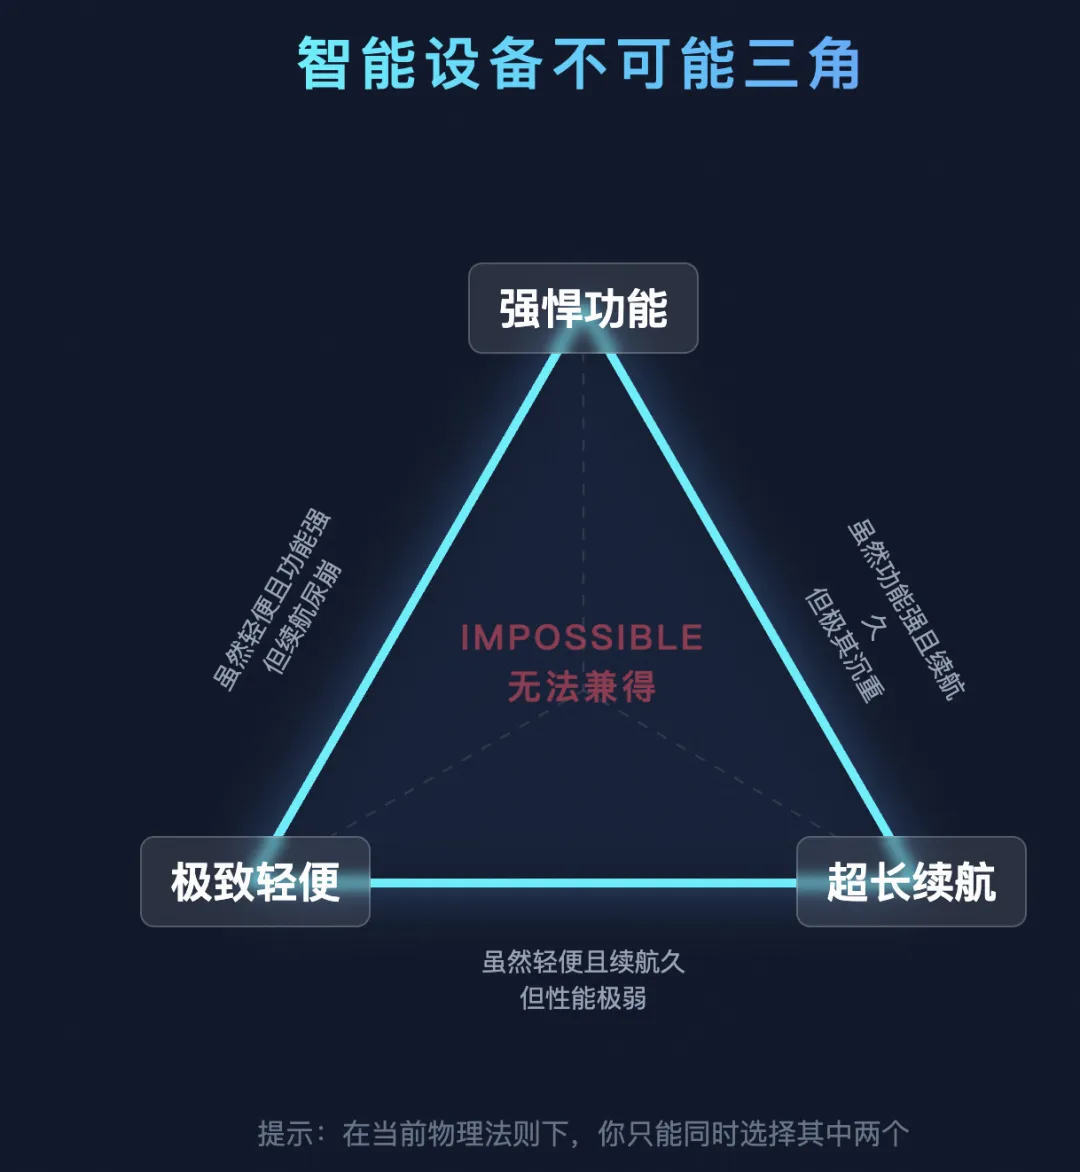
目前大多数便携设备都面临“功能、续航、重量”的不可能三角:要轻薄就牺牲续航,要强大能力就需更大算力而牺牲体体积重量。而在机器人等体积较大的具身形态上,这一问题相对较小。因此,结合具身智能的落地场景,我们有理由相信,多模态的端侧计算也将大有可为。
不止于听觉与视觉
多模态的范畴还将继续扩展。具身智能本质上是传感器的集合,输入信息越全面,输出与反馈就越精准。除视觉、听觉外,还包括压力、速度、温度、湿度等多种传感器数据。
随着更多模态的加入,模态间数据量级的差异、系统的综合决策等,对系统架构都是巨大挑战。当然,这其中也蕴含对未来发展的美好想象——而这样的想象,似乎正越来越接近现实。
总结
具身智能的落地场景,大概率在未来两年逐渐涌现。无论其外形是人形、宠物形还是其他形态,它终将成为一个移动的计算平台。基于强大的端侧算力与云端服务,加之用户对智能认知与需求的日益增长,多模态交互必将成为不可或缺的一环。正如自动驾驶的发展历程,只要大方向正确,即便最终未完全抵达想象中的终点,这个过程也必定会带来丰富的收获。
