
 语音小管家
小样本视听分类(Few-Shot Audio-Visual Classification, FS-AVC)是多模态学习领域极具挑战性的任务。它要求模型在仅有极少量标注样本的情况下,通过挖掘视觉与听觉的互补信息,实现对新类别的准确识别。
然而,现有的多模态方法通常依赖大量数据进行预训练,直接迁移到小样本场景时面临严重的参数过拟合、视听时序不同步以及模态学习速率不平衡等问题。
针对上述挑战,香港科技大学(广州)联合香港理工大学、萨里大学的研究团队提出了语义调制提示学习框架(Semantic Modulated Prompting, SMP)。该工作并未单纯依赖预训练模型的特征能力,而是通过引入文本语义作为“提示”,设计了参数高效的P-AVeL与动态重平衡机制P-PR,有效提升了小样本场景下的多模态学习效率。
该成果已被语音与信号处理领域顶级期刊IEEE/ACM Transactions on Audio, Speech, and Language Processing (TASLP)正式接收。
论文标题:Semantic Modulated Prompting for Few-Shot Audio-Visual Classification
作者:Guanjie Huang, Yawen Cui, Danny Hin Kwok Tsang, Wenwu Wang, Li Liu*
收录期刊:IEEE TASLP 2026
核心挑战与动机
视听分类旨在结合声音和视频来识别事件。然而,在现实应用中,收集大规模标注数据既昂贵又耗时且常常受到隐私问题或罕见场景的阻碍。当我们试图在小样本场景下训练视听多模态模型时,面临着三大核心痛点:
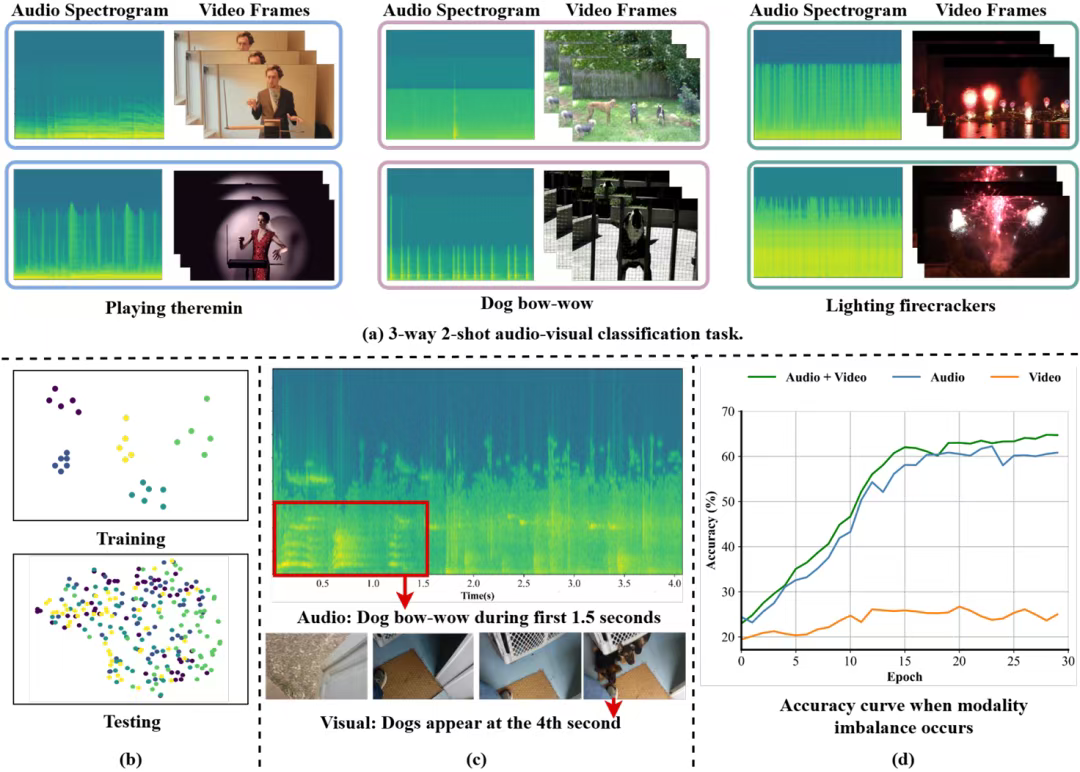
过拟合风险(Significant Overfitting):多模态模型参数量大,而在N-way K-shot(如K=1)设定下数据极度稀缺,传统微调极易导致过拟合。
时序异步融合难(Fusion Difficulty under Temporal Asynchrony):声音事件与视觉画面往往存在时间错位(例如画面中物体出现滞后于声音)。在缺乏大量数据监督时,模型难以学习到鲁棒的跨模态对齐关系。
模态不平衡(Severe Modality Imbalance):视觉与听觉模态的学习速率不一致,且数据集往往存在对某一模态的偏好(Bias)。在小样本训练中,主导模态容易抑制另一模态的特征表达,导致次优解。
研究方法:语义调制提示学习(SMP)
为了解决上述问题,研究团队受人类认知启发(即利用语言描述来辅助理解视听信息),提出了语义调制提示学习框架(Semantic Modulated Prompting, SMP)。
该框架的核心在于引入文本语义(如"A video of [label]"或由视觉语言模型 VLM 生成的描述)作为prompt,通过两大创新组件来调制视听学习过程:
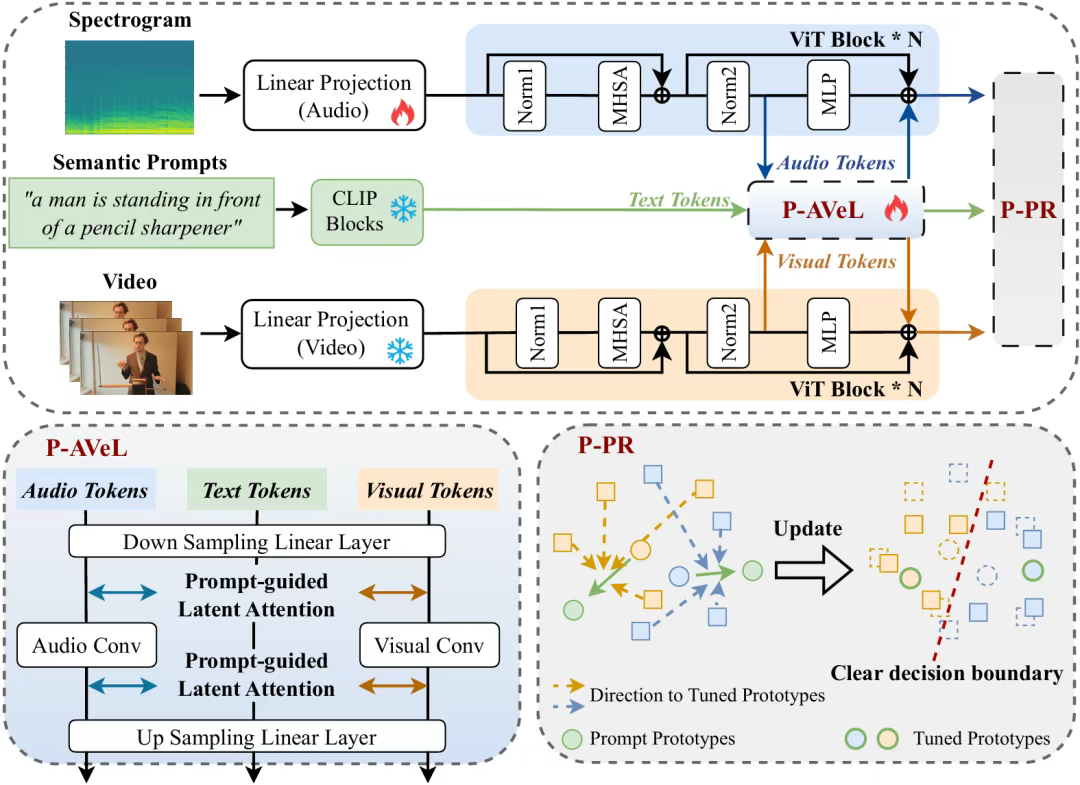
提示优化的视听高效学习器(Prompt-Refined Audio-Visual Efficient Learner, P-AVeL)
这是一个基于 Adapter(适配器)的参数高效模块。
抗过拟合:冻结预训练的骨干网络,仅训练少量的 Adapter 参数。
提示引导的潜在注意力(Prompt-guided Latent Attention):创新性地利用文本 Token 作为桥梁,在潜在空间中引导音频和视频 Token 进行交互。即便视听在时间上未对齐,语义信息也能帮助模型“聚焦”到关键片段,实现高效融合。
提示微调的原型正则化(Prompt-Tuned Prototypical Regularization,P-PR)
这是首个专为小样本场景设计的模态重平衡方法,其两大步骤均为动态自适应过程
动态原型校准:针对小样本特征不准的问题,P-PR 会在每一个训练批次中,根据当前文本提示的质量动态计算调节强度。利用这一实时变化的强度,将视听原型 “拉” 向更准确的语义中心,实现精准校准。
自适应重平衡:基于上述动态校准后的原型,算法进一步评估当前视听模态的学习偏差。据此,自适应地调整损失函数的权重,遏制主导模态的过拟合,扶持弱势模态,从而实现双模态的均衡训练。
实验分析:框架设计的有效性验证
研究团队在AVE, VGGSound100, Kinetics-Sounds数据集上进行了广泛实验。除了SOTA性能比较外(表1),文章通过不同配置的对比(表2),深刻揭示了SMP的架构优势。

表 1:与现有方法的性能对比
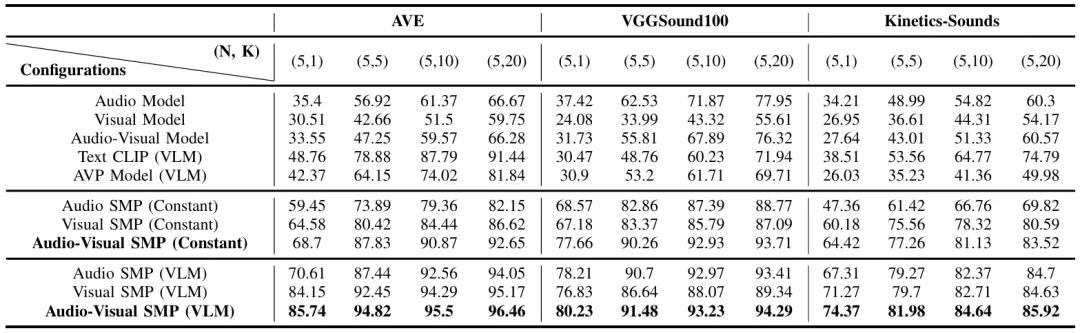
表 2:SMP框架有效性实验
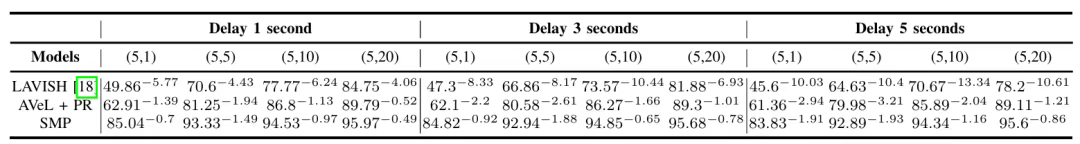
表3:视听时序异步的鲁棒性测试
核心发现一:简单的特征拼接在小样本下失效
为了验证P-AVeL交互机制的必要性,实验设置了AVP Model基线,即直接将VLM提取的文本特征与视听特征在分类头前进行拼接。
结果:在VGGSound100等数据集上,AVP模型的表现甚至低于单模态基线(Audio Model)。
分析:这表明在数据受限时,简单的特征拼接无法有效对齐异构模态,甚至引入了噪声干扰。深层的交互机制(如SMP中的Latent Attention)是必不可少的。
核心发现二:SMP框架具有极强的鲁棒性,不完全依赖高质量Prompt
实验对比了两种提示设置下的SMP性能:
SMP (Constant):仅使用固定模板"A video of [label]"作为提示。
SMP (VLM):使用mPLUG-2生成的详细视频描述作为提示。
结果:即便仅使用简单的 Constant Prompts,SMP的性能依然大幅优于基线模型和AVP模型。
结论:这证明了SMP的性能提升不仅仅源于VLM引入的额外知识,更源于框架本身(P-PR的正则化效应与P-AVeL的融合高效性)对小样本学习过程的优化能力。
核心发现三:SOTA性能,参数效率和时序异步鲁棒性
在与LAVISH, AV-MoE等现有SOTA方法的对比中,SMP在绝大多数Few-Shot设置(1-shot,5-shot等)下均取得了最优结果(表2)。
参数效率:SMP的可训练参数仅为2.56M,远低于AV-MoE (47.7M)和LAVISH (4.64M)。
抗干扰性:在人为引入1-5秒视听延迟的压力测试中(表3),SMP表现出了显著优于对比方法的稳定性,验证了语义引导对时序异步的鲁棒性。
总 结
本文提出了一种参数高效的视听小样本学习框架SMP。该工作的主要贡献在于:
架构创新:证明了通过语义提示在潜在空间引导视听融合,比简单的特征拼接更适合小样本场景。
动态调节:提出了P-PR机制,利用文本模态作为锚点,动态校准原型并平衡模态学习速率,解决了FS-AVC中的非平衡问题。
实证有效:在低资源、低参数量、含噪声(时序异步)的场景下,SMP均展现出了优越的性能与鲁棒性。
