
 语音小管家
论文:Contextual Biasing for LLM-based ASR with Hotword Retrieval and Reinforcement Learning
作者:阿里巴巴通义实验室
论文链接
https://arxiv.org/abs/2512.21828
在真实业务里,如果你做过语音识别落地,大概率会遇到类似的崩溃瞬间:
在医疗场景,医生口述一长串药品名、病理名,模型能把普通口语识得很好,一到专业名词就开始「编」,还经常把词表里没出现的药名硬说出来;
影视媒体、短视频领域,剧名、角色名、艺人名每天都在更新,热词词表轻轻松松几十万条,模型一旦“认不住、认不准”,用户搜不出东西。
即使对于LLM-ASR这种强大的语音识别模型,在落地过程中也绕不开热词这个话题。
团队在最新工作中提出了一个面向LLM-ASR的可扩展上下文偏置框架,把“热词检索+ LLM自适应+强化学习”串成一套系统,在大规模热词场景(近10万规模词表)下显著提升了热词识别能力,同时提升了整体识别效果。本文带大家拆解这篇工作背后的设计思路与实验结果。
⏩问题背景:LLM-ASR也无法通吃三百六十行
近两年,大模型(LLM)与语音识别结合非常火:Seed-ASR、FireRedASR、Qwen-Audio 等工作已经证明,把 LLM 接到声学编码器后,利用 LLM 的长上下文推理与语言先验,可以在通用任务上拿到非常亮眼的效果。
但落地到真实业务场景,“上下文偏置(contextual biasing)” 仍然是一个老大难问题:
传统 WFST、浅融合 LM、类 N-gram 等偏置方案大多针对非 LLM 体系,迁移到 LLM-ASR 并不自然;
这些词对业务价值极高——识错一个名字、药品或电影,体验就会直线下降;
直接把一大堆热词作为 prompt 喂给 LLM,词表一大就会暴露出两个问题:
检索:从几十万词里选谁进 prompt?
使用:LLM 会不会“乱用热词、到处幻觉”?
⏩总体框架:检索+强化学习,两阶段协同
团队把问题拆成了两个紧密耦合的子问题:
热词检索(Hotword Retrieval):从大词表中,为当前语音检索出一小撮最相关的top-k热词;
热词感知ASR适配(Hotword-aware ASR Adaptation):把检索出的热词以prompt形式喂给LLM-ASR,并用强化学习优化其使用策略。
整体结构可以类比为语音版的RAG(Retrieval-Augmented Generation):
检索侧:基于改进版GLCLAP(Global–Local Contrastive Language–Audio Pre-trained Model)做音频↔热词文本的匹配;
识别侧:把检索到的热词放到LLM-ASR的文本prompt中,用GRPO(Generative Rejection-based Policy Optimization)做RL微调,让模型学会:
对真正出现的热词要“认得准”;
对没出现的热词不要“瞎猜”;
兼顾整体转写的WER /句子准确率。
一句话总结:“先聪明地选词,再教会模型什么时候该用、什么时候别用。”
⏩第一阶段:增强版GLCLAP热词检索
GLCLAP:从音频到热词的“双塔匹配”
GLCLAP模型包含:
A-Enc(Audio Encoder):把输入语音编码成一个固定维度向量h_audio;
T-Enc(Text Encoder):把词表中的每个热词g_i编码成向量e_i。
检索过程:
对当前音频算h_audio;
对大词表G={g1…gN}计算文本向量集合E={e1…eN};
用相似度(如点积)计算h_audio与E之间的分数;
取top-k得分最高的热词,组成子集G',再拼到LLM-ASR的bias prompt里。
为了让这个检索足够「准」又「稳」,具体训练过程可以参考GLCLAP这篇论文,本文对GLCLAP又做了两方面增强。
RADA:先过滤一次“没必要偏置的词”
Robustness-Aware Data Augmentation(RADA)的设计非常务实:
有些热词,模型其实“已经很熟了”,无需再当成偏置对象,否则只会增加干扰。
做法是:
获取医疗、媒体等领域的庞大热词表(约60万条)作为第一批热词列表;
对每个候选热词g_i:
用TTS合成包含该词的语音;
用当前ASR解码这些语音,看能不能稳定识别出g_i;
如果模型已经能稳定识别这个词,就把它从热词词表里剔除;否则保留。
结果:词表规模从60万缩减到约9.8万。
直观好处:
检索难度显著降低;
减少大量“干扰”的词,后面LLM-ASR也不会被这些词干扰。
模糊匹配:从“死抠字形”到“理解近义变体”
真实场景中,用户说的热词常常不是词表里的标准形式,比如:
说一个药品名,可能有胶囊、颗粒、口服液等。
说一个影片名,可能有第二部、续、新xxx等。
如果训练中的监督只允许严格的字面匹配,检索模型就会对这些变体缺乏鲁棒性。
因此,本文引入了fuzzy matching(模糊匹配策略):
在训练数据中增加多种变体:人为扰动词形,如Tongyi→Tongyi abc等;
这样做的效果:
更贴合真实业务中“词形变动、说法多样”的场景;
检索模型对热词的语义及形态变体更鲁棒。
检索效果:召回率大幅提升
在医疗(Medical)与媒体(Media)两套热词测试集上,增强版GLCLAP的召回改进非常明显。
以医疗测试集为例(top-1 / top-2 / top-5 / top-10):
原始GLCLAP:
23.67% / 29.77% / 39.31% / 42.37%
+RADA(过滤掉易识别热词):
45.80% / 53.44% / 62.98% / 67.56%
+Fuzzy Matching(模糊匹配):
64.89% / 74.43% / 80.54% / 85.12%
媒体测试集也有类似趋势,top-2召回率可达89%。
可以看到:词表清洗+模糊匹配对检索召回帮助非常显著,为后续LLM-ASR的偏置打下了良好基础。
⏩第二阶段:热词感知LLM-ASR与GRPO强化学习
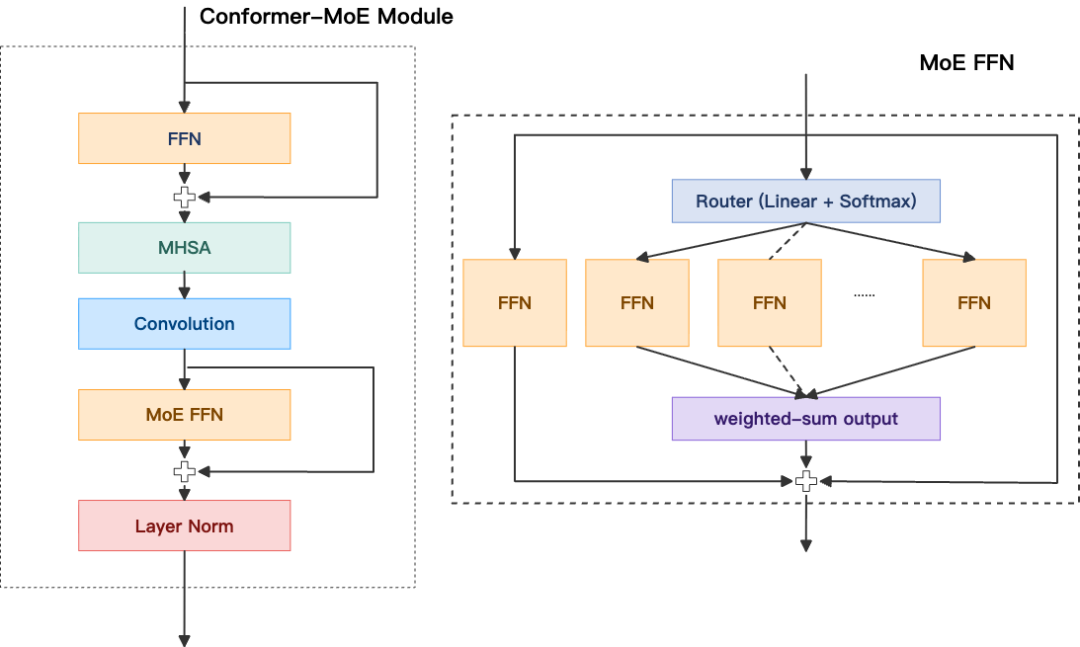
LLM-ASR模型结构:Conformer-MoE + Qwen2.5-7B
模型使用的LLM是基于Qwen2.5-7B,整体结构是典型的LLM-ASR:
前端音频编码器:
CNN下采样+ 20层Conformer-MoE;
每层MoE采用8个专家,路由3-of-8(外加一个共享专家),更好地兼顾多域与复杂声学模式;
编码器输出再经过二次下采样+线性Adapter;
接入Qwen2.5-7B LLM作为解码器;
参数规模约为10.5B总参数,推理时活跃8.7B。
如何把检索到的热词喂给LLM?
对每条语音,在检索阶段得到top-k热词g1, g2, ..., gk后,系统构造一个结构化的prompt,大致形式为:
注意:这里刻意加入了一些“无关/干扰热词”,并非每个都一定出现在语音里。同时,有些sample中 也会出现全是干扰词的情况。
这样做的目的是在训练中逼迫模型学会“辨别真伪”,而不是看到热词就全抄一遍。
GRPO:让模型学会“用对词,不瞎编”
仅靠监督学习,模型容易形成以下错误模式:
热词在prompt里就“强行带上”,导致幻觉;
或者对热词非常保守,宁可不认也不乱认,导致召回不足。
论文采用GRPO(Generative Rejection-Based Policy Optimization)做强化学习,核心是设计一个任务驱动的奖励函数,同时优化:
热词匹配奖励(match reward):
若某个候选热词同时出现在模型输出与参考标注中,或在两者中都不出现,则reward=1;
若只出现在其中一方(漏检或幻觉),则reward=0;
目的:
鼓励正确识别真实热词;
惩罚幻觉式乱用热词。
WER奖励(accuracy reward):
reward = 1 - WER;
兼顾整体转写质量,避免为了热词而牺牲句子准确率。
训练时,每一步生成多个候选转写,用上述奖励进行GRPO更新,使策略逐渐向“既认得出热词,又保证整体准确”的方向收敛。
⏩实验结果:热词更准,句子更稳
不同top-k的效果:k不是越大越好
先看在不加GRPO,只使用增强GLCLAP + LLM-ASR的情况下,不同top-k的表现。
结论非常符合直觉:
检索层面:top-k越大,召回率确实更高;
ASR层面(KER/SACC):
当k太大时,LLM被塞进太多候选热词,干扰增多;
KER与句子准确率并非单调提升,反而出现“过多干扰词导致性能回退”的情况。
综合媒体与医疗两个热词测试集+通用任务集,团队选择了一个较优折中:top-2,即每条语音只给LLM提供2个最相关的候选热词。
加上GRPO:KER大幅下降,句子准确率也提升
在top-2配置下,再加上GRPO强化学习,相比仅增强GLCLAP的结果,提升非常可观:
Media集:
KER:从11.99%降到8.29%;
SACC:从80.57%提升到85.78%;
Medical集:
KER:从15.89%降到11.24%;
SACC:从77.73%提升到84.83%;
General通用任务集:
SACC:从77.36%提升到78.16%,不仅没被热词扰乱,反而略有提升。
可以看到:
在热词核心场景上,关键词错误率显著下降,句子级准确率还更好了;在通用场景上也没有“副作用”,实现了“加偏置不误主业”。
⏩工程与落地视角的一些启发
从工程落地的角度,这篇工作有几个特别值得实践参考的点:
不要盲信“全量热词表”:
用RADA先筛一遍“模型已熟练掌握”的词,再做偏置,能大幅降低复杂度与干扰;
检索与解码要协同设计:
仅有高召回的检索还不够,要与LLM的使用策略共设计,否则容易“给了武器但不会用”;
RL对ASR也非常有用:
传统ASR多用CE/CTC/Transducer等损失,很难直接对接任务级指标;
引入类似GRPO这样的RL方法,可以在“热词识别+句子准确”这样的组合目标上做更直接的优化;
top-k是个关键的“工程超参”:
k太小,召回不足;
k太大,干扰过多;
最优点依赖业务场景、词表质量与LLM容量,需要通过系统性实验来选。
⏩总结与展望
这篇工作为LLM-ASR下的大规模上下文偏置提供了一套相对完整的解决方案:
在检索侧,用RADA +模糊匹配的GLCLAP,从60万热词中精准挑出与当前语音最相关的少量候选;
在解码侧,用结构化prompt + GRPO强化学习,教会LLM-ASR什么时候该用热词,什么时候要拒绝幻觉,以热词匹配+ WER的联合奖励优化整体表现;
在医疗与媒体两大垂类测试集上,实现了明显的KER下降与句子准确率提升,通用任务表现也得到保持甚至略增。
未来可以想象的延展方向包括:
多语言、多口音多场景下的统一偏置框架;
更紧耦合的“检索-解码”联合训练,而非简单两阶段;
将用户个性化、历史上下文等更丰富的信息融入到热词检索与RL奖励中。
对正在做语音大模型、智能客服、会议转写等系统的同学来说,这套“检索+ RL的上下文偏置思路”非常值得借鉴。
如果你在业务中也遇到“我的名字总被认错”的烦恼,不妨尝试把类似的机制引入自己的ASR流程中,也许会有惊喜。
