
 语音小管家
最近一些朋友,包括从事投资方向的朋友,看到我的笔记和文章后,会找我聊语音相关的技术和现状,以及对当前一些技术和应用的看法。今天想分享一下,在我看来,大模型的AI时代,未来在智能语音方向,我只看好两个方向:语音理解和被动语音记录。
基础技术上,语音理解,理解的是数据 应用层面,被动语音记录,从理解数据到理解用户
并不是说其他方向没有机会,而是其他方向相对来说已经有很多人在做。谁都知道语音是最自然的交互方式,自然也会投入资源去研究,然而在语音理解和被动语音记录上,我认为还有跑出来的机会。
而我们目前所做的工作,也主要聚焦在被动语音记录上。
从语音合成说起
Elevenlabs和MiniMax
在语音合成领域,自从大模型在文本领域兴起,国内和国外都出现了两家代表性公司:Elevenlabs和MiniMax。2022年,Elevenlabs成立,其融资情况如下:
2023年1月,第一轮融资200万美元,
2023年6月A轮融资1900万美元,估值1亿美元,
2024年1月B轮融资8000万美元,估值11亿美元,
2025年1月C轮融资1.8亿美元,估值33亿美元。
虽然我们一直认为,国外的语音技术要比国内好很多,但在国内同样在语音合成领域,也跑出了MiniMax。与Elevenlabs相同的是,它们都崛起于大模型带来技术变革的关键时期,在这个时期,大厂也同样是在TTS上投入了很多精力,但是他们还是跑出来了。如果再往前追溯,科大讯飞最早也是以语音合成起家的。
为什么是语音合成
首先,语音合成属于生成式技术,其一对多(输入单一,输出多样)的属性,能让用户最直观地感受到听觉上的冲击。TTS技术,在上一代神经网络时代已经取得了明显进步,尽管现在看起来当时数据量小、模型泛化能力弱,但各大厂商针对不同场景和音色所做的优化,也足以满足商用需求。
在应用层面,随着短视频的兴起,解说、配音、有声读物等场景,在大模型时代之前就已开始大量使用语音合成。这一时期出现了像出门问问的魔音工坊、剪映中的配音等盈利能力很强的产品,它们占据了解说配音市场的很大份额。
语音理解,有希望成为下一个ElevenLabs
相比之下,语音转文字技术则缺乏冲击力和体验感,它本质上是多对一的映射,体验上没有冲击力。无论语音如何变化,从传统语音识别的角度,我们都希望剔除无关因素,转写出相同的文字。
然而,随着大模型时代的到来和逐渐成熟,语音理解的重要性将日益凸显。虽然目前很多头部公司都在重金投入端到端语音对话,但我个人并不看好这个方向(有兴趣的朋友可以参考这篇文章,个人观点。)。相反,我认为应该将更多精力放在语音理解上。
为什么我觉得语音理解领域能跑出一家类似Elevenlabs的公司呢?
基础技术,应用体量足够大
语音识别是语音理解的一个子任务,这意味着什么?意味着未来所有调用语音识别的应用,都将转而调用语音理解技术,而不再需要单纯的语音识别。而且,通过语音理解+高质量语音合成,其体验效果应该不逊于端到端的语音对话。
因此,基于这样的应用前景,我相信语音理解的商业价值不会成为问题。
可行性已被验证
谷歌的Gemini 2.5已经验证了这一方向的可行性和价值。随着用户和应用对体验要求的不断提高,以及算力成本的下降,商业化能力将不是问题。做出Gemini 2.5这样出色的理解能力,谷歌投入的预算、人力和算力无疑是巨大的,他们图的是什么呢?一方面,强大的理解能力,可以赋能他们本身的Gemini生态;另一方面,也能够为其他公司提供API。
而在国内,使用Gemini 2.5做数据蒸馏也已经不是什么秘密,有几家公司敢说自己没有用Gemini 2.5打过标?
具备数据壁垒
要想做好语音理解,必须拥有大量高质量、标注丰富的语音数据。在这个时代,对优质数据的任何投入都是值得的。一旦有公司在早期建立起自己优质的语音数据库,所形成的壁垒是其他公司在短期内难以,或者需要需要付出更高的成本来追赶的。
我更倾向于有一定融资能力和科研背景的创业公司去尝试这个方向,因为它真的需要很多资金、资源和人才。甚至也不需要担心大公司的竞争,Elevenlabs不也同样在群雄林立的时代跑出来了吗?大公司的问题在于,在没有商业上的成功之前,绝大多数公司不会All In,而且这仅仅是他们一个甚至可以用“微不足道”来形容的子业务,他们仅仅是在“尝试”,而这也是其他公司的机会。
被动语音记录
除了“记录”,这里特别强调了一个词——“被动”。记录可以分为主动记录和被动记录:
主动记录需要用户主观发起,如拍照、录音(会议记录)都可视为用户主动行为。 被动记录则无需用户主动选择,它会自动采集许多当前看似“无用”的信息,从而降低用户记录的门槛。
用额外工具延伸手机功能
被动记录能够降低用户的使用和思考成本,但通常需要一个额外的记录工具,以扩展手机的能力边界,为用户开辟新的“24小时”。它可以避免主动记录存在的滞后性和用户惰性,结合AI能力,随时随地为用户提供所需的数据信息。
可以看到,这类产品已经开始逐渐投入市场,跃跃欲试,其中也包括我们,最终会收敛到什么形态还有非常大的探索空间,有风险但更有机会,创新的产品需要市场更高的容忍度,成功需要天时地利人和。
为理解提供充足的上下文
如果不配备相应的能力,或者AI能力不达标,记录本身的价值就很有限。就像我们存储了大量照片,但其中大多数可能再也不会被查看,这样的数据就没有价值。
在大模型时代,个性化AI是趋势。实现个性化AI既需要模型能力,也需要收集足够多的用户上下文。举个例子,如果一个人能将自己所有的工作过程、会议记录都存入一个知识库,那对他后续的工作将大有裨益。事实上,现在的AI录音笔正在做这件事。
从理解数据到理解用户
如果说语音理解是理解数据,那么长期被动记录的最终目的,就是理解用户。对数据的理解能力的提高,必然会增强对用户的理解,二者相辅相成。缺乏真实、有效、长周期的数据,是绝对无法做好用户理解的。而无法理解用户,就更谈不上实现个性化的计划、助手和交互等功能。
被动记录的挑战
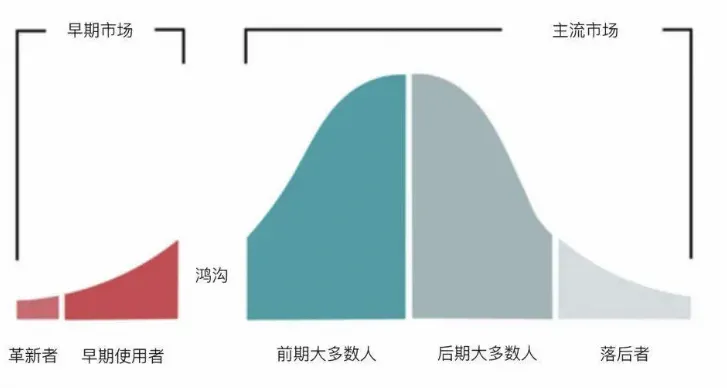
同样,被动记录目前仍面临不少挑战,包括功耗、算力、隐私等问题,都需要妥善解决。但在一定程度上,利用现有技术是可以尝试逐步突破。这类产品,目前还停留在革新者和早期使用者上,如何“跨越鸿沟”[杰弗里·摩尔 Geoffrey A. Moore《跨越鸿沟》],需要技术、产品和市场的一起努力。
最 后
从数据理解到对用户的理解,这里面不仅仅是语音技术,更重要的是理解基础模型的不断迭代。以这两个方向为基础,还可以在不同场景中,衍生出大量相关的工作,首先就是数据工程,还有各种各样“有用没用”的智能硬件,包括具身智能相关的多模态记录和感知理解。无论是做研究、产品,还是投资,面对复杂多变的表象,最重要的是把握一些更底层的核心逻辑。
