
 语音小管家
跨语言情感语音合成(Cross-lingual Emotional Speech Synthesis)旨在在不改变语音语言内容信息的前提下,将源语言语音中的情感特征自然迁移到目标语言的合成语音中。这一技术在电影配音、多语言虚拟人等场景中有着重要的应用价值。然而,现有方法往往依赖大规模平行情感语料,难以适配低资源语言,并且在情感迁移过程中容易引入外语口音,缺乏对情感强度的精细控制。
近期,西北工业大学音频语音与语言处理研究组(ASLP@NPU)与爱奇艺联合发表的论文 “XEmoRAG: Cross-Lingual Emotion Transfer with Controllable Intensity Using Retrieval-Augmented Generation” 被语音领域的重要国际会议 ASRU 2025 接收。该论文提出了一种基于检索增强生成(RAG)与流匹配对齐(Flow Matching)的跨语言零样本情感迁移语音合成框架——XEmoRAG,能够在无需平行情感数据与显式情感标签的情况下,从中文参考语音生成富有情感且自然流畅的泰语语音,并支持多档情感强度控制。现对该论文进行简要的解读与分享。
论文题目:XEmoRAG: Cross-Lingual Emotion Transfer with Controllable Intensity Using Retrieval-Augmented Generation
合作单位:爱奇艺
作者列表:左天伦,胡景斌,李玉珂,朱新发,李海,闫影 ,刘俊晖,谢丹铭,谢磊
论文链接:https://arxiv.org/pdf/2508.07302
跨语言情感语音合成旨在将一种语言中带有情感的语音转换为另一种语言的自然、富有表现力的语音,并保持情感一致性。这在电影配音、多语言虚拟人等场景中有重要价值。
然而,当前方法存在三大难题:
缺乏平行情感语料——尤其是低资源语言(如泰语),难以直接训练跨语言情感迁移模型。
外语口音问题——直接迁移情感时会引入非母语韵律特征,导致合成语音带有外语口音。
情感控制不足——现有模型缺乏对情感强度的精细可控能力。
针对上述问题,西北工业大学音频语音与语言处理研究组(ASLP@NPU)与爱奇艺联合提出XEmoRAG框架,实现从中文到泰语的零样本情感迁移合成,无需情感标签与平行数据,并支持情感强度控制。
XEmoRAG 主要包括三大核心设计:检索增强生成(RAG)情感提示、流匹配(Flow Matching)韵律对齐和两阶段微调。
检索增强生成(RAG)情感提示
为了证明基于 Emo2Vec[1] 模型的情感嵌入的跨语言泛化能力,我们使用 t-SNE 图对其分布进行了可视化。如图1所示,当中文和泰语语句联合投影时,它们的情感嵌入形成了高度一致的聚类,表明其具有语言无关的结构。此外,图1分别显示了中文和泰语语句的情感聚类,它们具有相似的形状和边界,这表明 Emo2Vec 嵌入在不同语言中具有鲁棒性。这种跨语言一致性证明了这些嵌入可用于零样本环境下的情感检索。
使用预训练Emo2Vec模型提取语言无关的情感嵌入,从中文参考语音中获取情感表示
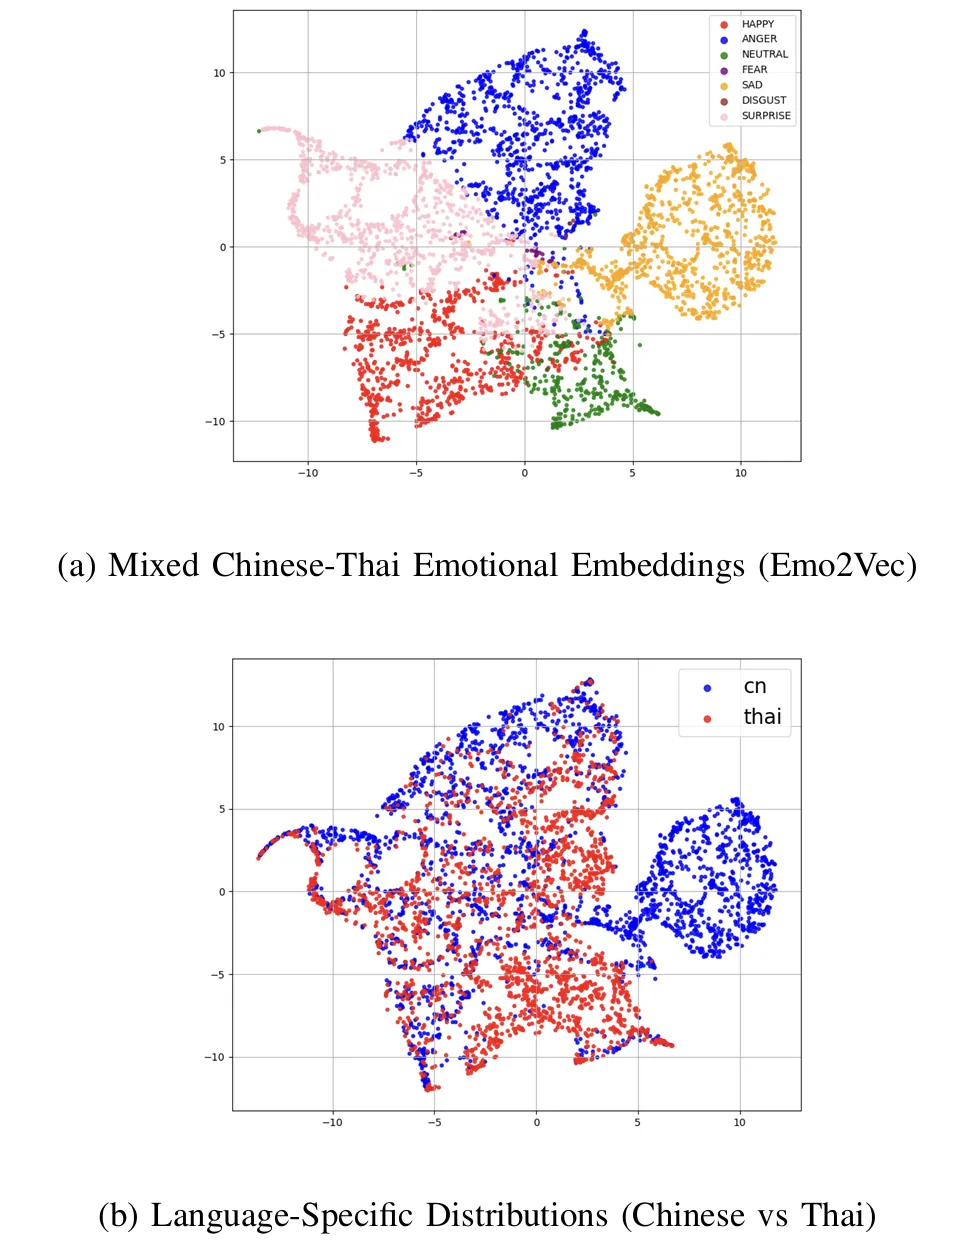
图1 Emo2Vec 提取的情感表征的 t-SNE 可视化
给定一个无情感标签的中文参考语音,我们首先使用预训练的 Emo2Vec 模型提取一个语言无关的情感嵌入。接下来,我们对精选的泰语情感话语库进行基于相似度的检索,以识别与参考情感最匹配的样本。为了增强检索的多样性并丰富合成语音的情感表达能力,我们采用了基于聚类的检索策略。具体来说,我们使用反映情感接近度的距离度量,对 Emo2Vec 从泰语话语库中提取的情感嵌入应用 K 均值聚类。然后,检索到的话语在推理过程中作为韵律提示,使模型能够生成保留原始中文参考语音情感特征的泰语语音,而不会产生不自然的外国口音。
支持弱/中/强三档情感强度控制,推理时仅从对应强度子集检索。
该策略不仅能够实现准确的跨语言情感传递,还能对生成语音的情感强度进行多层次控制。它有助于合成更符合参考语料预期表达风格的泰语语音,同时保持韵律的自然性,并避免不自然的外国口音。
流匹配(Flow Matching)韵律对齐
采用 Transformer-UNet,通过学习追踪目标梅尔谱图的矢量场来对齐标记序列的分布。对齐文本与声学特征,减少音高与时长不匹配问题。该模型集成了时间嵌入、残差下/上采样块和 16 头自注意力机制,以增强语音信号的全局建模。我们基于此设计了该结构,以解决以下两个关键问题。
首先,为了解决语音标记与梅尔特征之间的帧率不匹配问题,我们使用线性插值将语音标记上采样 1.6:1 倍,使其帧率与梅尔谱图的帧率对齐。
同时,为了进一步增强生成多样性和说话人控制,我们以说话人参考嵌入为条件对模型进行调整,旨在增强跨源说话人和目标说话人音色特征的建模能力。
将由 X-Codec2 标记器生成的、富含语义和声学信息的离散标记表示映射到表示目标语音表示的梅尔谱图。并且,通过最小化预测向量与相应真实向量之间的 L1 损失来优化 UNet 参数。
这种基于流的对齐策略减少了合成过程中的音高和时长不匹配,从而提高了韵律的自然度。通过联合建模语义内容、声学结构和说话者音色,我们的方法支持高质量且可控的语音重建,非常适合多语言场景中的情感语音合成。
两阶段微调
核心框架是 Llasa[2],这是一个基于 Transformer 的文本转语音框架。通过采用自回归下一个标记预测的方式,它用一个统一的、仅解码器的模型取代了传统的多阶段 TTS 流程,该模型可以预测离散的声学标记,从而在 LLM 框架内实现端到端的语音生成。我们使用 Llasa-1B-Multilingual 版本,这是一个基于多语言语音数据训练的 1B 参数模型,可以实现跨多种语言的灵活自然的合成。首先使用 X-Codec2 将语音波形编码为离散的标记表示,X-Codec2 是一个强大的标记器,它通过单层矢量量化器融合了语音的语义和声学特征。这些离散的token与相应的文本输入配对,构成了Transformer学习建模的联合输入-输出空间。
阶段 1:在 1000 小时非情感泰语语料上训练,掌握泰语声学特征
阶段 2:在 60 小时泰语情感语料上微调,实现情感表达能力。
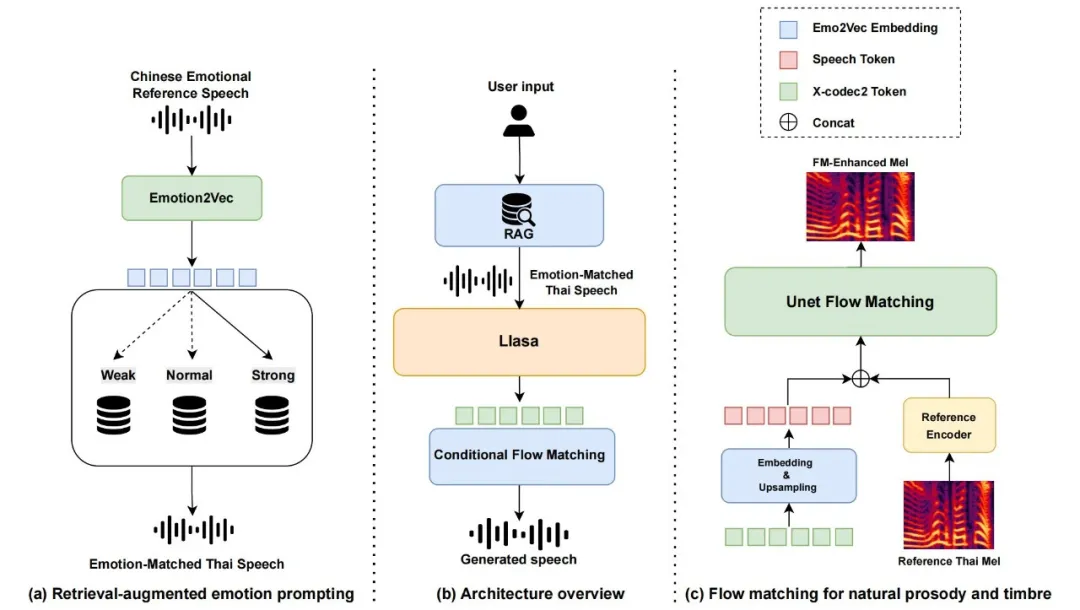
图2 XEmoRAG整体结构
数据集:1000h 泰语非情感数据 + 60h 泰语情感数据。
对比模型:
Typhoon2-Audio 8B Instruct[3]:一个统一的端到端大规模模型,拥有数十亿个参数,涵盖从语音理解到语音生成的整个流程。它支持传统的语音合成 (TTS) 以及跨语言情感传输等复杂任务。该模型针对泰语进行了优化,非常适合泰语文本转语音合成。
DelightfulTTS[4]:DelightfulTTS 实现使用非自回归预测编码 (NAP) 模块进行口音建模,并使用分层 HuBERT 嵌入进行跨语言情感传输。
主观评价(MOS):
情感相似度 EMOS:4.65(优于 DelightfulTTS 的 3.89)
自然度 NMOS:4.38(与 4.41 持平)
客观评价:
说话人相似度 SIM:0.89(最高)
字符错误率 CER:5.95%(最低)
表1 主客观评测
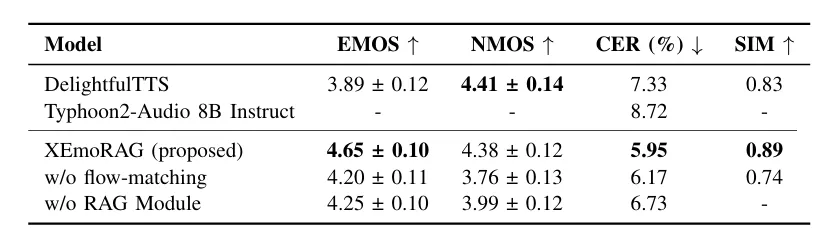
消融实验:去掉 Flow Matching 或 RAG模块都会显著降低情感相似度与自然度。
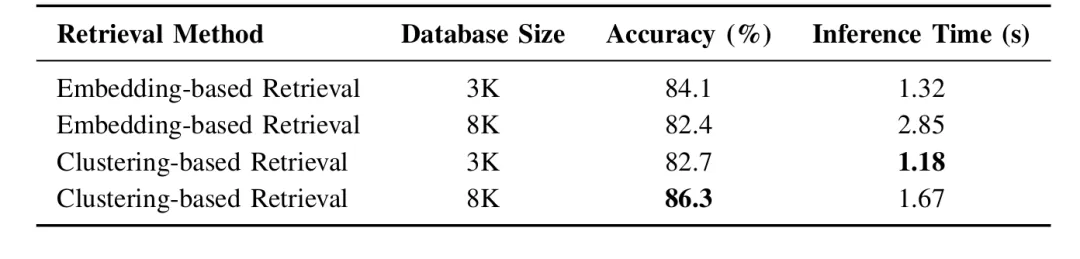
检索策略对比:在 8K 数据库规模下,聚类检索在精度(86.3%)与延迟(1.67s)上优于余弦相似度检索。
表2 检索策略对比结果
[1] Shuo Wang, Aishan Maoliniyazi, Xinle Wu, and Xiaofeng Meng, “Emo2vec: Learning emotional embeddings via multi-emotion category,”ACM Transactions on Internet Technology (TOIT), vol. 20, no. 2, pp. 1–17, 2020
[2]Zhen Ye, Xinfa Zhu, Chi-Min Chan, Xinsheng Wang, Xu Tan, Jiahe Lei, Yi Peng, Haohe Liu, Yizhu Jin, Zheqi DAI, et al., “Llasa: Scaling traintime and inference-time compute for llama-based speech synthesis,”arXiv preprint arXiv:2502.04128, 2025.
[3]Kunat Pipatanakul, Potsawee Manakul, Natapong Nitarach, Warit Sirichotedumrong, Surapon Nonesung, Teetouch Jaknamon, Parinthapat Pengpun, Pittawat Taveekitworachai, Adisai Na-Thalang, Sittipong Sripaisarnmongkol, et al., “Typhoon 2: A family of open text and multimodal thai large language models,”arXiv preprint arXiv:2412.13702, 2024
[4] Yuke Li, Xinfa Zhu, Yi Lei, Hai Li, Junhui Liu, Danming Xie, and Lei Xie, “Zero-shot emotion transfer for cross-lingual speech synthesis,” in2023 IEEE Automatic Speech Recognition and Understanding Workshop (ASRU). IEEE, 2023, pp. 1–8.
