
 语音小管家
作为语音相关研究领域的旗舰国际会议,ASRU2025(IEEE Workshop on Automatic Speech Recognition and Understanding)将于12月6-10日在夏威夷檀香山举办。IEEE ASRU2025的主题为“Towards the New Era of Speech Understanding”(迈向语音理解的新时代)。
本期分享上海交通大学听觉认知与计算声学实验室中稿的6篇论文,论文方向涵盖语音合成、分离、增强等。
01、Improving Speech Enhancement with Multi-Metric Supervision from Learned Quality Assessment
通过多维度语音质量评估提高语音增强模型可用性
论文作者:王巍,张王优,李晨达, 史嘉彤,Shinji Watanabe,钱彦旻
完成单位:上海交通大学,卡耐基梅隆大学
论文亮点:
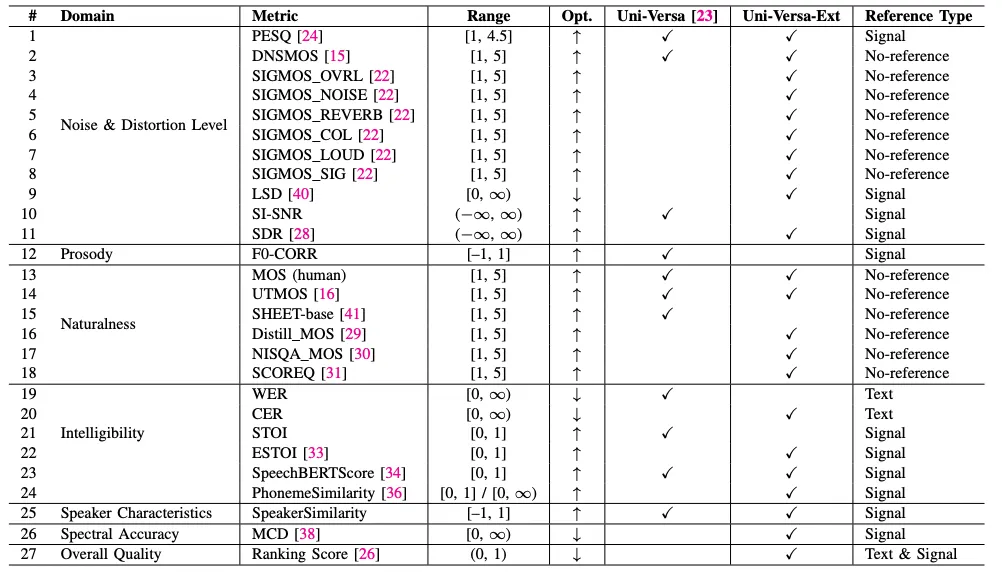
本论文提出了多指标音频质量评估模型 Uni-VERSA-Ext,并将其应用于语音增强模型的训练中。Uni-VERSA-Ext 预测的 MOS 分数在语音增强和合成数据集上与人类打标的 MOS 分数达到了 SOTA 相关性。通过 Uni-VERSA-Ext 的多指标监督,提升了增强语音在多个下游任务中的表现。此外,Uni-VERSA-Ext 还作为 URGENT 2026 挑战赛赛道 2 的基准模型。
相关代码和模型已开源:https://github.com/urgent-challenge/urgent2026_challenge_track2
论文简介:
语音增强旨在从噪声或其他失真语音中恢复清晰、可理解且听觉质量较高的语音。传统基于深度学习的 SE 方法,通常使用信号级别损失函数,在仿真数据上训练。这种训练方式局限于局限:
对真实世界语音泛化能力差: 许多真实场景下没有 clean 参考信号,使得传统监督训练难以应用。
与人类感知主观质量不对齐: 信号级别目标与最终通过主观听感 (MOS) 所评价的语音质量往往不一致,导致增强后语音在主观评估或感知质量上不理想。
语音质量评估模型已经被广泛用于作为语音增强系统的评价工具,用于估计噪声、失真、清晰度、自然度等。本论文提出了一种新的训练框架:首先基于一个多指标语音质量评估模型 (multimetric SQA) UniVERSAExt将其预测的多种语音质量指标 (包括感知质量、清晰度、说话人一致性、噪声/失真程度等) 作为可微监督信号用于训练语音增强模型。这种做法带来了几方面优势:
一些广泛使用不可导的传统评价指标通过语音质量评估模型得到近似,从而可以直接用于梯度优化。
减少对仿真数据的依赖,使得真实数据可以用于训练,从而提高模型在真实噪声场景适用性。
多指标、多维度的质量评估使增强模型能够兼顾多个感知目标,不再局限于单一信号级目标。
基于此,该论文首先对原始 UniVERSA 模型进行了扩展 (训练数据量更大、覆盖指标更多),得到 UniVERSAExt,然后设计了将其嵌入到增强训练流程中的策略,并在仿真和真实数据集上验证了其有效性。
该研究通过将“多指标质量评估模型 + 可微监督”这一组合引入语音增强训练中,提出了一条新的研究路径。它对于提升增强语音在主观感知质量、清晰度、说话人一致性、噪声抑制效果等多个维度的表现具有现实意义,也为在真实数据上训练增强模型提供了实用方案。
02、URGENT-PK: Perceptually-Aligned Ranking Model Designed for Speech Enhancement Competition
为语音增强比赛设计的感知对齐的语音排名模型
论文作者:王嘉禾,李晨达,王巍,张王优,Samuele Cornell,Marvin Sach,Robin Scheibler,Kohei Saijo,付艺辉,倪兆衡,Anurag Kumar,Tim Fingscheidt,Shinji Watanabe,钱彦旻
完成单位:上海交通大学,卡耐基梅隆大学,布伦瑞克工业大学,Google DeepMind,早稻田大学 ,Meta
论文亮点:
文中设计了一种全新的基于成对比较(Pairwise Comparison)的系统级语音质量评估(Quality Evaluation)范式,突破了传统MOS预测模型的局限性。其创新点包括:
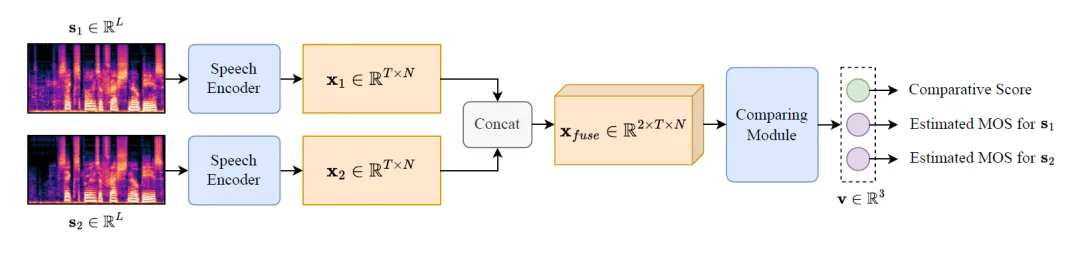
基于成对比较的系统级语音质量评估范式:模型接收两个同源增强语音作为输入,并对它们进行比较,预测哪一条语音质量更高,而非直接估计绝对MOS分数。
系统级排名算法:文中提出了一种基于枚举-比较-积分(Enumerating-Comparing-Scoring,简称ECS)的系统级排名算法,通过对所有系统的输出结果两两比较并累积得分,实现对多个语音增强系统的可靠排名。
多任务学习(Multi-task Learning)与感知对齐:模型同时训练比较任务和MOS预测任务,通过引入人类听觉感知知识,提升了模型的泛化能力和鲁棒性。
数据清洗策略:考虑到训练时使用的标签MOS分数可能存在波动,文中引入了一个MOS差异阈值(δ=0.3)来过滤训练数据对,剔除质量相近的语音对,提升模型的训练效果。
轻量级架构与强泛化能力:即使使用简单的Log-mel频谱编码器和基于ResNet34比较模块,URGENT-PK 在多个跨语言、跨领域测试集上仍优于如UTMOS、DNSMOS等复杂的模型,显示出优异的泛化性能。
论文简介:
本论文提出了一种名为URGENT-PK的语音质量评估模型,专门用于语音增强竞赛中的系统级排名。传统MOS预测模型依赖大量人工标注,且易受主观偏差和领域偏移的影响,导致模型训练困难。URGENT-PK通过成对比较的新的范式成功缓解了以上固有短板。
模型由两部分构成:话语级成对比较模型(Utterance-level Pairwise Model)和系统级排名算法(System-level Ranking Algorithm)。前者首先使用语音编码器(论文中使用了Log-mel 频谱和UTMOS模型的特征提取部分)提取语音特征,再通过基于ResNet34的比较模块(Comparing Module)生成比较分数(Comparative Score)和估计MOS。后者通过ECS排名算法遍历所有系统对,对所有系统积分以确定最终排名。
实验部分,模型在Urgent Challenge 2024(英语)数据集上进行了训练,并在Urgent Challenge 2025(多语种)和CHiME-7 UDASE数据集上进行验证。结果表明,URGENT-PK模型在系统级排名任务中全面优于UTMOS和DNSMOS等基线模型,尤其在跨语言和跨领域场景下表现出更强的泛化能力。此外,主观对比测试(A/B Test)进一步验证了模型在语音对比较中任务中的高准确率。
论文中还进行了多项消融实验,首先进行了模型MOS预测能力的评估,将成对比较模型转换为传统的语音质量评估模型,达到了与专用MOS预测模型相当的性能,这证明URGENT-PK模型通过多任务学习成功掌握了人类对语音质量的感知知识。其次,文中还进行了数据清洗阈值的影响分析:过低或者过高的MOS差异阈值δ都会对实验结果带来负面影响,文章选取的最优折衷方案在保证数据质量和数据量之间达到了最佳平衡。
URGENT-PK 的核心贡献在于将语音质量评估从绝对分数预测转向相对比较,显著降低了对标注数据的依赖,同时在系统排名任务中实现了更优的鲁棒性和可推广性。
03、StellarTTS: Sparse Temporal Embedding for Low-Latency and Robust Speech Synthesis
StellarTTS:面向低延迟和鲁棒性的稀疏时间嵌入语音合成
论文作者:罗凯成,龚雪飞,孙玉涛,何金玲,侯宇杰,邢晓羊,李卉艳,韩冰,钱彦旻
完成单位:荣耀,上海交通大学
论文亮点:
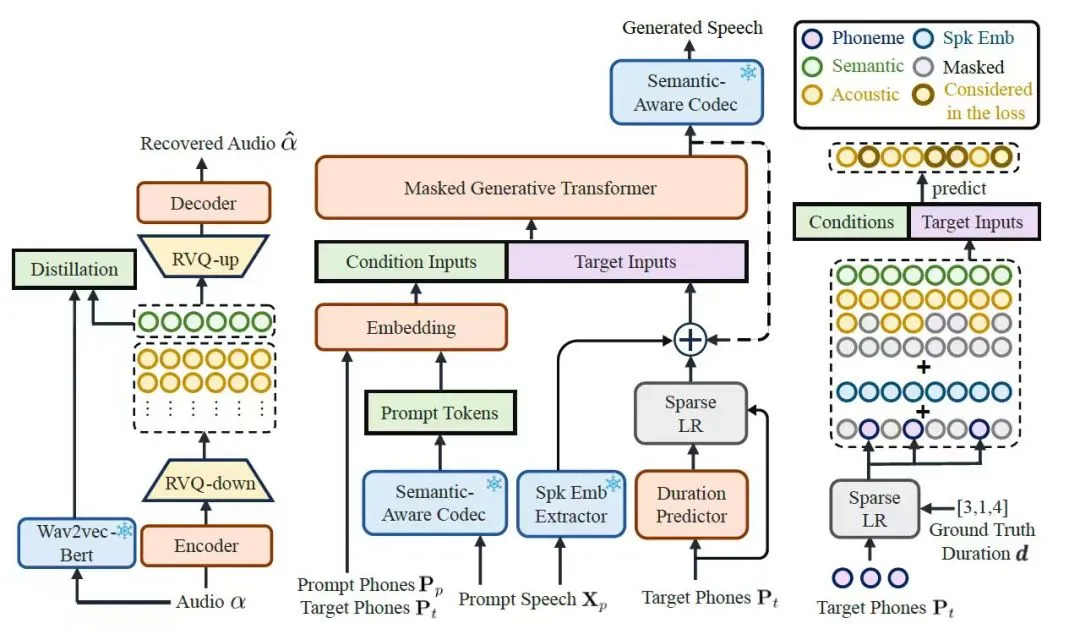
StellarTTS通过创新的稀疏时间嵌入和语义感知编解码器,成功地解决了非自回归TTS模型在韵律、鲁棒性和效率上的核心挑战。它不仅为移动端部署提供了高性能、低延迟的语音合成解决方案,也为如何平衡模型生成质量与计算成本提供了宝贵的实践思路,展示了其在需要实时响应和资源高效的工业级应用中的巨大潜力。
论文简介:
当前的文本到语音(TTS)系统普遍面临着在鲁棒性、延迟和韵律自然度之间的艰难权衡。自回归(AR)模型虽然保真度高,但速度慢且容易出错;非自回归(NAR)模型速度快,却常常因为依赖僵化的对齐机制而牺牲韵律的生动性。特别是在移动端等资源受限的设备上,如何部署一个既快又好,还能灵活控制的TTS系统,是业界一大挑战。针对以上痛点,来自荣耀和上海交通大学的研究者们共同提出了StellarTTS,一个专为移动端优化的新型非自回归TTS框架。该框架通过一系列创新设计,在低延迟、强鲁棒性和高韵律自然度之间取得了出色的平衡。StellarTTS在延迟和鲁棒性方面均优于SOTA模型,同时在音质、韵律和说话人相似度上保持了极具竞争力的表现,特别是在处理重复词、绕口令等复杂文本时表现突出。
04、Advancing Controllable Music Generation with Latent Rectified Flow Guided by Rhythm and Harmony
利用节奏与和声引导的隐空间重整化流推进可控音乐生成
论文作者:于海彬,周佳依,王巍,王志铭,祝慧佳,钱彦旻
完成单位:上海交通大学, 蚂蚁集团
论文亮点:
本文针对音乐生成领域细粒度音乐结构控制困难的核心挑战,提出了创新性的解决方案。核心亮点在于引入了基于ControlNet的外部控制机制,将节奏与和声两种最关键的音乐结构信号精确地注入到生成流程中。实验证明,这种双重控制方法有效解决了现有模型在节拍对齐和和弦走向上的不确定性,显著提升了音乐生成的可控性和性能指标。同时,本文采用高效的重整化流(Rectified Flow)作为生成模型的基干结构,在实现精细控制的同时,保证了基干模型的生成性能。
论文简介:
尽管当前的音乐生成(Text-to-Music)模型在生成整体听感上已取得了长足进步,但无论是依赖迭代采样的Diffusion模型还是参数庞大的LLM模型,在精细音乐结构控制,如精确的节奏对齐和明确的和声走向方面,仍存在尚待解决的问题。
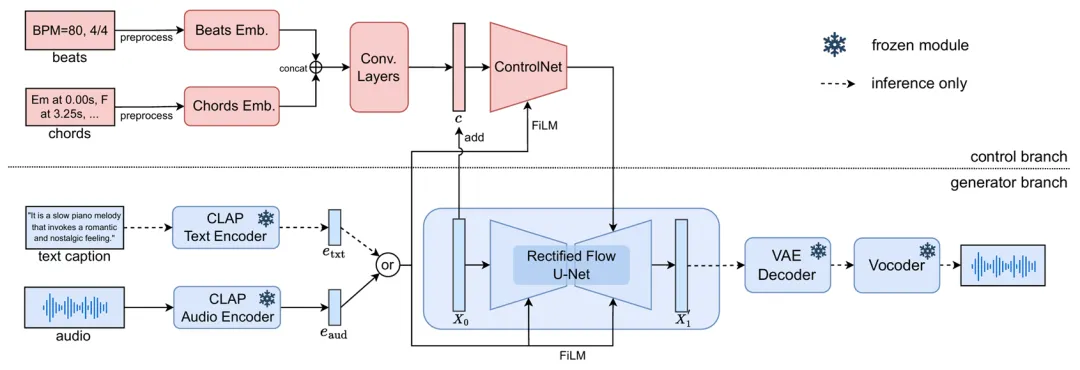
为突破这一瓶颈,本研究提出了一套以增强可控性为核心的音乐生成框架。我们引入了以下控制机制:
1. 节奏控制信号:精确指导模型在时间维度上对齐强拍和弱拍,确保音乐的律动结构准确。
2. 和声控制信号:提供预设的和弦序列,保证旋律和伴奏在调性上保持一致,并实现用户定义的复杂和声色彩。
我们将这两种外部控制信号通过ControlNet机制(一种在生成模型中注入条件信息的有效方法)融入到核心生成架构中。我们选择重整化流作为生成模型骨干,它利用常微分方程(ODE)和线性插值原理,相较于传统的Diffusion模型,能以流形空间内线性度更高的轨迹完成采样,为实现高效且可控的生成提供了稳定基础。
实验结果表明,集成了节奏和和声控制的MusicLRF+Control模型在遵循用户定义的音乐结构方面的表现得到显著增强,尤其在多个客观和主观指标上超越了未施加控制的多个基线模型,证明了该双重控制机制的强大有效性。未来,我们将继续利用本研究的洞见,致力于开发更灵活、更强大、更能够满足专业创作者需求的大规模可控音乐生成模型。
05、OOQ: Outlier-Oriented Quantization for Efficient Large Language Models
OOQ:基于离群值的高效大模型量化压缩方法
论文作者:王浩宇,刘贝,邵航,肖博,曾柯,万广鲁,钱彦旻
完成单位:上海交通大学,美团
论文亮点:
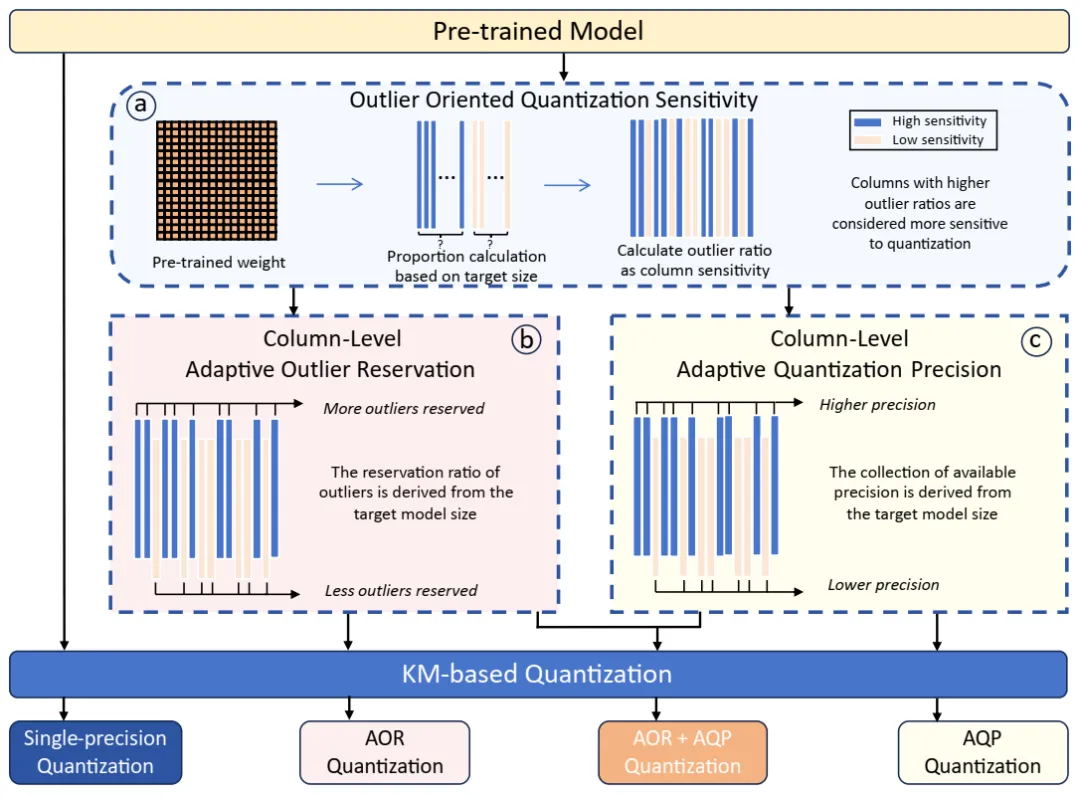
本研究首次提出面向离群值的大模型量化框架(OOQ),创新性地设计了基于离群值比例的信道级量化敏感度指标,为精度分配和离群值保留提供统一指导。核心创新包括:提出 K-Means 聚类量化策略,动态生成贴合参数分布的量化质心,减少信息损失;引入自适应量化精度(Adaptive Quantization Precision, AQP),按离群值密度为不同信道分配差异化比特宽度;设计自适应离群值保留(Adaptive Outlier Reservation, AOR)策略,为高敏感信道预留更多全精度离群值。实验表明,OOQ 在 LLaMA 系列模型的 2-4 比特量化场景中均实现 SOTA 性能,尤其在 2 比特超低比特场景下大幅超越现有方法,同时推理速度提升最高24%,兼顾压缩效率与模型精度。
论文简介:
大语言模型(LLM)的参数量化是降低存储开销、提升部署效率的关键技术,但现有方法在 4 比特及以下低比特量化场景中易出现显著性能退化。现有量化方法或采用固定精度分配,或未充分考虑离群值分布的信道差异,难以平衡压缩比与模型性能。为此,本研究提出离群值导向量化(OOQ)框架,以信道级离群值比例作为量化敏感度指标,核心思路是为对量化更敏感的高离群值信道分配更多量化资源。该框架整合三大关键技术:K-Means 聚类量化,精准拟合参数分布生成质心;自适应量化精度(AQP),根据目标压缩比动态分配 2-4 比特精度;自适应离群值保留(AOR),按离群值密度差异化保留全精度参数。基于 LLaMA 系列模型,在 WikiText2、C4 数据集及多个零样本基准测试中验证表明,OOQ 在不同比特设置下均优于 GPTQ、AWQ 等现有方法,尤其在 2-3 比特超低比特场景中性能提升显著,同时实现最高 24% 的推理加速。该研究为资源受限环境下的 LLM 高效部署提供了新方案,突破了低比特量化的性能瓶颈。
06、Less is More: Data Curation Matters in Scaling Speech Enhancement
Less is More:数据筛选是大规模语音增强模型训练的关键
论文作者:李晨达,张王优,王巍,Robin Scheibler,Kohei Saijo,Samuele Cornell,付艺辉,Marvin Sach,倪兆衡,Anurag Kumar,Tim Fingscheidt,Shinji Watanabe,钱彦旻
完成单位:上海交通大学,Google DeepMind,早稻田大学,卡耐基梅隆大学,布伦瑞克工业大学,Meta
论文亮点:
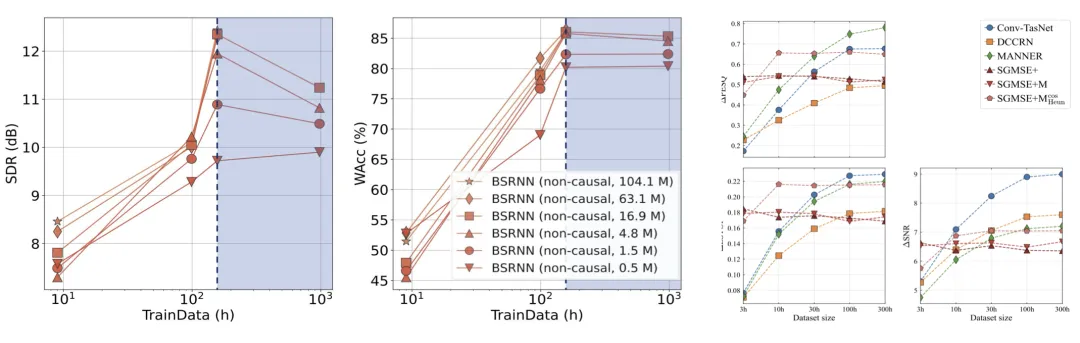
在语音增强研究中,常见的假设是:更大的数据集能够带来更好的模型性能。然而,我们的最新工作表明,数据的数量并不是唯一关键因素,数据质量在大规模训练中起着更为决定性的作用。在语音增强的规模化研究中,合理的数据筛选比单纯的数据扩展更能提升模型性能。
论文简介:
研究背景
语音增强(Speech Enhancement, SE)是语音处理的重要基础技术,应用于助听器、语音通信和智能设备等场景。
深度学习方法推动了 SE 的快速发展,但在大规模数据集上,性能提升往往出现“边际递减”[1,2]。
在 URGENT2025 挑战赛中[3],参赛队伍提交的60,000 小时的训练数据并未显著优于 2,500 小时的数据集,这提示我们需要重新审视“数据规模定律”。
研究方法
我们针对 URGENT2025 的 2,500 小时训练集进行了系统分析,发现部分“clean”标签存在噪声、失真或多说话人等问题。为此,我们提出了两步数据筛选策略:
1. 阈值过滤(Threshold-Based Filtering, TBF)
使用多种非侵入式指标(DNSMOS、NISQA、UTMOS、SIGMOS、SQUIM-SDR 等)对语音质量进行评估。
针对不同数据源设定差异化阈值,剔除低质量样本。
最终得到约 700 小时的高质量数据子集。
2. 质量排序(Quality Ranking)
在 700 小时数据中进一步进行质量排名,形成 100h、350h、700h 三个子集。
与随机采样的同规模数据进行对比实验。
主要发现
质量优先于数量:判别式模型(BSRNN)和生成式模型(BSRNN-Flow)均显示,700 小时精选数据集在多项非侵入式指标上优于 2,500 小时完整数据集。
小规模高质量数据的优势:部分情况下,100 小时的高质量数据甚至超过了大规模训练的结果。
初始化策略的有效性:先用大数据预训练,再用精选数据微调,可以进一步提升性能。
实验室介绍
上海交通大学听觉认知与计算声学实验室(SJTU Auditory Cognition and Computational Acoustics Lab, AudioCC Lab),由教育部长江学者,计算机学院特聘钱彦旻教授领导,集结了一支由青年教师、博士生、硕士生、本科生以及专职科研等组成的近五十人研究团队。该实验室专注于完整的听觉人工智能与计算声学领域相关技术的研究,力求用计算和智能的方法重点解决语音,音频,音乐,自然声信号等听觉相关技术挑战并构建高效系统。涵盖智能语音处理、音乐与音频生成、自然语言理解和多媒体信号分析等方向。
实验室的研究工作得到了国家脑科学计划、国家重点研发计划、国家自然科学基金等国家级和来自腾讯,蚂蚁,美团,荣耀等企业级项目的资助。实验室可调动丰富的数据资源以及多达百块最先进GPU卡的丰富计算资源,包括A100,H800,4090,A10等,可以做产业级和大规模的人工智能技术研究。近5年,在国际期刊和会议上发表了数百项学术成果。实验室业余活动丰富,成员全面发展,毕业生均前往国内外顶级企业和研究机构就业或深造。
实验室学术氛围浓厚、研究成果丰硕、业余活动丰富、就业前景良好。诚挚欢迎优秀学生加入实验室。
联系方式
有意者请将个人简历邮件发送至 fang.nan@sjtu.edu.cn
编辑:方楠;审核:钱彦旻
