
 语音小管家
论文题目:《Train Short, Infer Long: Speech-LLM Enables Zero-Shot Streamable Joint ASR And Diarization On Long Audio》
arXiv链接:https://arxiv.org/pdf/2511.16046
01、先搞懂背景:我们要解决啥问题?
级联系统(比如先做ASR再做分割):前面步骤错了,后面会跟着错(比如ASR把“张三说的话”转错了,分割再准也没用);
短音频端到端模型(比如Sortformer、Meta-Cat):得分别训ASR和分割的编码器,而且只能处理20秒以内的音频,长音频的“全局说话人一致性”搞不定(比如同个人在不同片段被标成“speaker1”和“speaker2”);
LLM辅助模型(比如DiarizationLM):得先有独立的ASR和分割结果,再用LLM后处理,不是端到端的,还不能实时流式推理。
02、核心创新:JEDIS-LLM是怎么设计的?
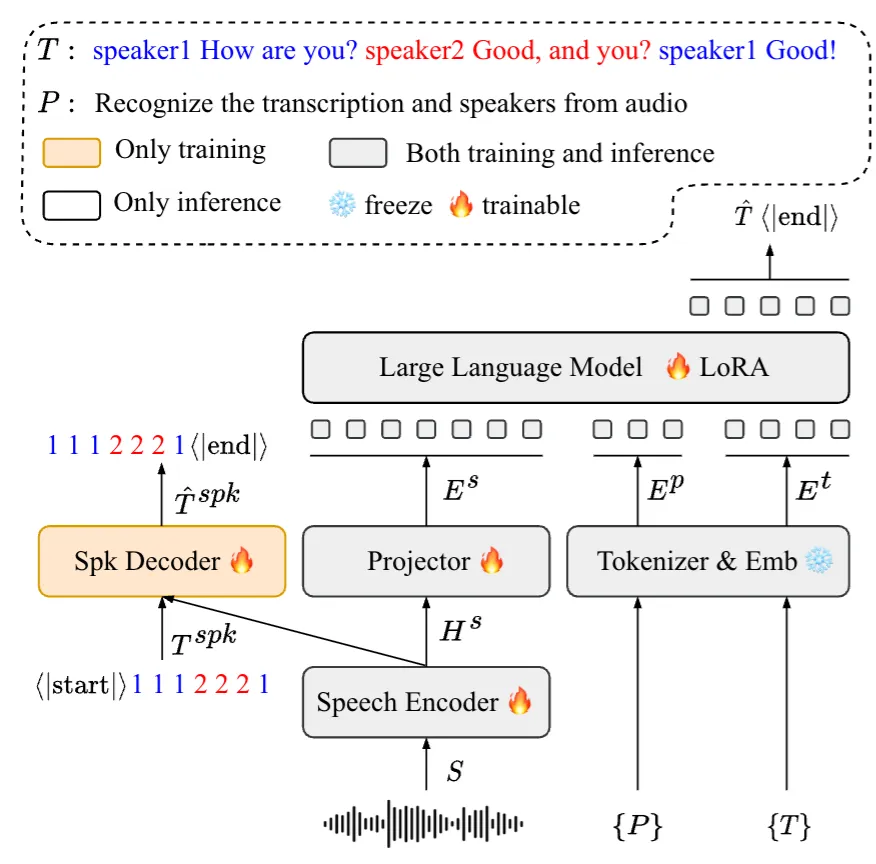
语音信号先过Speech-Encoder生成特征,再用Projector映射成LLM能读的格式(叫Es); 文本提示(比如“请转录并标注说话人”)和目标结果(带说话人ID的转录文本),先分词再转成embedding(Ep和Et); 把Es、Ep、Et拼起来喂给LLM,让LLM预测带说话人ID的转录文本,损失用交叉熵(LLLM); 还加了个LoRA(α=32,rank=16),不用全量训LLM,省算力。
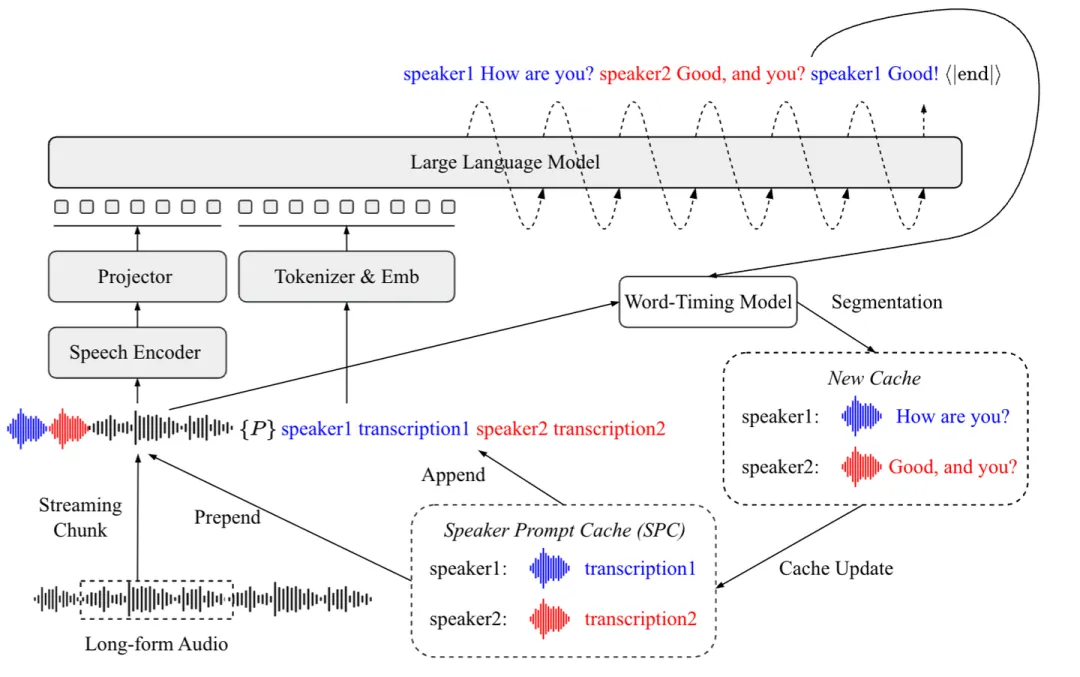
如果是第一次处理(SPC空),直接用当前音频块+基础提示推理; 如果SPC有内容,就把缓存里的所有音频拼在当前块前面,缓存的转录文本拼在提示后面,让LLM“看着之前的说话人信息”来预测当前块,自然就保持ID一致了。
先用“Word-Timing Model”(强制对齐模型)把当前块里每个说话人的音频片段拆出来; 挑最长、无重叠的片段(文本至少8个词,还得有标点,保证质量); 用dvector(一个训好的说话人验证模型)算这个新片段和SPC里已有片段的相似度,超过0.7就更新SPC——既保证缓存质量,又不存没用的内容。
03、实验:数据、配置和结果都在这
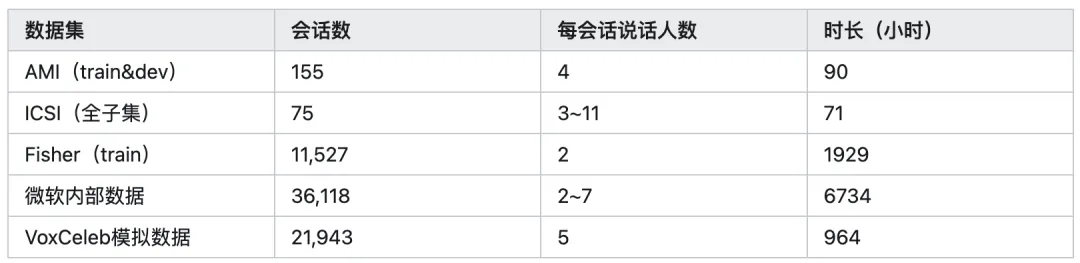
硬件:16个NVIDIA A100(80GB),每个GPU的批大小是256秒音频; 优化器:AdamW,学习率1e-4,1000步预热,总共训40k步; Spk-Decoder:3层Transformer,隐藏层1024维,16头注意力。
本地场景(≤20秒):用AMI Test、CH109 Full、内部测试集,非流式推理,看WDER(词分割误差率)和cpWER(拼接最小置换词错误率); 全局场景(长音频):用CH109 Test、Fisher Test,分“Oracle分块”(用真实句子边界分块)和“VAD分块”(用语音活性检测分块),还加了SA-WER(说话人归因词错误率,更严格,不用找最优ID匹配)。
04、实验结果:JEDIS-LLM表现有多好?
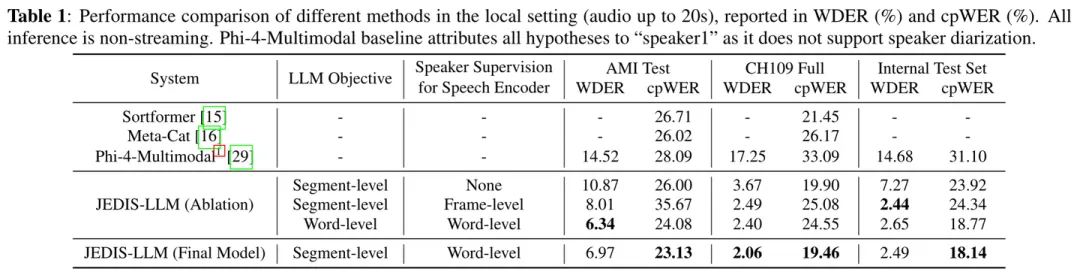
AMI Test:JEDIS-LLM的WDER才2.06%,cpWER19.46%;而Phi-4-Multimodal(没分割能力,全标speaker1)的WDER14.52%,cpWER28.09%;Sortformer、Meta-Cat的cpWER都在21%以上; 消融实验还证明:词级监督比帧级好(帧级会让cpWER变差),段级目标比词级目标好(词级打乱上下文)。
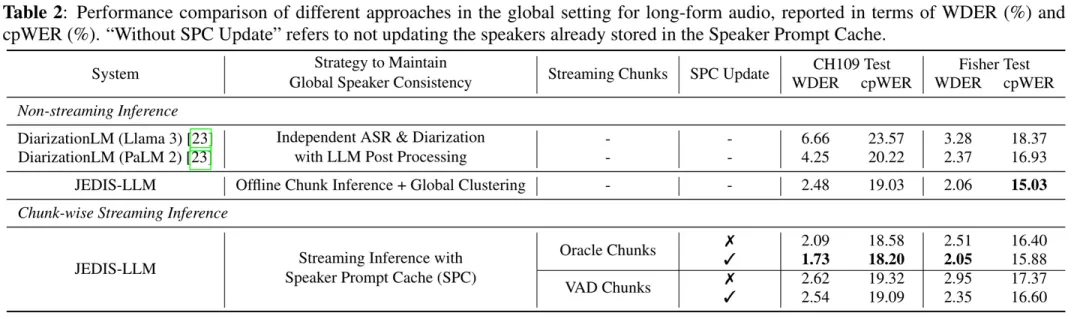
流式JEDIS-LLM(Oracle分块+开SPC更新):CH109 Test的WDER1.73%,cpWER18.20%;而PaLM2版DiarizationLM的WDER4.25%,cpWER20.22%,差了一大截; 开SPC更新比不开好:比如VAD分块下,开更新WDER2.54%,不开2.62%; 更惊喜的是:流式推理居然比“离线分块+全局聚类”还好(CH109 Test的WDER1.73% vs 2.48%),说明SPC的一致性做得比后处理聚类还棒。
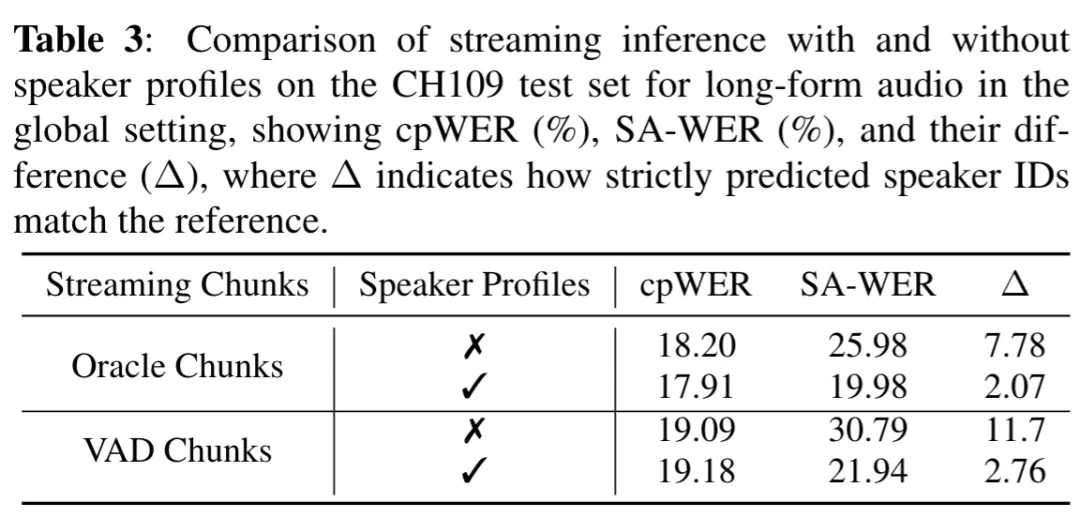
Oracle分块:没档案时差距7.78%(说明ID匹配乱),有档案后差距才2.07%(ID和真实对应更准); 还能直接映射真实姓名(比如speaker1→Mike),这对会议转录等场景太实用了。
05、总结:这篇论文的贡献在哪?
技术突破:首个只训短音频(≤20s),却能零样本处理长音频流式推理的端到端模型,不用后处理; 核心创新:SPC机制解决ID一致性,词级监督增强分割,说话人档案提升实用性; 性能SOTA:短音频赢Sortformer、Meta-Cat,长音频赢DiarizationLM,还能实时流式——给多说话人语音理解(比如会议转录)提供了新方案。
