
 语音小管家
题目:《Auden-Voice: General-Purpose Voice Encoder for Speech and Language Understanding》
01、先说说研究背景和要解决的问题
现在那些大型音频语言模型(比如SALMONN、Qwen-Audio-2)虽然能理解语音,但有个大瓶颈:感知误差比推理误差更严重,问题就出在“声学编码器”上。比如Whisper、BEATs这些编码器,只优化“把语音转文字”,完全没考虑人类语音的两个核心信息——说话人是谁(身份)、说话时的情绪/年龄/性别(副语言线索)。 而且之前的研究特别“割裂”:做身份识别的模型(比如x-vector、WeSpeaker)会故意压制语音的变异性(比如同一个人开心和生气的声音差异),做副语言的模型(比如emotion2vec、Vesper)又特意放大这种变异性,没人想着把两者结合。另外,就算有些研究想做通用表征,也没系统地测试过效果,更没好好研究怎么跟LLM集成。 还有个点,大家觉得用CLAP(语音-文本对比学习)能让语音和文字对齐,应该能提升副语言理解,但实际效果咋样、会不会影响身份识别,之前没人说清楚。这篇论文就是要解决这些问题。
02、核心创新点得拎清楚
第一个通用编码器,兼顾身份和副语言:之前要么只做身份、要么只做副语言,Auden-Voice是首个能同时抓这两类信息的通用编码器,不用针对单个任务改模型。 三阶段训练框架+五维度评估,特别系统:从ASR预训练初始化,到多任务联合训练,再到CLAP微调,每一步都测效果;评估也不偷懒,覆盖了有监督、零样本、跟LLM配合等5个场景,能全面看出编码器的真实水平。 发现了两个关键结论:一是ASR预训练打底+多任务训练,比单任务训练均衡多了;二是CLAP是“双刃剑”——只提升语音-文本检索,反而会拉胯身份识别、情绪识别这些任务,就算用10倍数据训CLAP,也补不回损失。 模块化设计,能跟LLM无缝配合:编码器冻结后,只加个轻量适配器就能连LLM,不用改LLM本身,效果还能跟端到端模型(比如Qwen-Audio)、Whisper+GPT-4这种级联模型比。
03、具体怎么做的?(方法部分)
第一步:初始化:先从一个“大规模中文ASR预训练模型”(用RNNT损失训的)开始,再试不同的监督任务,比如说话人识别(SID,用交叉熵/边际损失)、说话人验证(SV)、副语言分类(年龄/性别/情绪)。最后发现,用交叉熵(CE)损失初始化效果最均衡,后面就都用这个。 第二步:多任务训练:把SID和三个副语言任务(年龄、性别、情绪)放一起训,用均衡的CE损失让模型同时学两类信息。如果某个样本缺标签(比如只有身份标签,没有情绪标签),就用“伪标签”补,避免数据浪费。 第三步:CLAP微调:在多任务基础上,加语音-文本对比损失,让语音embedding和文字embedding对齐,想提升零样本泛化能力。
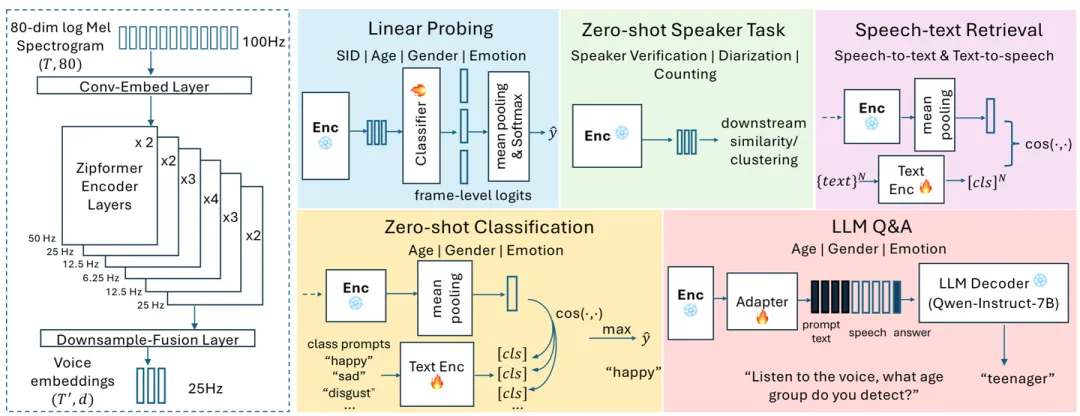
图1左边:就是Zipformer的核心结构,多速率Transformer层+下采样融合模块,输出帧级特征,再池化得到embedding,没啥花里胡哨的,重点是统一结构。 图1右边:五个评估场景(编码器都冻结,只测embedding质量):
线性探测:给帧级embedding加个线性层,训分类任务(SID、年龄、性别、情绪),看准确率。比如SID是5994类(VoxCeleb2数据集),情绪分6类(CREMA-D)或8类(RAVDESS)。 零样本说话人任务:不用训,直接用平均池化的embedding做三件事——说话人验证(SV,用余弦相似度算EER)、说话人分割(SD,用PyAnnote pipeline,算DER)、说话人计数(SC,算MAE),数据集是VoxCeleb1o(SV)和VoxConverse(SD/SC)。 语音-文本检索:测语音和文字的对齐度,比如用文字“找一个开心的女声”检索对应的语音,或用语音找文字,看Recall@1/5/10(前1/5/10个结果里有没有正确的)。文字编码器用RoBERTa-base,只训文字端,语音端冻结。 零样本副语言分类:不用训分类器,直接拿语音embedding和文字提示的embedding算余弦相似度,比如“这个说话人很生气”的文字embedding,跟语音embedding比,相似度最高的就是预测结果。还会用10个不同的文字模板取平均,避免 prompt wording 影响结果。 LLM-QA:测跟LLM的配合度,给编码器加个轻量适配器(两个线性层+ReLU),把帧级embedding下采样4倍,再投影到LLM的输入维度,跟问题/答案的文字embedding拼一起。LLM和编码器都冻结,只训适配器。任务是副语言问答,比如“说话人情绪是什么?”,数据集是AIR-Bench。
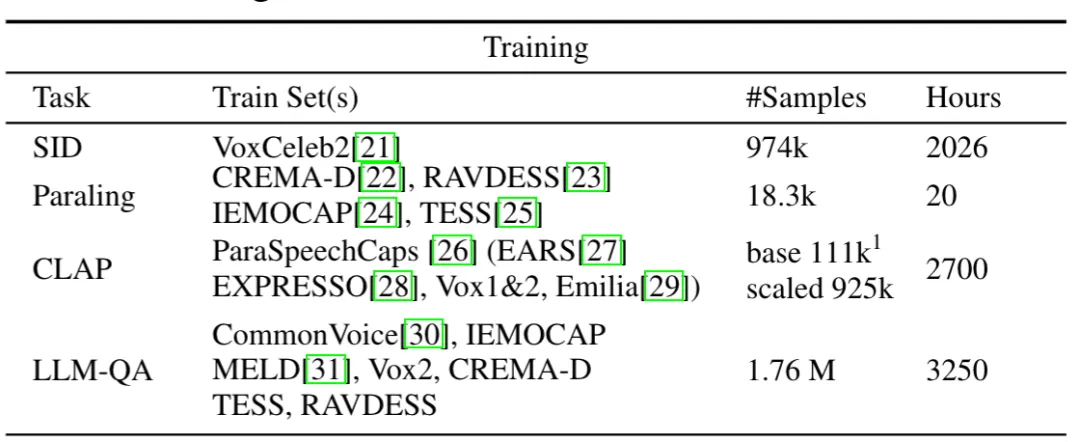
SID:VoxCeleb2,974k样本,2026小时(量大,保证身份识别效果); 副语言:CREMA-D、RAVDESS这些,18.3k样本,20小时(覆盖不同情绪/年龄/性别); CLAP:ParaSpeechCaps,基础版111k样本,放大版925k样本,2700小时(语音文本配对数据); LLM-QA:Common Voice、IEMOCAP这些,1.76M样本,3250小时(问答配对数据)。
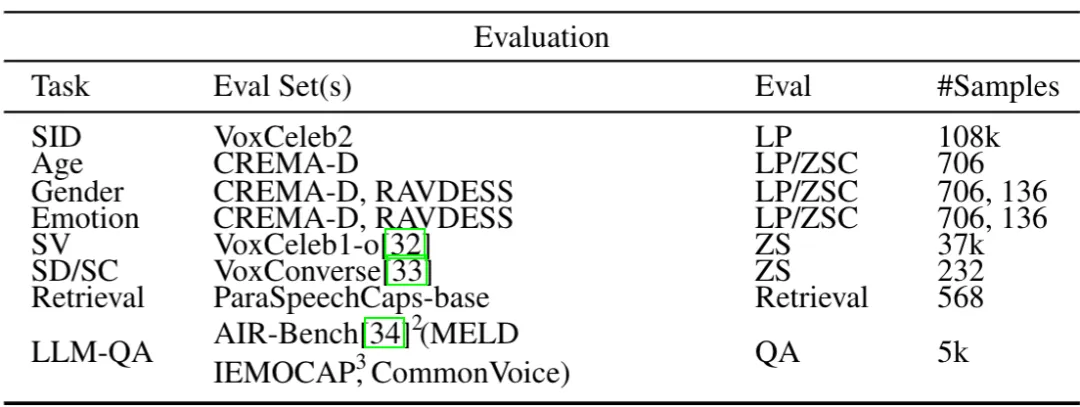
SID:VoxCeleb2的108k样本(线性探测); SV:VoxCeleb1o的37k样本(零样本); SD/SC:VoxConverse的232个样本; 检索:ParaSpeechCaps-base的568对样本; LLM-QA:AIR-Bench等的5k样本。 还特别提了:训练和评估数据有重叠的都过滤了(比如ParaSpeechCaps和Vox1/2的测试集重叠,就删掉),避免数据泄露。
04、实验结果咋样?
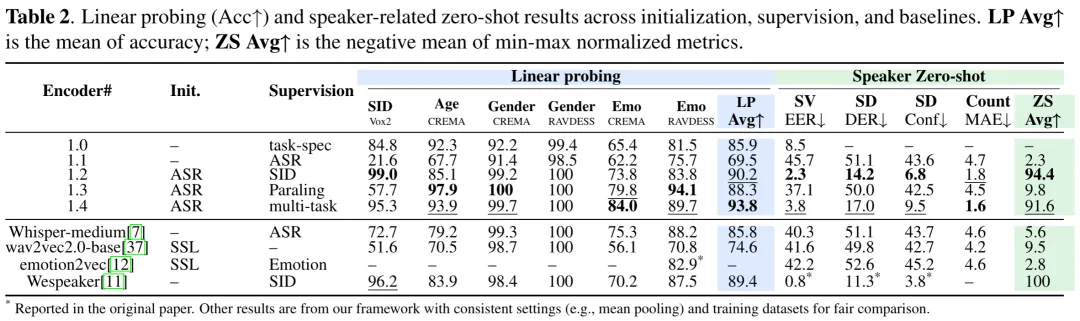
ASR预训练比从头训好太多:比如“1.1(ASR初始化)”比“1.0(无ASR,任务特定训练)”在SID上从84.8%涨到99.0%,情绪识别从65.4%涨到73.8%——说明ASR模型虽然是训转文字的,但能给语音表征打个好基础。 多任务训练最均衡:“1.4(ASR+多任务)”的LP Avg(线性探测平均准确率)是93.8%,ZS Avg(零样本平均得分,越高越好)也是最好的;而单任务的“1.2(ASR+SID)”虽然SID好(99.0%),但情绪识别只有83.8%,“1.3(ASR+副语言)”则反过来——证明多任务能同时抓身份和副语言。 比基线模型强:比如Whisper-medium的LP Avg只有85.8%,ZS Avg也不如1.4;WeSpeaker(专门做身份的)虽然SID有96.2%,但情绪识别只有70.2%,不如1.4均衡。
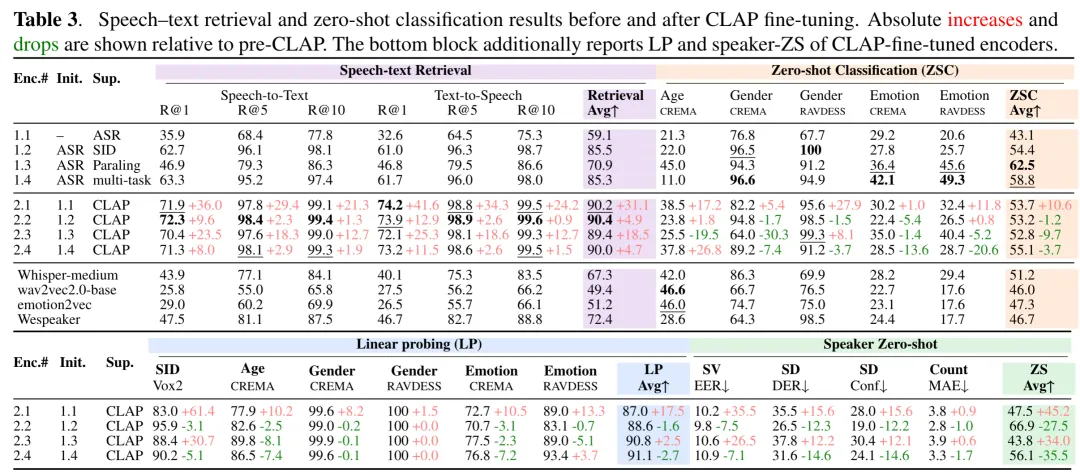
CLAP只提升语音-文本检索:比如“1.4(多任务)”微调后(2.4),语音到文本的Recall@1从63.3%涨到71.3%,文本到语音从61.7%涨到73.2%——这是好事。 但CLAP会拉胯其他任务:比如线性探测里,SID从95.3%降到90.2%,情绪识别从84.0%降到76.8%;零样本副语言分类(ZSC Avg)从58.8%降到55.1%;就算用10倍CLAP数据,也只能部分恢复,还是没回到微调前的水平。 基线模型也这样:比如Whisper-medium用了CLAP后,身份和副语言任务也没变好——说明CLAP的问题不是Auden-Voice特有的,是这种方法本身的局限,它只优化语音-文本对齐,不管身份和副语言。
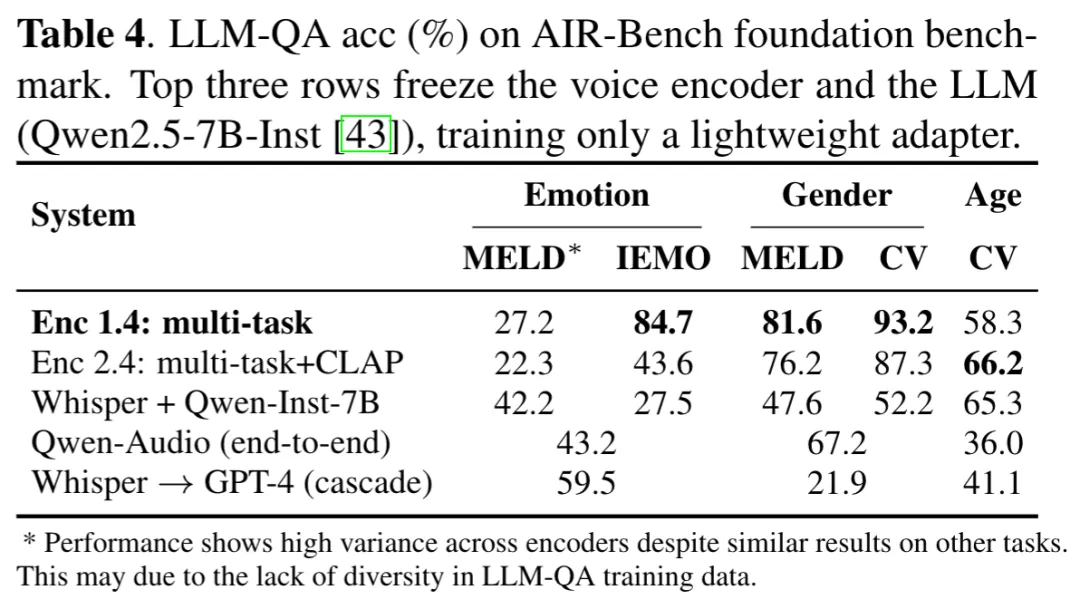
多任务编码器(1.4)比加CLAP的(2.4)好太多:比如情绪QA在IEMOCAP上,1.4是84.7%,2.4只有43.6%;性别QA在CV上,1.4是93.2%,2.4是87.3%——证明CLAP不仅没用,还拖了LLM配合的后腿。 跟其他模型比有竞争力:比如Whisper+Qwen-Inst-7B在情绪QA(MELD)上只有42.2%,不如1.4的27.2%?不对,这里表4里MELD数据有点特殊,论文说MELD方差大,可能是训练数据多样性不够;但在IEMOCAP上,1.4的84.7%远超Whisper+GPT-4的21.9%,也比Qwen-Audio(端到端)的67.2%好——说明Auden-Voice作为模块化编码器,跟LLM配合得很好。 还有个关键发现:LLM-QA的准确率和线性探测的准确率强相关——也就是说,编码器本身的监督表征质量(线性探测能测出来),直接决定了LLM能不能用好语音信息,不是靠CLAP的语音-文本对齐。
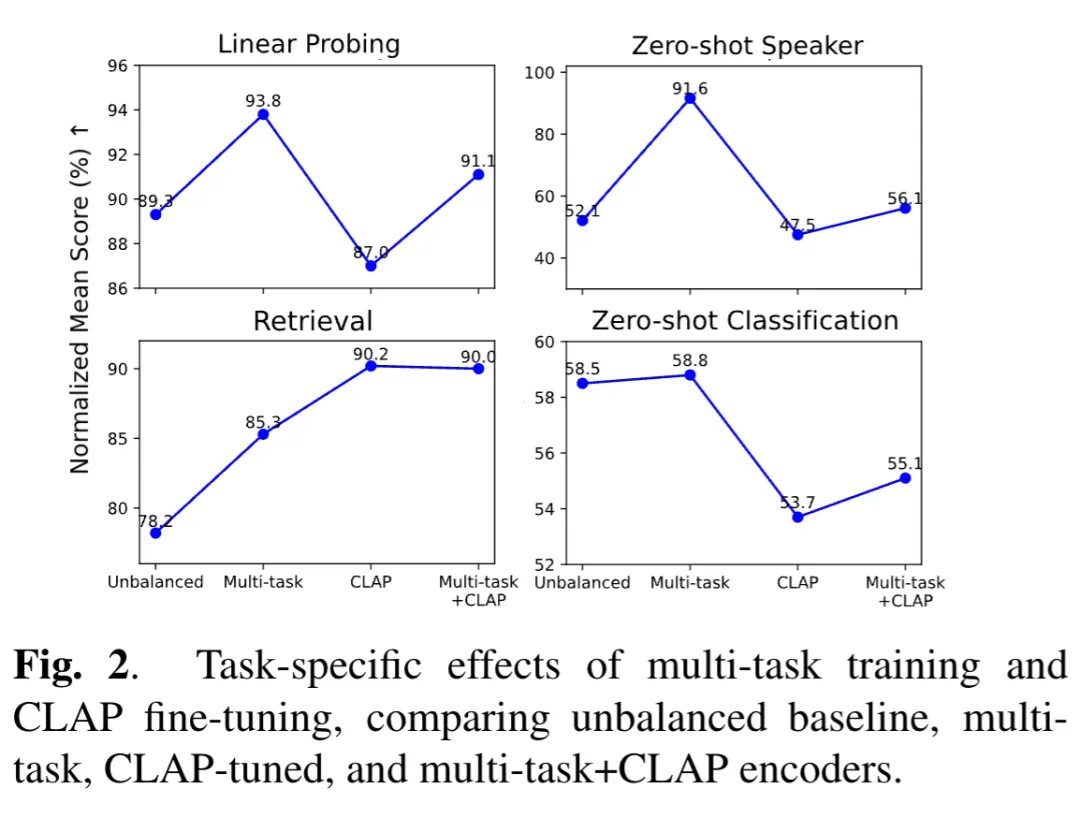
线性探测和说话人零样本任务:多任务(1.4)明显最好,CLAP(2.1)最差,多任务+CLAP(2.4)比多任务差——跟表2、表3结果一致,证明多任务在这两类任务上碾压CLAP。 语音-文本检索:CLAP(2.1)和多任务+CLAP(2.4)最好,多任务(1.4)最差——说明CLAP确实只优化检索。 零样本副语言分类:多任务(1.4)比单任务好,但加了CLAP后(2.4)反而降了——再次证明CLAP对副语言理解没用。
05、最后总结下结论
ASR预训练+多任务训练,是平衡身份和副语言的最优解:ASR给基础,多任务让模型不偏科,比单任务和CLAP都好。 CLAP是双刃剑,目前没达到视觉-语言领域的规模红利:只能提升检索,还损害其他任务,就算加数据也补不回来,暂时不适合通用语音编码器。 LLM的语音推理能力,靠的是编码器的“强监督表征”,不是语音-文本对齐:线性探测准了,LLM-QA自然就好,不用靠CLAP强行对齐。
