
 语音小管家
本系列的十篇文章,是对之前文章
原文链接
AI语音AI思考,公众号:AI语音AI思考关于未来语音技术和应用趋势的10点看法
中提到的十个趋势进行详细的剖析。在这个系列文章中,会穿插科普、技术综述、技术发展路线,以及一些个人和其他行业专家的思考。希望通过这一系列文章,无论读者之前对语音技术和应用了解多少,都能获得一些有价值的观点。
本篇将围绕趋势二,“端到端是相对概念,短期应用有限”这一观点,深入分析语音端到端对话系统和级联系统,以及在端到端系统实际落地过程中充满想象力的理想状态和骨感现实之间的差距。每一项技术都有其历史、现在和未来的价值,我们希望通过尽可能客观的分析,为从业者提供一些参考。特别是最后面的“数据困境”,我认为是当前系统面临的最大的挑战。
级联系统
虽然本篇文章的重点是语音到语音的端到端 (Speech to Speech, S2S) 系统,但是级联系统作为目前主流的实用系统,还是会用一定篇幅进行介绍,特别是在新技术层出不穷的今天,到底是架构的问题,还是认知或者具体执行的问题,是需要我们反思的。
级联系统架构
级联系统,顾名思义,将几个不同的模块,通过中间的介质连接起来,得到语音输入-语音回复的对话系统。一个完整的级联系统架构如下:
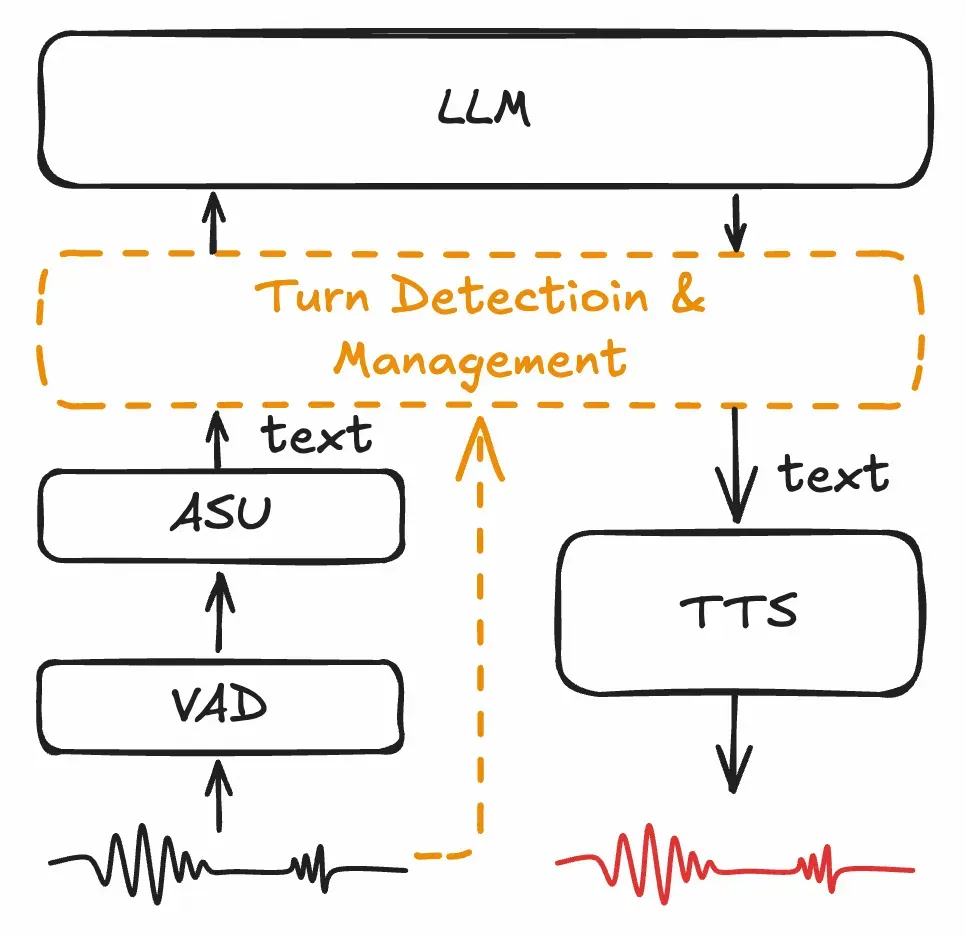
我相信大部分人对级联结构应该都比较了解了,但是这里,我还是想提一下两个模块,其中的ASU和Turn Detection模块。
之前的大部分实现和文章介绍中,都会用自动语音识别ASR模块来表示语音转录成文字,这里我们是用更通用的ASU,语音理解。轮次检测和对话管理,也是全双工模式或者自然交互模式必不可少的部分,但一般比较老的实现,这部分是没有的或者做的很差。
级联系统优势
可控性强。由于采用文字作为模块之间的链接,任何一个部分都可以归因。 各模块单独优化。出现问题可以非常容易定位和分析,优化效率高。 融合外部知识。特别是在知识密度高、严肃场景,通过文本作为模型之间的链接,可以很容易和RAG结合。 使用范围广。从AI硬件,到嵌入式系统,再到电话客服,不同性质的应用,都可以根据自己的任务灵活采用。
劣势和“所谓的”劣势
为什么我说这里是“所谓的劣势”,因为在我看来,大部分论文和文章中讨论的劣势,并不是因为它是级联的,也不全是因为文本模态导致的信息丢失,而是因为我们一直在基于过时的模型能力来评判级联架构,这是不公平的对比。
并不是说没有劣势,实实在在的劣势如下,这些都是劣势,而且从我个人角度来看,这些明显的劣势,都让级联系统看起来不符合未来模型统一和简化的趋势:
多模态统一建模非常不友好,如果有多模态的需求,模态越多,复杂度越高; 工程实现相对复杂,涉及到不同模块的同步和控制;
然后,我们来看一下经常被提及的级联系统的劣势,是否真的成立?那些所谓的劣势,我们是否应该再考虑一下,是具体方案的问题,还是因为级联导致的?端到端真的可以解决吗?
延迟问题,大多数延迟并不是因为它是级联导致的。主流声音都认为,“原则上,理论上”,级联系统的延迟就很高,比如经常被提起的VAD,很多实现方案下,需要用几百毫秒的静音来作为用户停止的标准。而现在看,完全不需要,轻量级Turn Detection的加入,完全可以避免这个问题。 情感、副语言的丢失。那是因为上面提到的,目前大部分系统都采用的是简单的ASR,而不是ASU,随着技术的升级,ASR升级为ASU,即使最终还是采用文字描述,体验也会大大提升。这个问题,即使采用端到端结构但是在任务中没有相应的构思和设计(比如声纹),同样存在。 语音合成的情感和自然度。这个就更不是问题了,单独的TTS模块目前已经可以做的很好了,无法激发TTS自然度的一个重要原因是,如果单纯采用ASR,是无法得到用户丰富的输入信息的,一旦语音理解模块得到升级,再充分结合文本LLM的能力,最后采用类似instruct-TTS的方式,一样也可以做出比较真实的效果。
理想的端到端系统
理想的端到端系统,在理论上有更高的上限。通过中间表征而非文本,统一的训练和调优,消灭级联方案中间过程的误差,达到精准的交互体验。
极致的简单,把所有的决策都交给数据和模型
理论上的端到端模型,架构是非常简单的。如果完全理想的状态,那么技术层面的端到端,应该和产品层面的端到端概念,最终达成统一,即用户感受到的就是一个模型直接完成的。
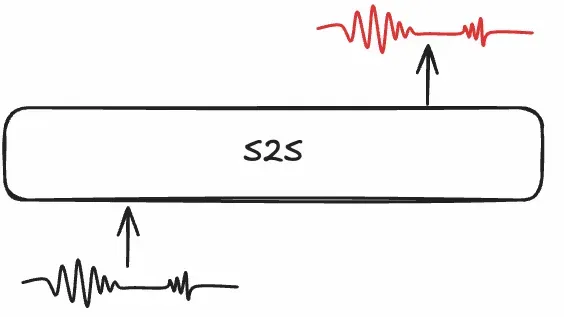
交互过程中的When-How-What-Why,统一由模型进行决策:
When:机器什么时候开始说话、什么时候停止说话、什么时候可以附和、甚至什么时候可以主动抢话和打断用户(理论上) How:机器如何回复,用什么语音语调、音色、情感、语速、方式进行回复 What:机器应该回复什么内容 Why:为什么这样回复,可以理解为思考的过程
那么如何才能保证系统完成如此多的任务呢?核心就是数据!将所有的决策过程,都交给了数据。如果所有的数据都是理论上“合理的”,那么没有任何问题,而现实是不太可能的。
拟人的延迟
延迟不是越低越好,而是越自然越好。
我们经常看到一些论文或者公众号文章宣传,系统延迟低到多少毫秒,其实这种指标没有多少价值。人机交互并非越快越好,面对用户的迟疑和思考时,机器需要耐心等待;面对完整的表达,则可以迅速提供反馈。比如豆包的语音通话,它的平均延迟在1.5-2s之间,大多数应该不会觉得它很慢。
那如何能达到拟人的效果呢?核心还是数据。而具体到各种应用场景和语境下,又各不相同。一个“嗯”,有时候是确认,有时候是附和,有时候是表示思考。所以这是个非常复杂的场景。
多模态融合
这也是端到端相比于级联系统的一大优势。在多模态融合方面,由于图像、音频、文本,都采用相对统一的表示,多模态融合变得非常自然。
现实的端到端系统
Encoder+LLM+Decoder的结构
理想的端到端语音对话模型,应该非常简单,甚至将来在算力允许的时候,直接在原始音频层面进行建模。现实中,端到端的模型,还是遵循了Encoder+LLM+Decoder的结构,似乎和级联系统没有太大的差别,不还是几个模块串联在一起了吗?当然这里面的技术细节差别就比较大了。
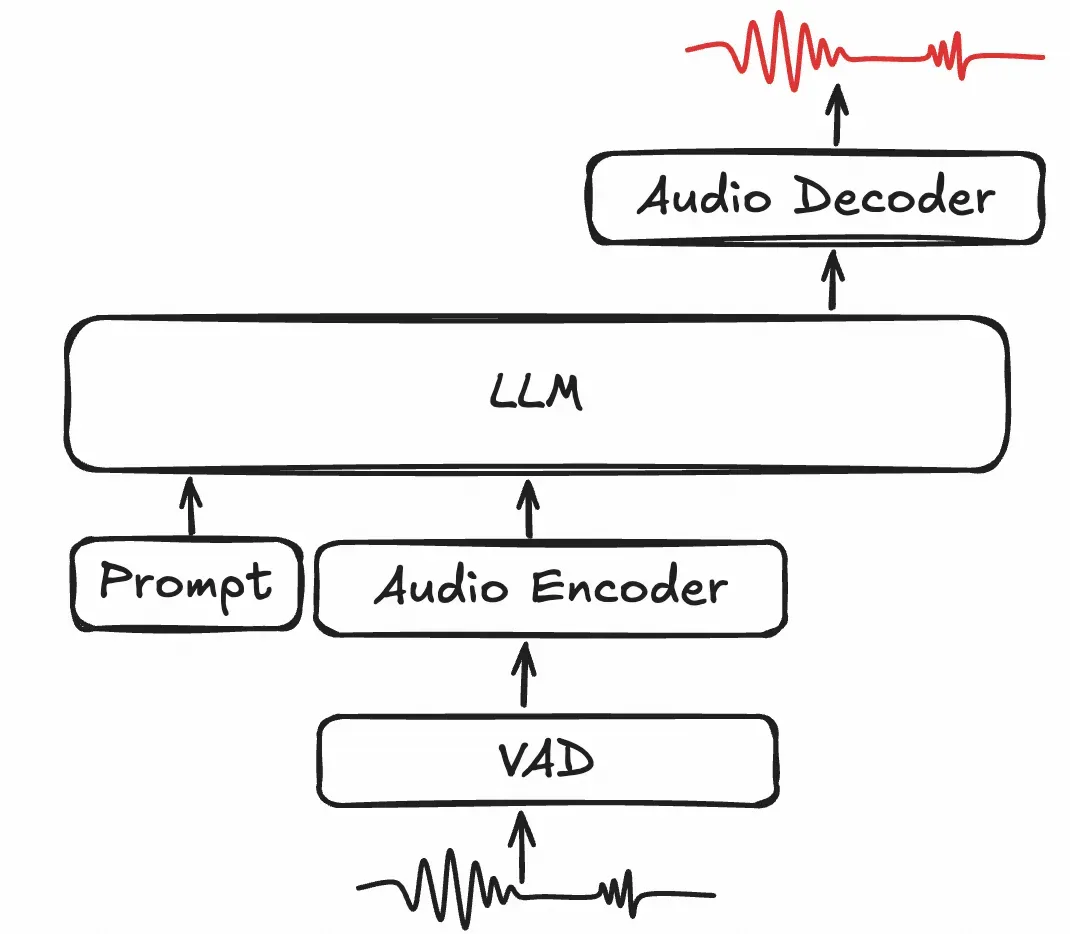
基于此基础结构,又演化出不同的方案,最大的不同点在于预测的方式上。
交叉预测和多流预测
大多数Omni模型,都是将Text Token和Audio Token在片段层面上进行交叉,让模型交叉预测两种Token。这样做的好处是模型可以在保持文本能力的同时输出音频能力,同时,音频也有文本的先验知识,输出更稳定可控。
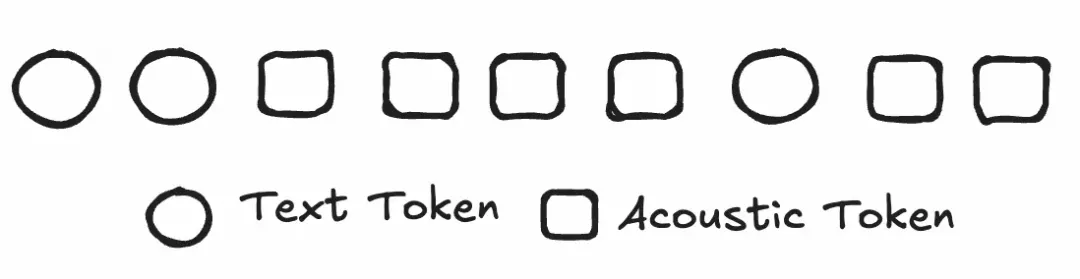
另外还有一种,比如Moshi,采用多流的方式,但是目前来看,这种方式计算复杂度比较高,稳定性也比较差,采用的比较少。
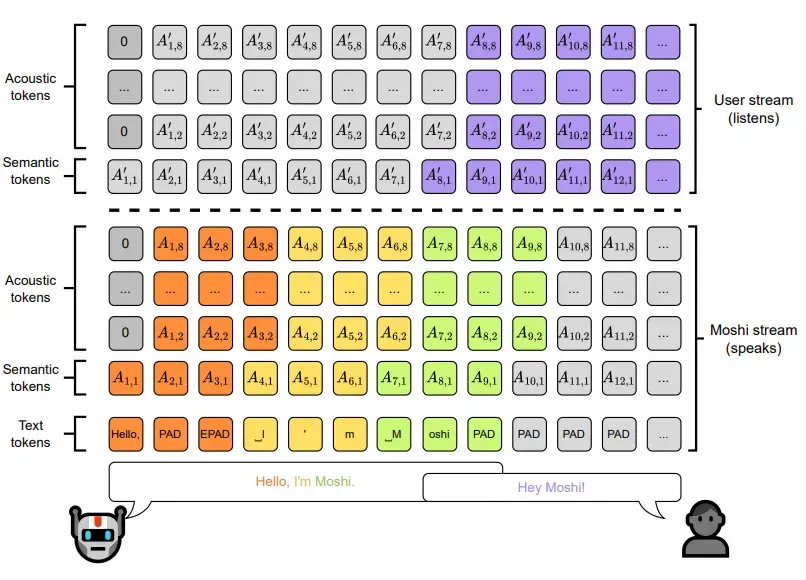
端到端系统的现实挑战
智商的保持
如何保持原有文本大模型的智商,是最大的挑战。从目前来看,加入多模态的数据,并不能带来新的智能涌现,反而很容易造成智商的下降。为了解决这个问题,在模型上、训练策略上、数据配比上,都需要下非常大的功夫。
如果做到产品可用的级别,而不是一个demo,这将会是最大的挑战,特别是对于一些相对严肃的场景,比如客服、助手类的产品。
外部知识融合
在严肃场景、知识密度要求高的场景,无法融合外部知识,也是端到端比较难处理的一个问题。相对轻松的聊天场景,主打情绪价值,最适合使用端到端系统。但是严肃的场景,比如客服、医疗、政务、法律,目前的端到端框架,有明显的不足。此时,产品对功能的要求大于情绪价值的要求。
训练过程复杂,迭代和迁移困难
即使基于各种预训练的模型,比如Audio Encoder是使用音频数据提前训练,LLM使用文本大模型,训练一个端到端模型,还是需要比较复杂的步骤,这一部分,可以参考不同模型的技术报告。一个模型的训练,基本都需要五六个阶段,模态越多,任务越多,训练过程越复杂。不仅要考虑模态的对齐,还要保证不同任务性能的均衡。
因此,看起来简单的结构,迭代一次往往困难比较大,如果往其他方向迁移,任何一个模块考虑不周,都有可能导致失败。另外,一旦文本大模型更新,训练往往也需要重新进行。
实时推理的挑战
最理想的全双工对话模式,理论上用端到端结构非常容易实现,也就是我们经常说的“边听-边想-边说”。先假设模型可以完美的完成这个工作,推理的过程本身,就存在比较大的挑战。
首先,边听边想,这意味着非常高的实时性。可以类比文本大模型的问答过程。文本大模型的推理,有Prefilling和自回归解码的过程。Prefilling是并行度很高的过程,所以一般的大模型API,输入的价格很便宜,但输出价格比较高。
而实现真正意义端到端的边听边想,意味着非常高频的推理,比如,使用固定的chunk进行推理。chunk越小(几十ms),理论上系统反应越快,可是推理成本和推理时间会很大;chunk越大,比如几百ms或者1秒,那么实际上平均延迟就会高。每一个chunk的推理,可以看成一次Prefilling的过程,但Prefilling的Token数目每次都比较小,加速就不明显。
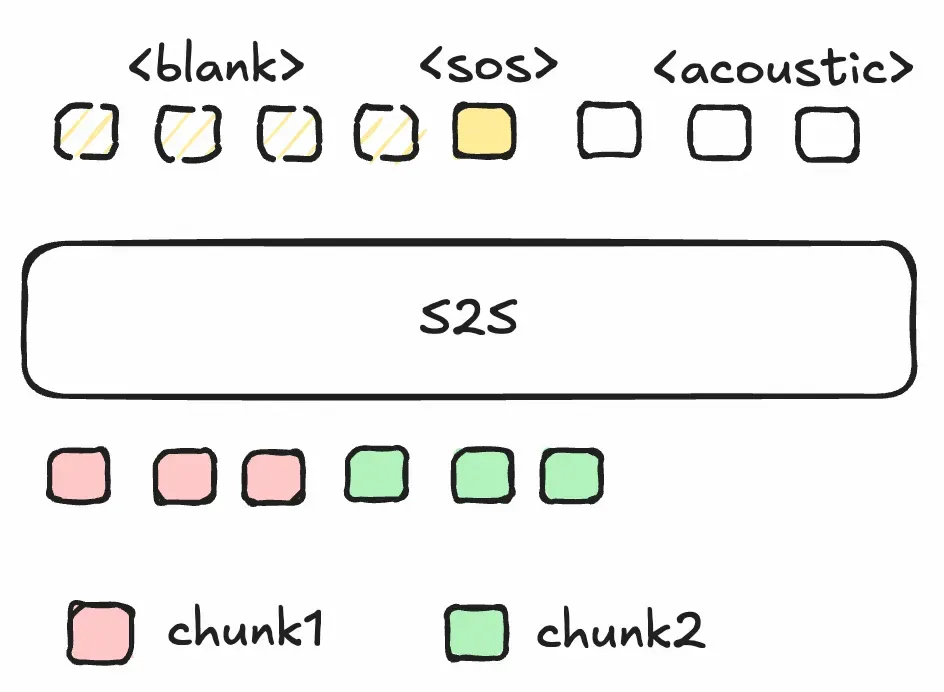
因此,在实际使用中,往往并做不到真正的“边听-边想-边说”,为了折中推理速度、用户体验,往往还会采用一个单独的Turn Detection模块,在一段相对完整的输入结束后,统一送入到端到端模型,也就是说,将“When”的处理,拆解出来。
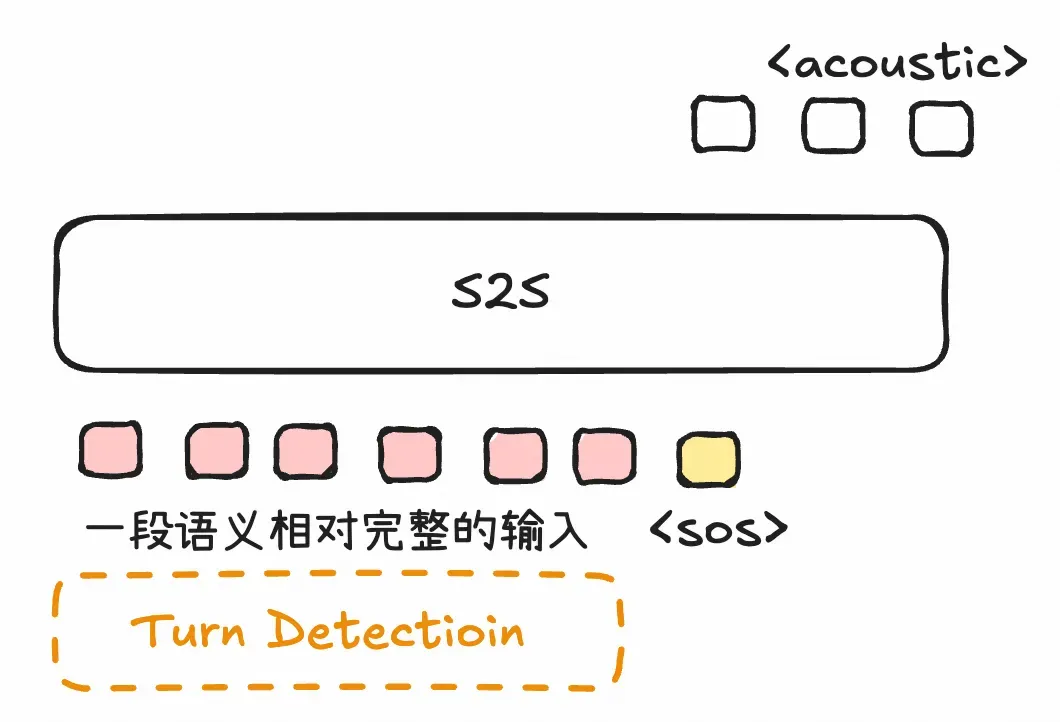
这样的方式,推理效率会大大提高,只不过失去了“边听-边想-边说“的能力。另外,靠模型解决When的问题,听起来简单,实际上一点都不简单。在语音识别相对准确和大模型理解能力都比较到位的时候,When就成了制约体验的短板了。
数据困境
我想这应该是一个共识:能力不是来自于模型,而是数据。如果能力定义不清、数据筛选不合理,端到端同样不能解决级联系统中出现的所谓的问题。
如果不设计某种能力,即使用到了带有这种能力的数据(比如情感、说话人),模型大概率不可能涌现出来相应能力,相应的属性会被完全忽略,这是有监督学习的一个非常大的问题。
比如,采用端到端结构,但是Acoustic Encoder就是采用了ASR任务训练,那么仍然丢失掉了很多信息。因此,如何定义能力、如何筛选数据、如何仿真数据,才是决定系统上限的关键。
如何定义能力
也就是在系统设计之初,设计者期望模型能有什么能力?会唱歌、能识别说话人、会哭会笑,还是说就只能输出语音完成交互?
如果一开始能力定义不清楚,就算有一亿小时的数据,也只能完成最基础的功能,而且大量的有价值的数据会因为不符合前期的能力定义而被过滤掉。所以,只有模型设计者考虑的全面了,或者针对自己的某个业务需求考虑的全面了,能力才会有条件的涌现。
筛选和仿真数据
定义好能力,才能开始筛选数据和仿真数据。数据的筛选和模型能力的提升,往往是一个螺旋上升的过程。
首先从单一能力模型开始,对数据进行自动化打标,对单条数据进行多维度的标注。文字、情感、性别、语速、口音、年龄、语种、种类、声音事件、背景噪声、BGM、混响、清唱、伴奏、乐器……反正只要是能想到的,都可以作为标签。
解决When的问题,也就是决定什么时候开始,什么时候结束,这就是典型的数据驱动。如果在数据筛选过程中,将不完整的数据全部过滤掉,或者采用了某个阈值将数据切断,或者没有明确、准确检测到说话人的切换,都会显著影响When的性能。
在数据筛选的前期,一定是有“幸存者偏差”存在,这也是难以避免的,通过后续的迭代,或者相对真实的仿真,逐渐弥补这个问题。
端到端的相对性
端到端是相对概念
说到端到端这个概念,本身就有一定的相对性。比如自动驾驶里面的端到端,从视觉感知到动作执行。在Voice Agent,也是从声音感知到执行。跳出技术来看,对于产品来说,技术实现都是黑盒子,对用户来说都是端到端的。
虽然我们这里主要讨论的是S2S的端到端对话,这里想表达的是,对话仅仅是语音应用的一个子方向,还有更大更多的需求,需要其他的方式来实现。因此,端到端对话系统的应用是有限的,特别是在目前技术不成熟、成本较高的背景下。
S2S端到端的适用场景
以情绪价值为主的聊天场景
如果一个产品主要以提供情绪价值的对话为主的话,那么端到端的语音对话系统是一个不错的选择。特别是融合多模态的理解,端到端系统优势更加显著。
一般场景的语音翻译
除了一般的对话,一般的实时翻译场景,也比较适合端到端模型来解决。
总结
我相信S2S的端到端代表了未来的技术发展趋势,在多模态融合、架构简化、未来算力逐步加强的背景下,一定还会更上一层楼。只不过在目前的探索中,问题是存在也是明显的。解决这些问题,仍然需要周密的设计、细致的数据工程和大量的探索。
