
 语音小管家
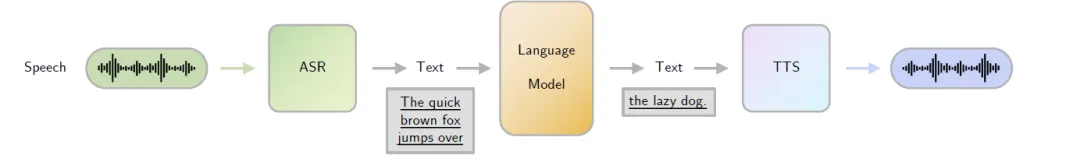
SLM一般由语音tokenizer,语言模型和声码器三部分构成,如下图所示。
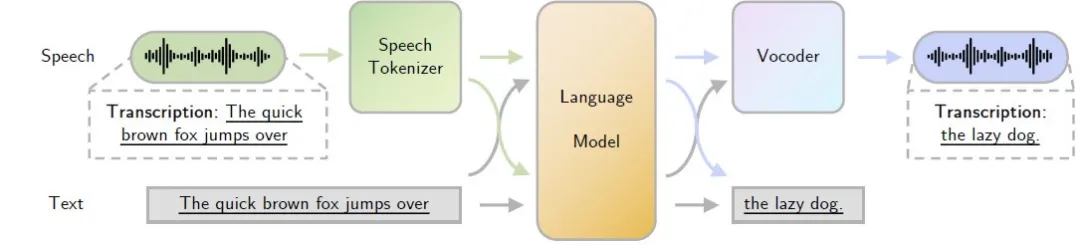
其中语音tokenizer将连续的音频波形转换为tokens,作为语言模型的输入;接着,语言模型基于输入的语音token执行下一token预测。最后,声码器将语言模型输出的token转换回音频波形。下面分别对着几个部分进行介绍。
💠语音tokenizer
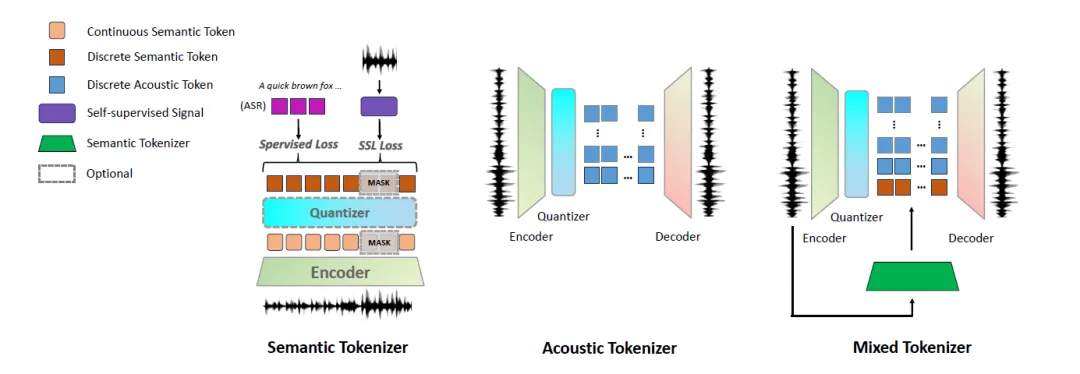
以语义理解为目标:设计时以语义理解为目标的语音tokenizer旨在将语音波形转换为能准确捕获语音内容和意义的tokens。这类分词器专注于从波形中提取语义特征,适合增强ASR这类任务。这种tokenizer通常包含一个语音编码器和一个量化器。语音编码器将波形中的基本信息编码成连续 embeddings。然后量化器,将这些连续嵌入转换为离散索引。常见的有Wav2vec,HuBERT,WavLM等。
以声学生成为目标:这种语音tokenizer其侧重点在于捕获生成高质量语音波形所需的声学特征,优先考虑保留必要的声学特性,而非语义内容,因此它们适用于语音(重)合成任务。这种tokenizer包括编码器、量化器和解码器,其中编码器和量化器将语音模型编码成tokens,然后解码器将tokens重构成语音波形。常见的有VQ,RVQ等。
混合目标:以混合目标为设计的语音分词器旨在平衡语义理解和声学生成两方面的需求。其目标是利用两类分词器的优势。目前,这类分词器的发展尚处于早期阶段。大多数现有的混合语音分词器主要沿用声学生成型语音分词器的架构,并侧重于将语义分词器中的信息蒸馏到声学分词器中。常见的有SpeechTokenizer,Mimi等。
在语言模型组件以自回归方式生成标记后,会利用一个标记到语音模块,通常被称为声码器,将所有语音标记合成回语音波形。这个过程涉及将生成语音标记所代表的语言信息和副语言信息,转换成可听的音频波形。
SpeechLM 声码器的流水线可能因底层的声码器模型而异。主要有两种合成方式:
直接合成:直接合成是声码器将语言模型生成的语音标记直接转换成音频波形
输入增强合成:输入增强合成采用了一个额外的模块,在将标记输入声码器之前,先将其转换成连续的潜在表征。使用这种流水线的主要原因是,声码器通常要求以中间音频表征,例如梅尔频谱图,作为输入。例如,CosyVoice引入了一个条件流匹配(Conditional Flow-Matching, CFM)模型来将语音标记转换成梅尔频谱图,然后利用 HiFi-GAN 来合成最终的波形。
合成方式的选择取决于语音token的类型。具体而言,对于声学生成型tokenizer的token,因为其包含足够的声学信息,使其适合直接合成。相反,来自语义理解型分词器的标记虽然提供了丰富的语义信息,但缺乏精细的声学细节,尤其是在更高频率上。因此,最好将这些标记增强为富含声学信息的表征,例如梅尔频谱图,然后再合成最终的语音。SLM中的声码器可以分为以下几种
基于GAN的声码器:生成对抗网络(Generative Adversarial Network, GAN)是声码器中最常采用的架构。它以其在语音合成任务中快速和高保真度的生成能力而闻名。GAN 的架构包括一个生成器和一个判别器。具体来说,生成器从随机噪声或输入特征中创建逼真的音频波形,而判别器则根据真实的音频样本来评估生成音频的真实性。常见的有Mel-GAN,HiFi-GAN,BigVGAN等。
基于GAN的神经音频编解码器:鉴于许多神经音频编解码器(neural audio codecs)采用了 GAN 架构,因此可以在基于 GAN 的声码器的背景下有效地讨论它们。与语音分词器不同,编解码器中的解码器被用作声码器。
其他类型的声码器:声码器的种类并不局限于前面提到的那些,因为它们只是 SpeechLM 中常用的类型。此外还有纯信号处理的声码器,如World声码器;基于自回归的声码器,如Wavenet;基于flow的声码器,如Waveglow;基于VAE的声码器,如VQ-VAE;基于Diffusion的声码器,如DiffWave。
下面介绍SLM训练范式,包括SLM中所建模的特征类型、不同的训练阶段以及在每个阶段所采用的技术,以及生成语音的不同范式。
🛠️特征建模
建模的特征指的是由语音tokenizer输出并由 SLM内的语言模型组件所建模的特征。这些特征对于决定SLM的能力和性能起着关键作用。不同的特征从不同方面对语音波形进行建模。根据近期的发展,可以将SLM 建模的特征划分为两大主要类型:离散特征和连续特征。
离散特征:离散特征指的是语音信号的量化表示,可以表示为独特的、可计数的单元或标记。这些特征通常是通过各种编码和量化过程从语音信号中得出的,最终形成一个有限的可能取值集合。离散特征是 SLM中最常用的特征,因为它们可以被表示为token,并能以与文本大模型中的文本token完全相同的方式进行建模。基于语义的离散token虽然擅长生成语义上富有意义的语音,但仅基于语义标记生成的语音缺乏表现力信息,例如韵律以及不同的音高或音色。基于声学的离散token通过捕获基本声学特征以重建高保真度语音,一般从神经音频编解码器模型中获得
连续特征:连续特征,与离散特征相反,是未经量化的、实数值的语音信号表示,存在于连续尺度上。连续特征可以包括频谱表示,例如梅尔频谱图,或从神经网络中提取的潜在表征。连续特征可以捕获语音中精细、细微的方面,这些方面可能会在离散化过程中丢失。然而,利用这些特征通常需要修改语言模型现成的训练pipeline,因为传统的基于文本的模型是为处理离散单元而构建的。此外,与离散特征相比,连续特征需要更多的存储容量。
📚训练阶段
训练一个 SLM 涉及训练三个主要组件:语音tokenizer、语言模型和声码器。与 文本大模型类似,训练 SLM 的关键在于有效地对连续语音进行建模,这主要由语言模型来负责。而语音分词器和声码器通常依赖于通常依赖于成熟的方法,并使用针对每种SLM 方法的特定训练数据集进行训练。与文本大模型类似,SLM 的训练过程也可以划分为三个阶段,包括预训练、指令微调和后对齐。
语言模型预训练
SLM 中语言模型的预训练是一个关键阶段,它显著影响着模型生成连贯且上下文相关语音的能力。此阶段通常涉及在一个大型语音标记语料库上,训练语言模型自回归地预测下一个token。在此阶段的主要目标是学习语音数据中固有的统计模式和依赖关系,使模型能够根据先前上下文来预测序列中的下一个token。语言模型预训练通常在大规模公开数据集上进行,常用的数据集包括用于 ASR、TTS、ST、播客和对话的数据集。一些数据集仅包含语音数据,而另一些则包含语音及其对应的文本转录稿。包含文本转录稿可以增强模型的表征学习能力,使其能够学习口语与其书面形式之间的关系。一些 SLM在预训练阶段使用冷初始化,即模型参数被随机初始化。与冷初始化相反,持续预训练涉及使用来自文本大模型的预训练权重来初始化语言模型,然后将其适配以处理语音标记。这种方法利用了嵌入在文本大模型中的语言知识,从而实现了 SLM更高效、更有效的训练。
语言模型指令集微调
指令微调指的是微调 SLM以遵循特定指令来执行各种任务的过程。这个阶段对于增强预训练模型的泛化能力和使其更适应多样化应用至关重要。因此,核心重点在于创建有效的指令遵循数据集。
语言模型后对齐
后对齐是一个关键过程,旨在优化语言模型的行为,使其符合人类偏好,确保其输出既安全又可靠。此阶段通常被认为是语言模型训练的最后阶段。它经常采用诸如基于RLHF等技术,特别是像PPO,DPO这样的方法。此外,后对齐的一个关键应用是减轻与生成模型相关的安全风险。
🗣️ 语音交互范式
SLM的传统生成范式是接收一个预定义的输入序列并生成一个完整的回复。然而,这种方法并不能反映语音交互的自然流程。例如,在对话过程中,一个人可能会打断另一个人,从而从聆听转变为说话。此外,如果另一个人正与他人进行对话,一个人可能会选择不回应。基于这些观察,SLM语音交互技能的两个关键方面为实时交互和交互周期识别。
用户打断: 模型可以在对话过程中被打断,并对新的指令做出适当回应。
同步响应: 允许模型同时处理输入和生成输出。
交互周期识别是指识别用户是否正在与模型进行交互的能力。SLM应在交互周期内提供回复,并在非交互周期内保持沉默。交互周期对于创建自然的对话流程至关重要,能让模型避免不必要的打断。此外,模型学习何时忽略那些不是针对它发出的指令也同样重要。
不同于通常只关注特定任务的 ASR和 TTS等传统语音系统,SLM的功能是作为生成式基础模型。它们可以通过遵循各种指令来处理多样化的纯语音、纯文本和多模态任务。SLM的下游任务大致可以分为三大类:
语义相关任务:语义相关应用涵盖了促进人机之间有意义交互的关键任务。这些应用要求 SLM 能够理解输入中的语义意义,并生成不仅上下文相关而且逻辑连贯的回复。这类任务相关的应用有:语音对话、语音翻译、语音识别、关键词识别、语音合成、意图分类、槽位填充、示例查询语音术语检测等。
说话人相关任务:说话人相关应用指的是涉及处理与说话人身份相关信息的任务。它可能涉及分类任务,例如根据说话人独特的发声特征来识别、验证和区分个体说话人;也可能涉及生成任务,例如保持或修改给定语音的音色。这类任务相关应用有:说话人识别、说话人验证、说话人日志和语音条件语音生成等。
副语言相关任务:副语言指的是伴随口语的非语言交流元素。它包含了传达超越实际所说词语的意义的各种发声属性。这些元素可以显著影响信息被解释和理解的方式。副语言的关键元素包括音高、音色、音量、语速、停顿等。这类任务相关的应用有:情感识别、语音分离和副语言增强生成等。
与文本大模型相似,SLMs也具有广泛的能力,这使得比较不同的 SLM 变得具有挑战性。因此,从各种角度评估SLM对于确定它们的有效性至关重要。根据现状,SLM的评估方式可以分为自动评估和人工评估两大类。
🤖自动评估
自动评估方法对于提供对SLM的快速且一致的评估至关重要。这些方法通常依赖于定量指标,无需人工干预即可计算。最常用的自动评估技术包含以下这些:
表征评估旨在衡量SLM的语言模型组件所学习到的内部特征或嵌入的质量和有效性。一般可以通过ABX测试或者语音重合成后计算CER来评估。
语言学评估是一种包括词汇、句法和语义评估方法,旨在评估模型生成和理解构建词语、句子和有意义内容的规则的能力。一般可以通过给定词让模型判断是否是真实或者给定句子判定语法是否正确等方法。
副语言评估旨在衡量SLM 捕捉和生成语音表现力的能力。主要通过关注准确性、一致性和表现力三个方面。可以通过计算生成语音与对应的韵律标签之间的距离来衡量。
生成质量的多样性,质量和多样性是模型生成中两个至关重要的方面。通常,在以不同温度对模型响应进行采样时,这些维度之间存在着权衡。可以通过困惑度上的 AUC来评估。
实时交互评估涉及评估 SLM进行实时交互的能力,这对于那些支持流式或全双工交互的模型至关重要,可以通过实时生成语音的自然度和有用性来评估。
下游任务评估指的是评估SLM执行特定任务的能力,例如ASR(、TTS、说话人识别等任务。
👤人工评估
人工评估在评估 SLM的性能中起着至关重要的作用,因为归根结底,语音是设计给人类听觉和感知的。这种评估依赖于人类的判断来评估 SLM所生成输出的质量。几种常用的人工评估方法如下:
平均意见得分是语音评估领域中一个广泛使用的指标,它用于量化人类听众对语音输出感知质量的判断。通常,一组评估员会听取 SLM 生成的一系列音频样本,并根据预定义的量表(通常为 1 分 [差] 到 5 分 [优秀])对每个样本进行评分。
自然度评估是衡量SLM输出语音听起来是否像真人说话、是否流畅、自然的度量。
音色相似度评估主要用于声音克隆 或个性化语音合成技术中,它衡量的是合成语音的音色与目标说话人的声音有多像。
语音大模型作为大模型技术在语音和听觉领域的延伸,正处于快速发展阶段。语音大模型在智能媒体监控、社会公共安全、以及复杂的人机交互场景(如客服、车载系统、智能家居)中的定制化应用需求日益增加。模型的强大理解和生成能力有望大幅度提升用户体验,然而在实际落地过程中仍然存在诸多挑战。
参考文献:
[1].https://arxiv.org/pdf/2410.03751
[2].https://zhuanlan.zhihu.com/p/1967542504430761267
