
 语音小管家
来源丨乐百一家
01、先说说背景:现有方法的坑在哪?
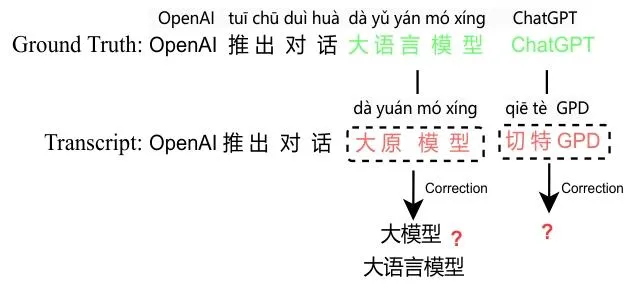
“大语言模型”被ASR转成“大原模型”,俩词字面差挺多;
“Midjourney”转成“米德仲尼”(英文变中文音译);
“灵耀X”转成“01X”(汉字变数字);
“ChatGPT”转成“Check GPT”(拼写差一截)。
02、创新点:SS+GL方法,不看“脸”看“声音”+“智能标注”
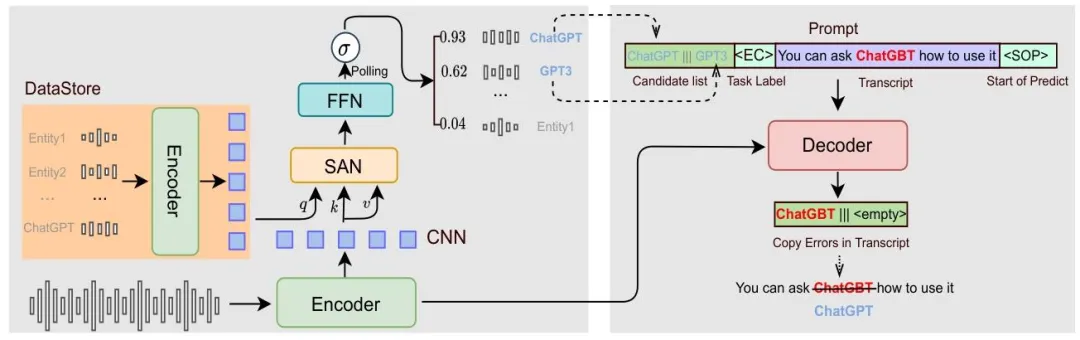
用TTS(文本转语音)把每个实体转成语音,比如把“ChatGPT”读出来生成音频;
用ASR的编码器处理这个音频,再加个CNN层降维,提取出这个实体的“语音特征”(相当于身份证号);
最后存成“语音特征-实体”的键值对,比如“ChatGPT的语音特征 → ChatGPT”,以后查的时候用。
先把这段语音也用同样的编码器+CNN,提取出它的语音特征;
用SAN(自注意力网络)和FFN(前馈网络)算一算:这段语音的特征和数据库里哪个实体的特征“更像”,得出一个概率(比如和“ChatGPT”的相似度是0.8,和“长江白鲟”是0.2);
选概率高于0.3的Top 5个实体当“候选”,比如选到“ChatGPT”“GPT-4”这俩,下一步就用它们来纠正。
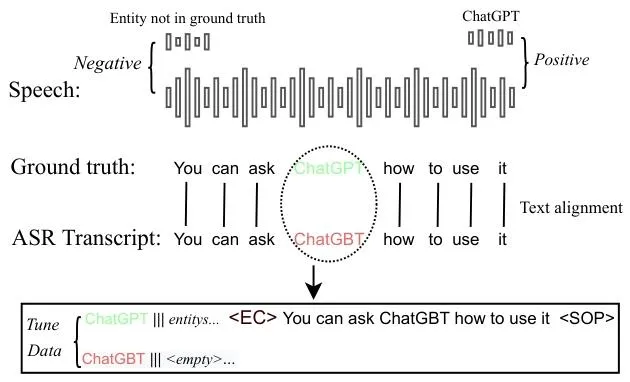
先做个“提示词(Prompt)”:用“|||”把候选实体拼起来,再用“ ”接上ASR的错误转录本。比如候选是“ChatGPT”,转录本是“You can ask ChatGBT how to use it”,Prompt就是“ChatGPT||| You can ask ChatGBT how to use it”; 让纠正模型读这个Prompt,自动“标出”转录本里的错词——这里就会标出“ChatGBT”; 如果没找到对应错词(比如这段语音里根本没有候选实体),模型会生成“ ”,意思是“不用改”,避免瞎纠正(比如把“韩语”错改成“韩宇”); 最后把标出的错词,换成数据库里对应的正确实体,比如把“ChatGBT”换成“ChatGPT”,搞定!
03、实验怎么做的?挺细致的
Aishell测试集:从Aishell的开发集和测试集里挑了3101个去重实体,测通用场景;
BuzzWord测试集:自己建的“难点集”,1500段2023-2024年的语音——500段是“正例”(含新词、外来词、数字实体,比如“ChatGLM-6B”“苍兰诀”“Matebook D16”),1000段是“负例”(不含实体),还特意平衡了男女说话人,模拟真实场景。
CER:整体字符错误率(越低越好);
NNE-CER:非实体部分的错误率(越低越好,要是这数高了,说明把不该改的改了,过纠正);
NE-CER:实体部分的错误率(越低越好);
NE-Recall:实体召回率(越高越好,意思是“能把多少实体从错的里捞对”)。
原始Whisper(没纠正的ASR结果);
PED-NEC(传统的基于编辑距离的方法);
PED+GL(用PED找候选,用新的GL纠正);
SS+NEC(用新的SS找候选,用传统PED纠正)。
04、实验结果:SS+GL直接“封神”,图表说话!
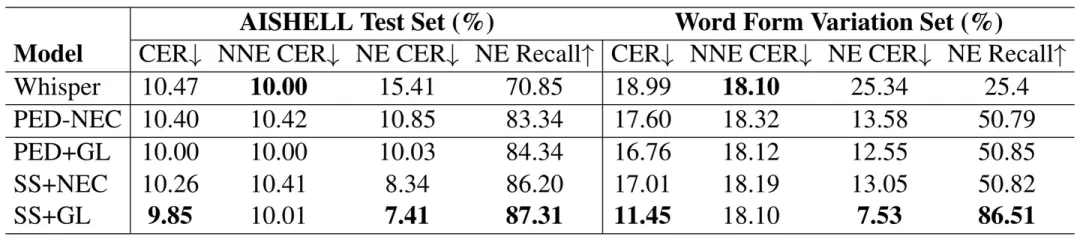
原始Whisper最差,实体召回率才70.85%; PED-NEC比Whisper好,但有个问题:NNE-CER从10.00升到10.42,说明它有点“瞎改”,把非实体的内容也改坏了(过纠正); 而SS+GL呢?所有指标都最优:整体CER最低(9.85),实体错误率最低(7.41),实体召回率最高(87.31,比PED-NEC高4个百分点),而且NNE-CER几乎和Whisper一样(10.01),没怎么过纠正——这就很牛了!
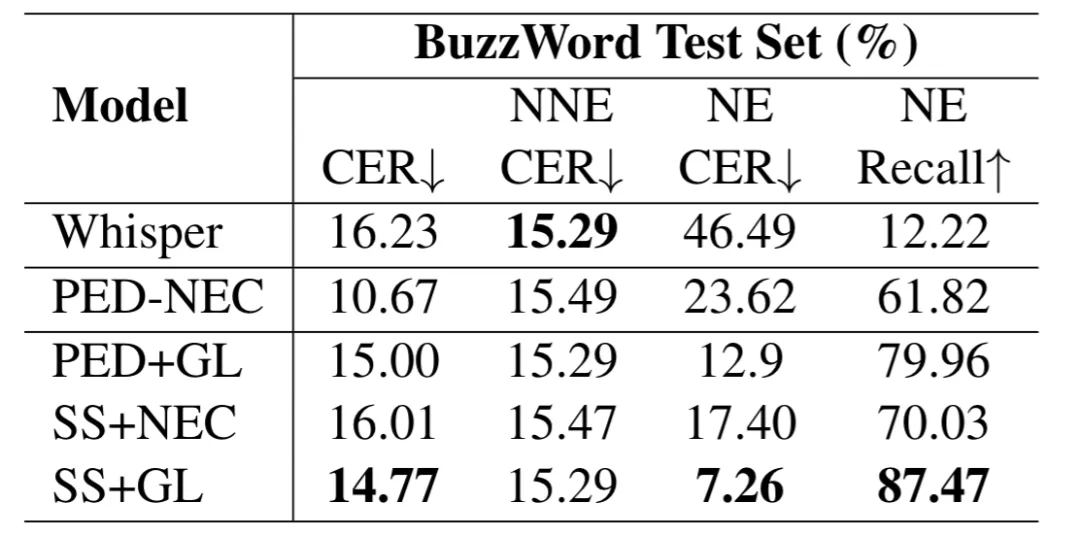
原始Whisper在这直接“崩了”,实体召回率才12.22%——10个实体里才对1个多,可见这些新词多难认; PED-NEC虽然比Whisper好,但召回率也才61.82%,实体错误率还有23.62%; 再看SS+GL:实体召回率直接冲到87.47%,比PED-NEC高了26个百分点!实体错误率也降到7.26%,而且NNE-CER还是15.29,没瞎改非实体内容——这就证明,对付“长得不一样”的新词、外来词,SS+GL是真的行。
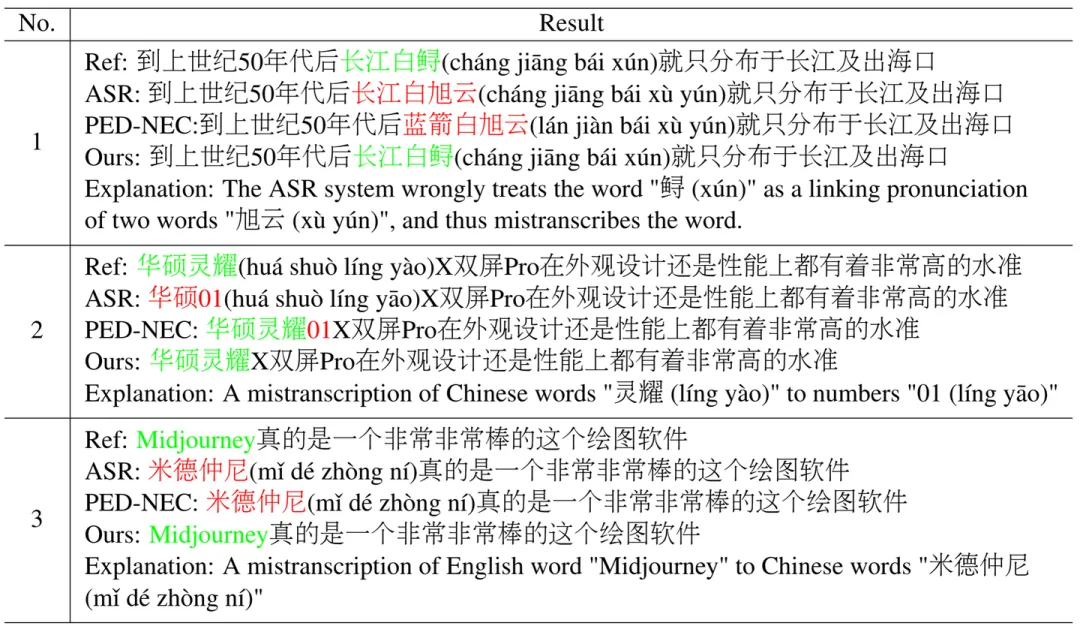
案例1:“长江白鲟”被转错 ASR转录:“到上世纪50年代后长江白旭云就只分布于长江及出海口”(把“鲟xún”转成“旭云xù yún”); PED-NEC纠正:“到上世纪50年代后蓝箭白旭云就只分布于长江及出海口”(居然把“长江”改成“蓝箭”,更错了); SS+GL纠正:精准改回“长江白鲟”——因为它看的是语音特征,不管“旭云”和“鲟”字面差多少。
案例2:“Midjourney”被转成中文音译 ASR转录:“米德仲尼真的是一个非常非常棒的绘图软件”; PED-NEC:完全没法改,只能保留“米德仲尼”; SS+GL:直接改回“Midjourney”——英文变中文音译也不怕,语音特征能对上。
案例3:“灵耀X”被转成“01X” ASR转录:“华硕01X双屏Pro在外观设计还是性能上都有很高水准”; PED-NEC:只改了一部分,变成“华硕灵耀01X双屏Pro”(还留着“01”); SS+GL:精准改回“华硕灵耀X双屏Pro”——数字和汉字的差异也能搞定。
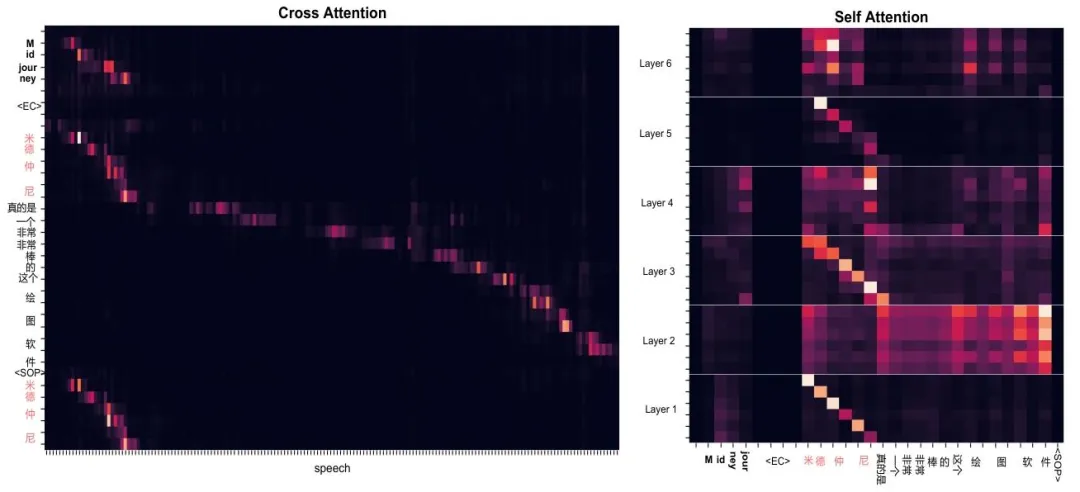
模型标注的错误文本(比如“米德仲尼”)、候选实体(比如“Midjourney”),还有对应的语音片段,这三者之间的注意力值特别高; 这就说明模型真的把“错词-候选实体-语音”三者关联起来了,不是瞎标错词,标注是有依据的。
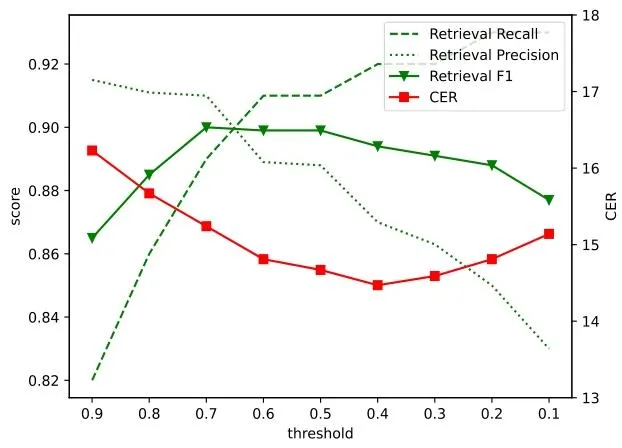
有意思的是:不是检索F1越高,纠正效果越好;反而当阈值低一点(比如0.3左右),检索召回率高、精度低的时候,纠正的CER最低; 原因很简单:SS+GL的GL模块能“容错”——就算检索多找了几个不太准的候选,GL也能通过生成“ ”排除掉,不用怕候选里有“杂质”。
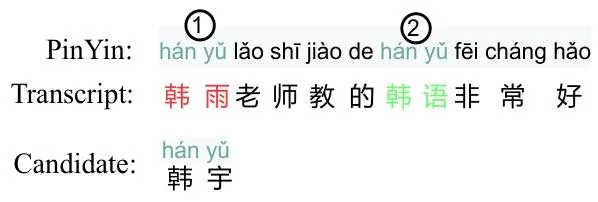
PED-NEC:因为发音一样,把俩都改成“韩宇”了,造成过纠正; SS+GL:只把“韩雨”改成“韩宇”,“韩语”不动——因为GL模块能结合语境判断,知道“韩语”不是人名,不用改,避免了瞎改的问题。
05、这方法的优势:不止“改得对”,还“很智能”
联合标注有效:图4已经证明了,模型能精准关联“语音-候选实体-错词”,不会标错对象;
实体拒绝能力强:检索时能滤掉低相似度的候选,GL还能生成“ ”跳过不用改的,所以检索时可以放宽阈值,多找候选也不怕,反而能提高召回率;
自带CED功能:CED是“错误实体检测”,传统PED-NEC得单独加个CED模块才能找错词,而SS+GL的GL模块在生成错词的过程中,就已经完成了“检测错词”的步骤,不用额外加模块,更简洁。
06、结论和小局限
SS+GL真的解决了“错词和实体长得不一样”的核心问题,在开源ASR(Whisper)和商业ASR(讯飞、亚马逊Transcribe)上都好用,通用性强; 论文里的训练数据和测试集都开源了(地址:https://github.com/L6-NLP/Generative-Annotation-NEC),别人也能复现实验。
