
 语音小管家
语音识别(ASR)一直是 AI 语音领域的“硬骨头”。在世界上7000多种活跃语言中,只有几百种享受过现代语音技术的「宠爱」。绝大多数人类语言的使用者——从非洲部落的土著、亚马逊雨林的族群,到乡野小镇仍讲着古老方言的老人—— 一直生活在数字时代的旁白之外。全球语言多样、数据不平衡,想让模型听懂世界上绝大多数人说的话,难度可想而知。
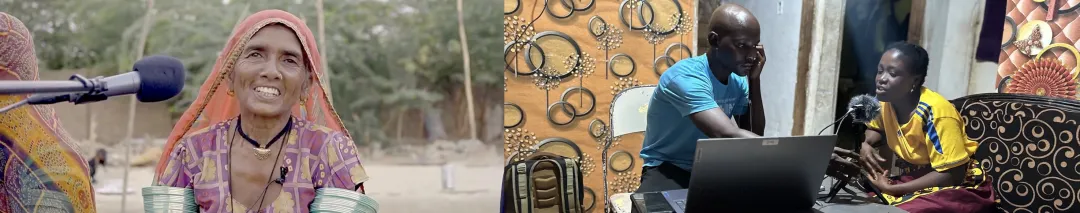
而 Meta 研究团队这次开源的Omnilingual ASR,让几乎所有人类语言都能被机器「听懂」。
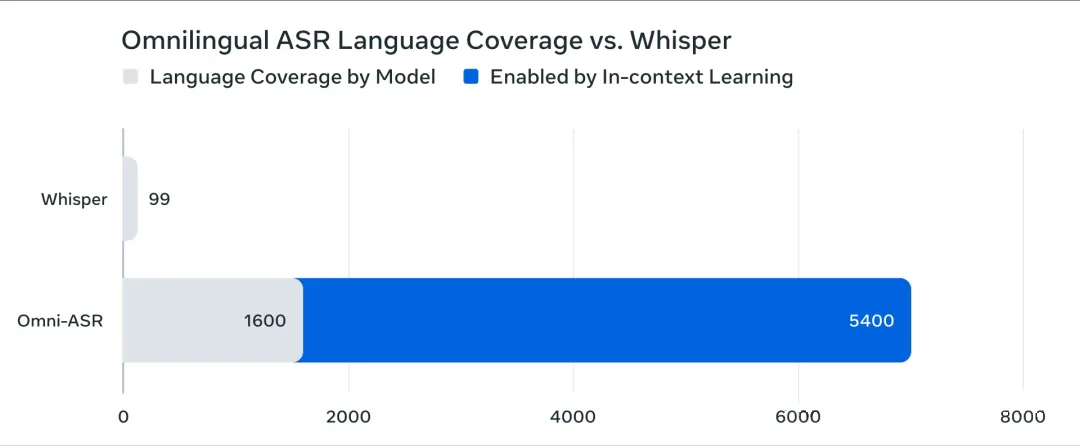
Meta此次推出的Omnilingual ASR创造了语音识别覆盖语言数量的新纪录,支持超过1600种语言,其中包括500种此前从未被任何AI系统转录过的语言。并且只需几条语音-文本配对样本就能实现零样本扩展新语种——也就是说,哪怕模型没见过这种语言,只要你给几条例子,它也能开始“听懂”!
相比之下,OpenAI开源的Whisper模型只支持99种语言,而Omnilingual ASR几乎将这一数字提升了一个数量级。
它提供了三种架构——SSL、CTC和LLM,每种架构从300M到7B参数不等,满足不同需求。CTC架构速度快,最高96倍实时,适合批量转写;LLM可零样本识别,准确率高,有78%的语种其识别错误率(CER)低于10%;SSL用于预训练或特征提取。
核心特性
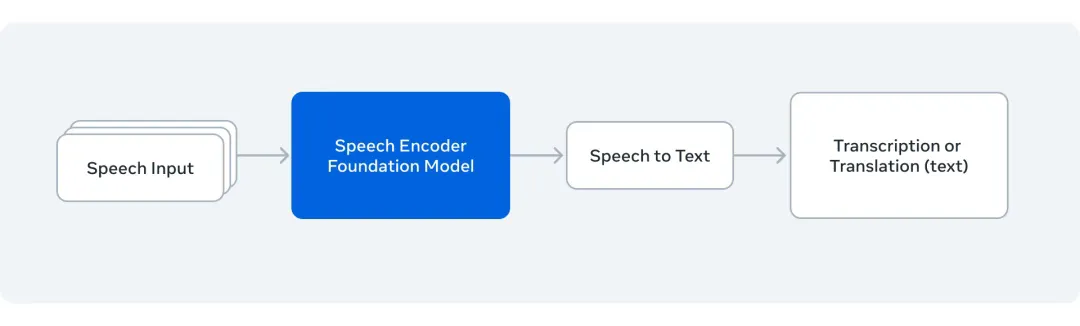
模型架构概览
Meta 在项目中提供了三种架构版本,从轻量级到高精度全覆盖不同应用场景:
这种设计非常灵活:
想要快→用CTC;想要懂语义→用 LLM;想要做自训练或特征迁移→用 SSL。
性能表现
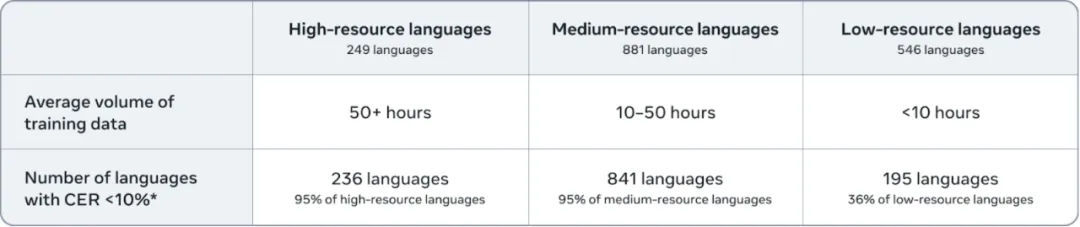
Meta 官方数据显示:
• 在 1600 种语言 上平均错误率显著低于现有多语种模型 • 78% 的语言 错误率(WER)低于 10% • 对于低资源语言,准确率提升可达 3–5 倍 • CTC 模型最高实现 96× 实时速度(即 1 分钟音频仅需 0.6 秒转写)
应用场景
写在最后
正如研究论文所指出的,「没有任何模型能预先涵盖世界上所有语言,但Omnilingual ASR让社区能够用自己的数据持续拓展这份清单」。
这标志着语音AI从此具备了自我生长的生命力,能够与人类语言的丰富多样性共同进化。当技术放下傲慢,以开源姿态拥抱多元,当每一种语言的声音都有机会被聆听和记录,当没有任何一种语言被数字世界遗忘,我们离真正消弭语言鸿沟又近了一大步,人类的连接才能真正开始消除边界。
