语音小管家
今天,火山引擎发布了豆包语音合成模型2.0(Doubao-Seed-TTS 2.0)和豆包声音复刻模型2.0(Doubao-Seed-ICL 2.0)。此次升级基于豆包大语言模型研发语音合成新架构,让合成和复刻的声音都能解锁深度语义理解和上下文理解能力,从单纯的文本朗读进化为“理解后的精准情感表达”。
此外2.0模型针对教育场景专项优化,使得全科复杂公式符号的合成平均准确率高达90%左右。
⏩懂语义知语境,对话式语音合成新能力
对话式合成让豆包语音合成模型2.0像是一位会思考的“演绎者”,让声音具备深度语义理解能力,并进一步将理解范围从给定文本扩大到多轮对话,理解包括:对话中的用户 Query、明确的自然语音指令,以及描述性的内心活动、背景信息、细腻情感等,让 AI 语音从“听得清”转变到“懂语义知语境”的情感式表达。对话式语音合成具备3大核心优势:
更强的互动拟人感:精准呈现与场景匹配的语气、语调、停顿等,让交互充满真实人际沟通的自然感。
更饱满的情感演绎:深度理解文字背后的情绪延续与变化,让声音的情绪承接更饱满连贯。
更精准的指令遵循:实现语速、情绪、声线、风格、音调的精准指令控制,提升语音表现可控性。
⏩声音复刻拥有更强情感理解能力
豆包声音复刻模型1.0仅需5秒即可还原用户声音核心特征,轻松实现“声似”。但随着用户对个性化声音交互的需求升级,单一的声线复刻已无法满足对“更拟人、更富情感的生动表达”的追求。豆包声音复刻模型2.0同样具有深度语义理解能力,在语音交互、小说配音、播客对话等场景中具备更强的声音表现力。
⏩复杂公式符号朗读正确率90%
在日常教育辅导场景中,复杂公式或单位缩写等通常包含大量特殊符号和多层嵌套结构等问题,导致目前普遍朗读的准确率低于50%,难以支持学科辅助场景下严谨的语音交互需求。
豆包语音合成模型2.0和豆包声音复刻模型2.0提升了学科教育场景下复杂公式符号的朗读表现,针对教育场景进行数据增广与模型优化,涵盖单位、函数、幂数、面积、化合物、复分解等上百种类,经过大量客户真实场景的复杂公式评测集测试验证,在小学至高中全学科(数学、英语、化学、物理、地理、生物)的复杂公式符号朗读任务中,平均准确率达90%左右。
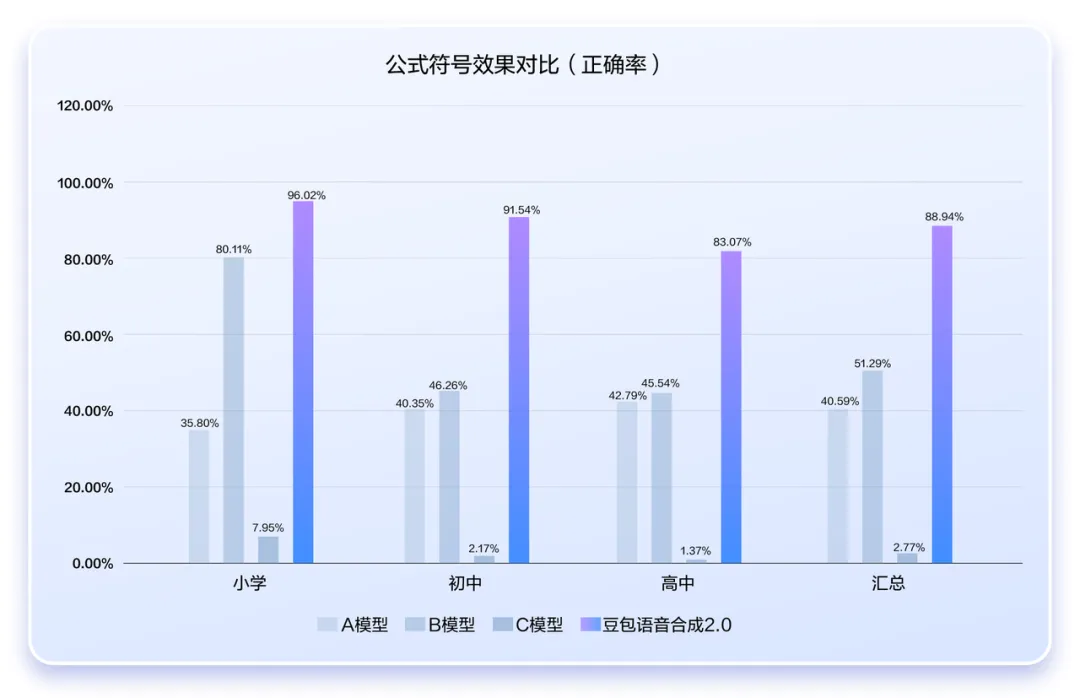
从“文本朗读”到“情感演绎”,豆包语音合成模型2.0和豆包声音复刻模型2.0为语音注入了更强的理解力与表现力。
⏩语音模型外的其他升级
除了语音上的大动作之外,火山引擎这次在基座模型和多模态方面,同样也有不少的动作。
首先,作为技术底座的豆包大模型1.6迎来了重要升级。
此次升级最大的亮点是,它成为了国内首个原生支持分档调节思考长度的Thinking模型。
在实际应用中,深度思考模型常因推理时间过长而导致响应延迟和成本高昂,这成为许多企业望而却步的门槛。
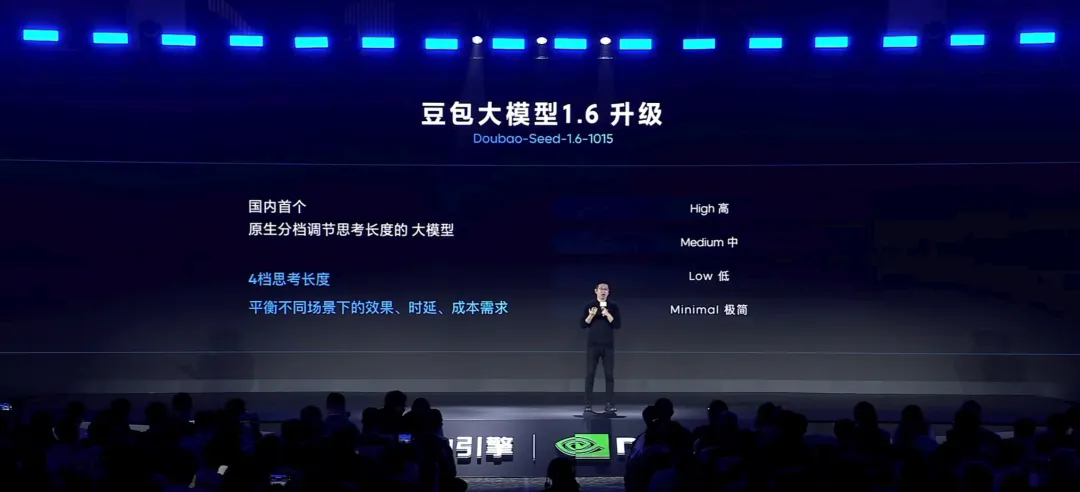
豆包大模型1.6通过训练四种不同的思考模式,让客户可以在效果、时延、成本三者之间找到最适合自身业务的平衡点。
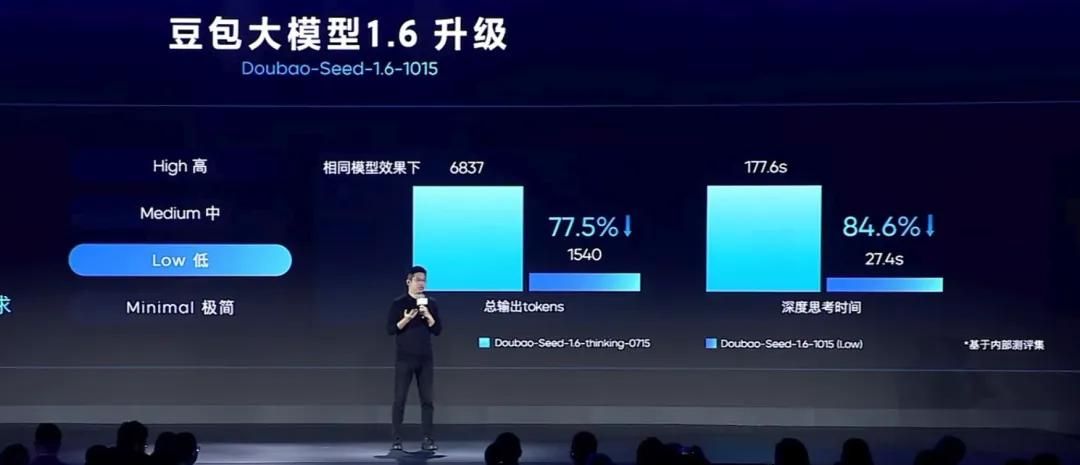
例如,在低思考长度模型下,模型效果与升级前保持不变,但总输出tokens下降了77.5%,深度思考时间更是大幅缩短了84.6%。
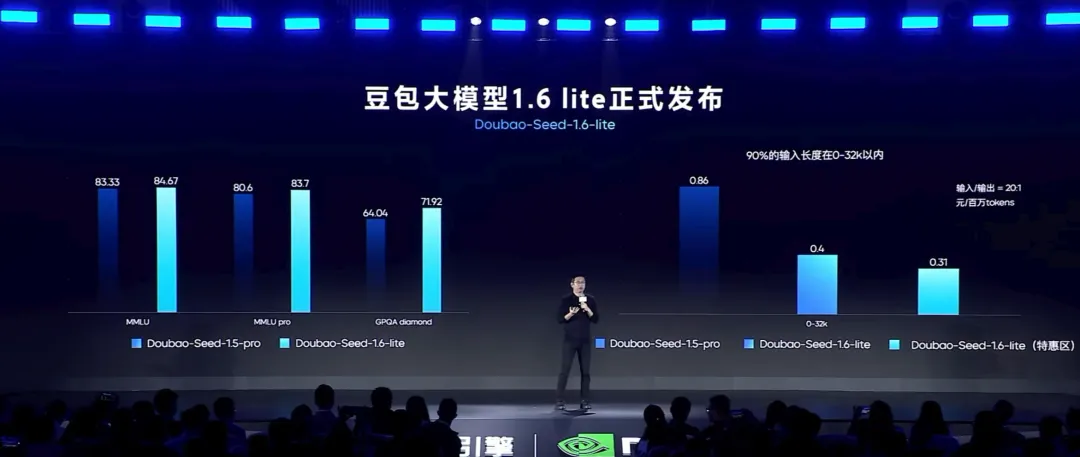
与此同时,火山引擎还首次推出了轻量化的豆包大模型1.6 Lite,为不同应用场景提供了更灵活、高效的选择。
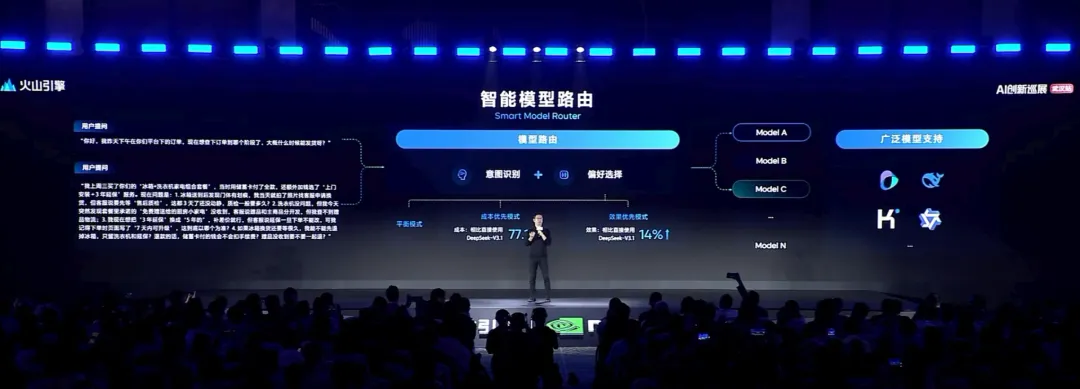
更进一步,火山引擎在国内首次发布了智能模型路由(Smart Model Router)。