
 语音小管家
在自然人机交互中,实现如同人类般“边听边说”的全双工语音对话(Full-duplex Spoken Dialogue)一直是语音交互系统的终极目标。与传统的半双工系统不同,全双工系统要求模型能够在用户发言过程中,实时判断是否需要继续倾听、生成回应或保持静默。这一“轮次检测(Turn-taking Detection)”任务极具挑战,因为它需要同时理解语音信号中的声学线索与语言语义。
西北工业大学音频语音与语言处理研究组(ASLP@NPU)开源一套轮次检测方案,包括轻量、高效、即插即用的全双工轮次转换检测模型 Easy Turn ,1145小时的训练数据集Easy Turn Trainset 和完备测试集 Easy Turn Testset,附带技术报告,现对该工作进行简要的解读和分享。
论文题目:Easy Turn: Integrating Acoustic and Linguistic Modalities for Robust Turn-Taking in Full-Duplex Spoken Dialogue Systems
作者列表:李国健、王成有、薛鸿飞、王水源、高德辉、张子晗、林宇柯、李文杰、肖龙帅、付中华、谢磊
论文网址:https://arxiv.org/abs/2509.23938
Github主页:https://github.com/ASLP-lab/Easy-Turn
Demo Page:https://aslp-lab.github.io/Easy-Turn/
Hugging Face:https://huggingface.co/ASLP-lab/Easy-Turn
在自然人机语音交互中,实现如同人类般“边听边说”的全双工对话(Full-duplex Dialogue)是语音助手和智能客服等系统的重要目标[1]。与传统半双工模式不同,全双工系统需要在用户发言时实时判断何时该倾听、回应或保持静默,这一“轮次检测(Turn-taking Detection)”任务对模型的时序感知和多模态理解提出了更高要求。
当前方法主要有两类:其一是独立的轮次转换检测模型,如TEN Turn Detection[2]和Smart Turn V2[3],但前者体量庞大且仅支持文本输入,后者虽轻量但语义理解能力有限;其二是直接微调大型语言模型以具备全双工能力,如Moshi[4]、GLM-4-Voice[5]等,但这需要大规模全双工语料,而公开数据极为稀缺。
针对上述问题,西北工业大学音频语音与语言处理研究组(ASLP@NPU)开源了Easy Turn解决方案,一种融合声学与语言双模态的开源轮次转换检测模型。该模型轻量高效、即插即用、支持四类对话轮次状态,并同步开源大规模训练与测试语料,为全双工语音交互研究提供了坚实基础。此外,我们发布的Easy Turn也将作为 ICASSP2026 HumDial Challenge 赛道二的baseline,欢迎大家使用。
ICASSP2026 HumDial Challenge 全球征集令:打造类人语音对话系统!
Turn States
Easy Turn 模型支持四种典型的对话轮次状态:
Complete:语义完整,用户已表达完毕,系统应立即回应。比如“你能给我推荐一部电影吗?”。
Incomplete:语义不完整,用户仍在组织语言,系统需继续倾听。比如“我想请问....”。
Backchannel:用户的简短反馈,如“嗯”“好的”,不应打断系统发言。
Wait:用户明确要求暂停或结束对话,如“对话终止”,“停一下”。
这些状态全面刻画了全双工人机交互中最常见的轮次转换行为,有助于模型在复杂语境下实现更自然的响应策略。
Easy Turn Trainset
Easy Turn Trainset是论文核心资源之一,音频总时长达1145小时,覆盖上述四类对话轮次状态。语料由真实对话与高质量合成数据组成,其中真实部分来源于大型开源中文对话数据集 MagicData-RAMC[6],经由大语言模型交叉标注过滤以确保对话轮次状态标签的准确性;合成部分则由 DeepSeek V3 与 Qwen2.5 系列模型生成不同对话轮次状态的文本,再通过 CosyVoice 2 等语音合成(TTS)工具合成语音,并使用语音识别(ASR)模型 Paraformer 对音频进行验证,仅保留WER=0的样本。这种“真实+合成”结合的策略有效弥补了真实人机交互语料不足的问题,提高了模型的泛化能力。详细的数据处理流程见下图。
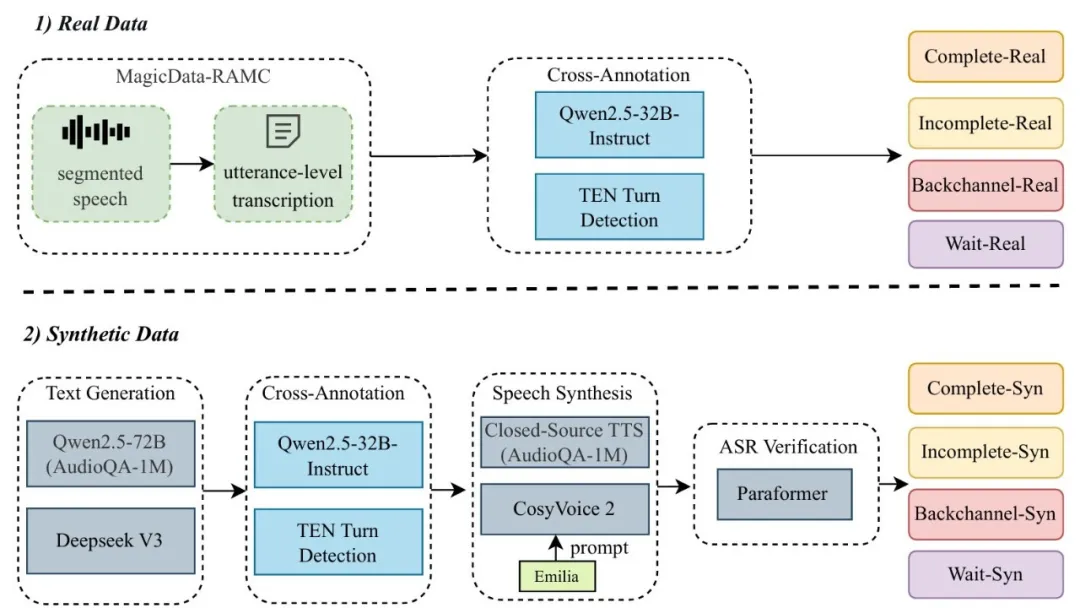
图1 Easy Turn的详细数据处理流程
Easy Turn Testset
为公平评估模型性能,我们构建了Easy Turn Testset。测试集涵盖四种轮次状态:Complete 与 Incomplete 各300条,Backchannel 与 Wait 各100条,真实与合成样本比例1:1。所有标签均经人工校对,以保证准确性和一致性。测试集覆盖闲聊与人机任务两类场景,为全双工轮次转换检测提供了标准化评测基准。
我们的轮次检测模型Easy Turn由三部分组成:音频编码器(audio encoder)、音频适配器(audio adaptor) 和 大语言模型(LLM)。其设计借鉴了 Qwen-Audio [7]的思想,采用 Whisper 作为音频编码器,Qwen2.5-0.5B-Instruct 作为大语言模型。模型整体架构如图2所示。
具体而言,音频编码器采用Whisper-Medium模型[8],包括两个一维卷积层和 24 个 Transformer 层,在语音理解能力与推理效率之间取得了良好平衡。Adaptor 模块采用三层一维卷积和四层 Transformer 的混合结构,高效衔接音频编码器输出与语言模型输入,实现稳健的模态对齐。不同于使用大型 LLM 进行多任务处理的 Qwen-Audio,本研究专注于轮次检测任务,因此选用更轻量的Qwen2.5-0.5B-Instruct[9],以提升训练与推理效率。
为更好地融合声学与语言模态,Easy Turn 采用ASR + Turn-Detection范式。在该框架下,LLM 先生成语音识别(ASR)转录,再结合声学特征顺序预测对话轮次状态标签(complete、incomplete、backchannel、wait)。为实现这一范式,研究者设计了自然语言提示词(prompts)来引导 LLM,由 DeepSeek V3 生成五种候选提示,并在训练中随机采样以增强鲁棒性。最终,Easy Turn 以语音信号和提示词为输入,输出相应的 ASR 转录及轮次状态,实现声学与语言信息的统一建模。
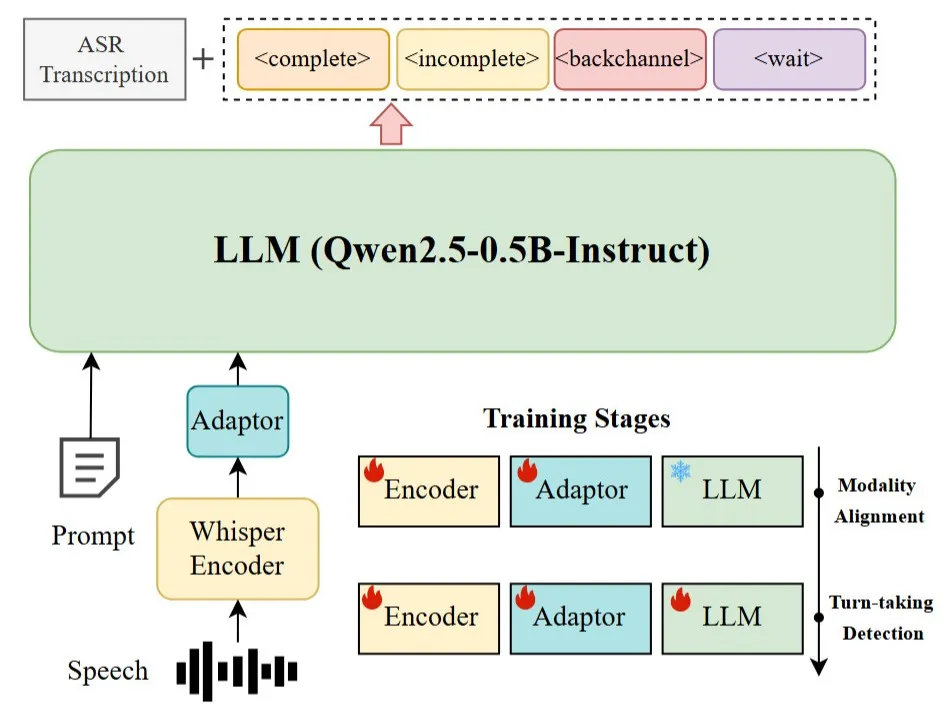
图2 Easy Turn模型架构与训练阶段
实验设置
Easy Turn 模型训练分为两阶段:(1)第一阶段进行模态对齐训练,使声学特征与语言空间对齐,使用约2.3万小时ASR语料(包含Aishell1,Aishell2,WenetSpeech等开源ASR数据集)。此阶段仅更新声学编码器与音频适配器参数。(2)第二阶段在 Easy Turn Trainset 上进行微调,解冻所有参数,实现针对轮次转换检测任务的优化。实验在8张 RTX4090 GPU 上完成,训练框架基于 WeNet。
Easy Turn 模型的推理在单张 RTX4090 GPU 上进行,并采用贪心解码以兼顾速度与准确性。
主要结果
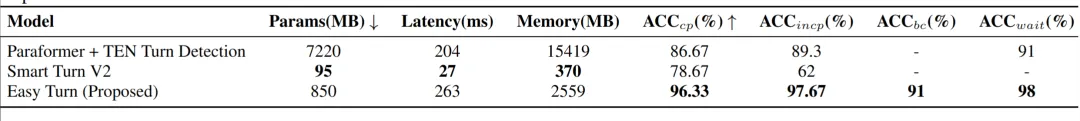
论文在开源测试集Easy Turn Testset上与现有开源的轮次转换检测模型进行了系统对比。结果显示,Easy Turn在全部四类状态上均显著优于现有开源模型,实现最高的轮次转换识别准确率。这得益于ASR + Turn-Detection范式所带来的跨模态信息补充,使音频特征与语义信息得到同步建模。同时Easy Turn模型在规模较小,推理延迟较低、显存占用较小的基础上,达到了最优的效果,具备部署友好性。
表1 Easy Turn与其他开源模型的效果对比
消融实验
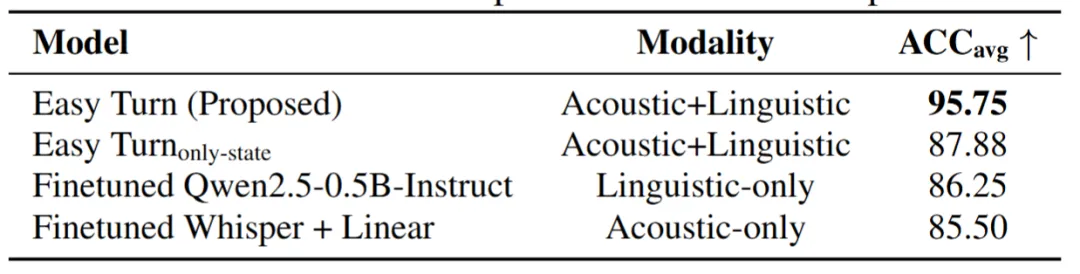
为分析不同模态与ASR+Turn-Detection范式的贡献,作者进行了多组消融实验。如下表所示,仅使用声学或语言模态的模型表现均较差,而去除 ASR+Turn-Detection范式会导致性能显著下降。相比之下,Easy Turn 结合 Whisper-Medium 音频编码器、音频适配器与轻量级 0.5B 参数的语言模型,通过 ASR+Turn-Detection 范式实现声学与语言模态的有效融合,从而取得了更优的性能。
表2 消融实验
应用示例
如下图所示,我们展示了Easy Turn在语音对话系统中的若干应用示例。为了评估其在轮次检测中的性能,我们将 Easy Turn 部署在我们实验室的语音对话系统OSUM-Echat[10]中,用户通过麦克风与系统进行交互。实验结果表明,Easy Turn 能够有效工作,准确识别对话轮次状态,从而使系统能够做出恰当的响应。
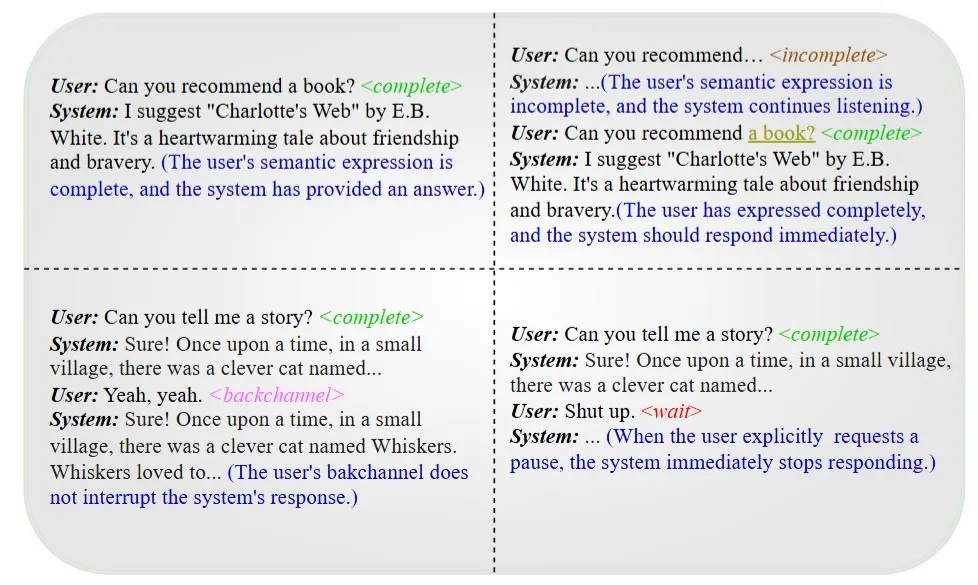
图3 Easy Turn 应用实例
[1] Ting-En Lin, Yuchuan Wu, Fei Huang, Luo Si, et al., “Duplex conversation: Towards human-like interaction in spoken dialogue systems,” in Proceedings of the 28th ACM SIGKDD Conference on Knowledge Discovery and Data Mining, 2022.
[2] https://github.com/ten-framework/ten-turn-detection
[3] https://github.com/pipecat-ai/smart-turn
[4] Alexandre D´efossez, Laurent Mazar´e, Manu Orsini, Am´elie Royer, et al., “Moshi: a speech-text foundation model for real-time dialogue,” arXiv preprint arXiv:2410.00037, 2024.
[5] Xiong Wang, Yangze Li, Chaoyou Fu, Yunhang Shen, et al., “Freeze-omni: A smart and low latency speech-to-speech dialogue model with frozen llm,” arXiv preprint arXiv:2411.00774, 2024.
[6] Zehui Yang, Yifan Chen, Lei Luo, Runyan Yang, et al.,“Open source magicdata-ramc: A rich annotated mandarin conversational (ramc) speech dataset,” arXiv preprint arXiv:2203.16844, 2022
[7] Yunfei Chu, Jin Xu, Xiaohuan Zhou, Qian Yang, et al.,“Qwen-audio: Advancing universal audio understanding via unified large-scale audio-language models,” arXiv preprint arXiv:2311.07919, 2023.
[8] Alec Radford, Jong Wook Kim, Tao Xu, Greg Brockman, et al., “Robust speech recognition via large-scale weak supervision,” in Proceedings of the International Conference on Machine Learning (ICML), 2023.
[9] Yang An, Yang Baosong, Zhang Beichen, Hui Binyuan, et al., “Qwen2.5 technical report,” arXiv preprint arXiv:2412.15115, 2024.
[10] https://github.com/ASLP-lab/OSUM/tree/main/OSUM-EChat
