
 语音小管家
NeurIPS,即神经信息处理系统大会(Conference on Neural Information Processing Systems),是由神经信息处理系统基金会(NeurIPS Foundation)主办的全球机器学习与人工智能领域顶级学术盛会,被誉为该领域的 “风向标”,其影响力覆盖学术研究与产业实践全链条。
本期分享上海交通大学 X-LANCE 跨媒体语言智能实验室中稿的5篇论文。
⏩01、MMAR: A Challenging Benchmark for Deep Reasoning in Speech, Audio, Music, and Their Mix
论文作者:马子阳,马英浩,朱彦桥,杨晨,赵怡雯,徐瑞阳,陈文熙,陈远哲,陈卓,从坚,李凯,李柯良,李思佑,李鑫锋,李希泉,连政,梁宇哲,刘明皓,牛志康,王天锐,王玉平,王雨轩,吴依豪,杨冠柔,余剑威,袁瑞斌,郑之胜,周子雅,朱海纳,雪巍,Emmanouil Benetos,俞凯,Eng-Siong Chng,陈谐
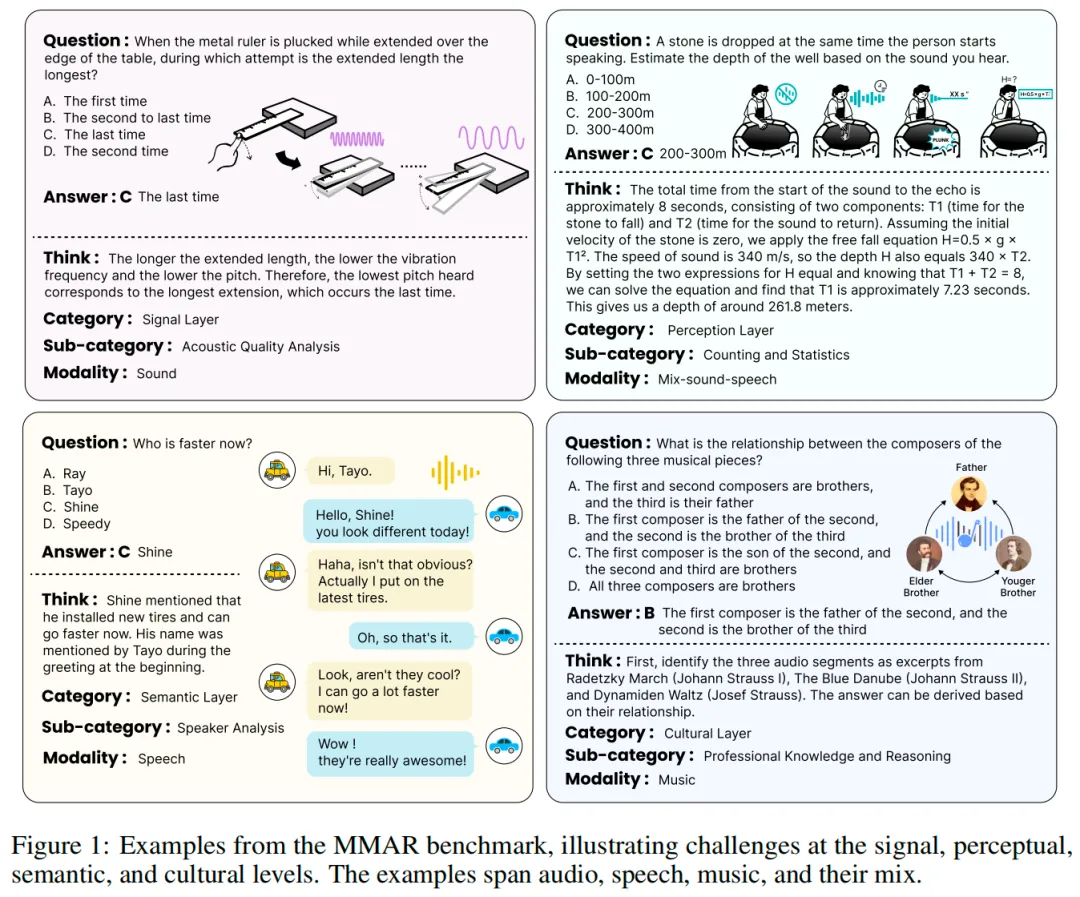
论文简介:我们提出了 MMAR,一个用于评估音频-语言模型(ALMs)深度推理能力的新型基准,涵盖大规模任务。MMAR 包含 1,000 个精心整理的音频-问题-答案三元组,这些数据来自真实的互联网视频,并经过多轮错误修正与质量检查,以确保高质量。不同于现有仅限于声音、音乐或语音等特定领域的基准,MMAR 将范围扩展到更广泛的真实世界音频场景,包括声音、音乐与语音的混合模态组合。在任务设计上,MMAR 的每个问题按照四个推理层次进行分层分类:信号层(Signal)、感知层(Perception)、语义层(Semantic)、文化层(Cultural),并在每一层中进一步细分子类别,以体现任务的多样性与复杂性。为了进一步推动该领域的研究,我们为每一道题目都标注了 Chain-of-Thought(CoT)推理过程,以促进未来音频推理方法的发展。基准中的每一项任务都要求模型进行超越表层理解的多步深度推理,其中一部分问题甚至需要研究生水平的感知和专业知识,从而大大提升了难度与深度。我们在 MMAR 上评估了多类模型,包括大规模音频-语言模型(LALMs)、大规模音频推理模型(LARMs)、全模态模型(OLMs)、大规模语言模型(LLMs)以及大规模推理模型(LRMs),输入形式为音频字幕。评测结果显示,MMAR 对模型具有极大的挑战性,而我们的分析进一步揭示了当前模型在理解和推理能力上的关键局限。这些发现凸显了音频-语言推理领域在数据和算法创新方面亟需更多研究关注。
我们希望 MMAR 能成为推动该领域未来发展的重要催化剂,为这一尚未充分探索的重要方向带来新的突破。
⏩02、Task-Specific Data Selection for Instruction Tuning via Monosemantic Neuronal Activations
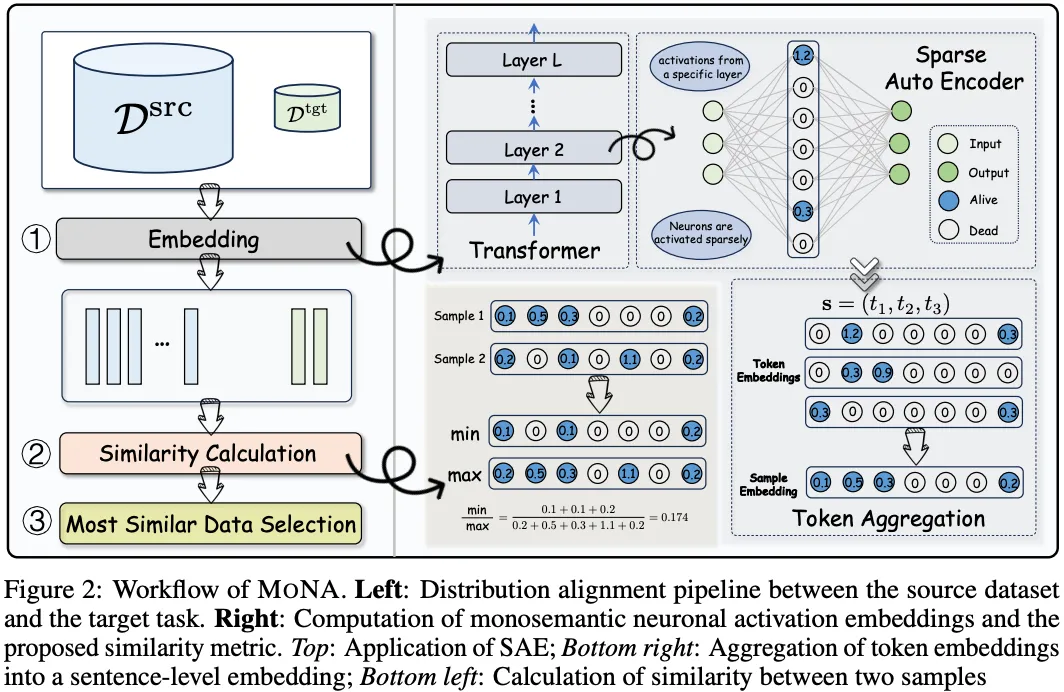
论文作者:马达,尚功虎,陈志,覃丽波,罗逸杰,潘磊,樊帅,陈露,俞凯
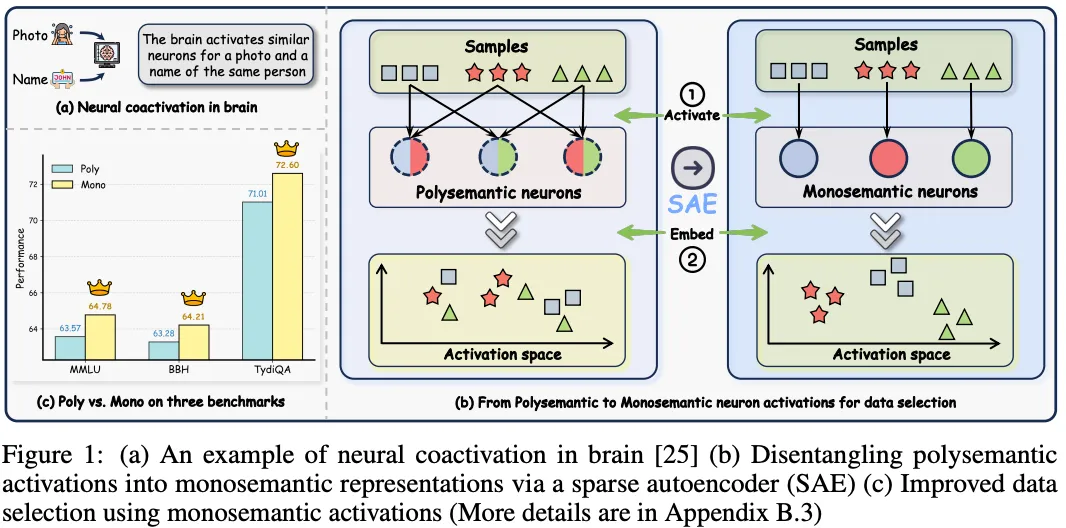
论文简介:指令微调提升了大语言模型(LLMs)对多样化人类指令的遵循能力,但在特定目标任务上取得优异表现仍然具有挑战性。一个关键瓶颈在于如何选择最相关的数据,以最大化任务特定的性能。现有的数据选择方法包括不稳定的基于影响力的方法和更为稳定的分布对齐方法,而后者在很大程度上依赖于底层的样本表示。在实际应用中,大多数分布对齐方法,无论是浅层特征(如 BM25)还是神经嵌入(如 BGE、LLM2Vec),都可能无法捕捉模型内部处理样本的方式。为弥补这一差距,我们采用了一种以模型为中心的策略,将每个样本表示为模型中的神经元激活模式,直接反映模型的内部计算过程。然而,直接使用原始神经元激活会导致无关样本之间出现虚假的相似性,这是因为神经元具有多义性,即单个神经元可能对多个无关概念产生响应。为了解决这一问题,我们利用稀疏自编码器将多义性激活解耦为稀疏且单义性的表示,并为这一空间引入了专门的相似性度量,以更好地识别与任务相关的数据。我们在多个指令数据集、模型、任务和选择比例上进行了全面实验,结果表明,我们的方法在稳定性和任务特定性能方面均持续优于现有的数据选择基线方法。
⏩03、MS-BART: Unified Modeling of Mass Spectra and Molecules for Structure Elucidation
论文作者:韩杨,王鹏宇,俞凯,陈忻,陈露
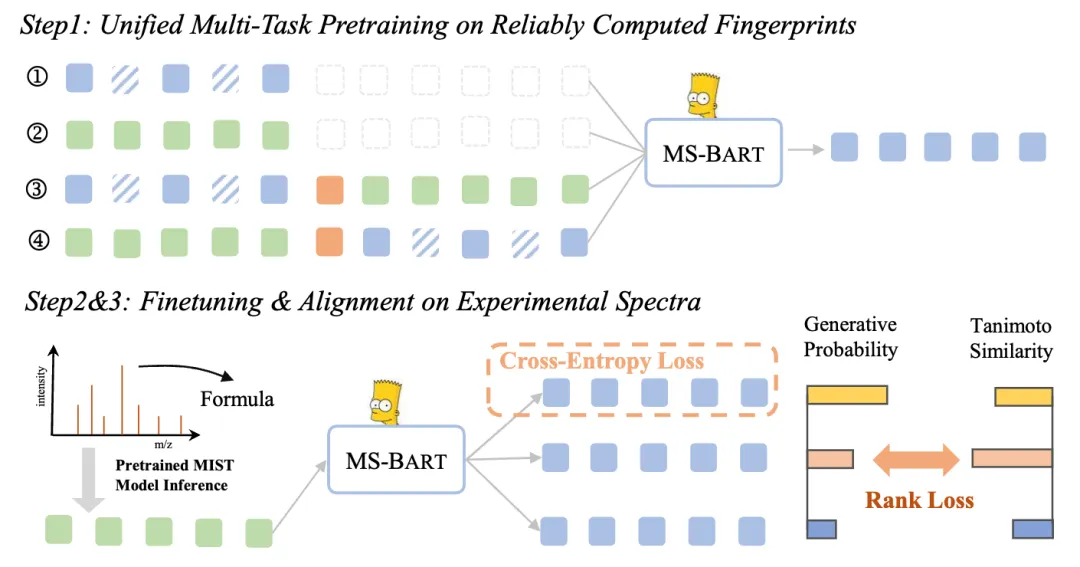
论文简介:质谱分析在分子鉴定中发挥着关键作用,极大地推动了科学发现。然而,由于标注谱图的稀缺,从质谱数据中解析分子结构仍然面临显著挑战。尽管大规模预训练已被证明能够有效缓解其他领域中的数据稀缺问题,但原始谱图信号的复杂性和异质性阻碍了该范式在质谱分析中的应用。为此,我们提出了MS-BART统一建模框架,将质谱图与分子结构映射到统一的词表空间,并基于计算得到的指纹-分子数据集进行大规模预训练,以实现跨模态学习。通过联合优化去噪与翻译任务的多目标预训练策略,进一步提升了MS-BART的泛化能力。该预训练模型随后在MIST(一种预训练的谱图模型)生成的分子指纹上进行微调,从而迁移至实验谱图,增强了对真实谱图差异的鲁棒性。尽管微调过程缓解了分布差异,MS-BART仍存在分子幻觉现象,需要进一步对齐。因此,我们引入了化学反馈机制,以引导模型生成更接近参考结构的分子。大量评估结果表明,MS-BART在MassSpecGym和NPLIB1基准的12项关键指标中有5项达到最优性能,并且其运行速度比基于扩散的竞争方法快一个数量级。同时,全面的消融实验系统验证了模型的有效性和鲁棒性。
⏩04、WritingBench: A Comprehensive Benchmark for Generative Writing
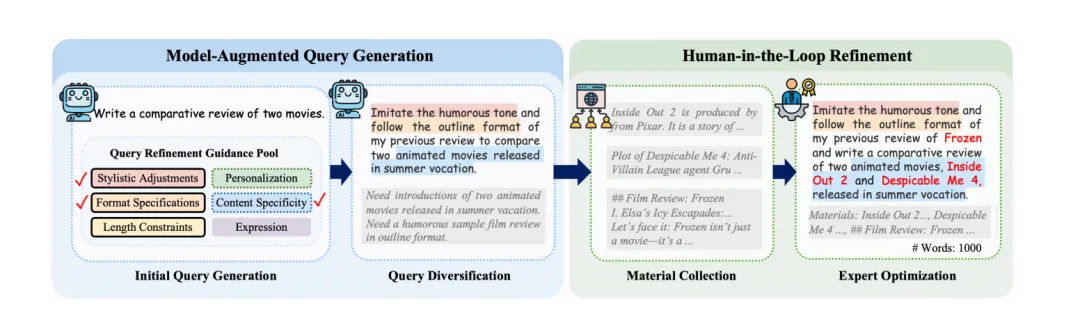
论文作者:吴宇宁,梅嘉豪,严明,李晨亮,赖少鹏,张佶,吴梦玥,金琴,黄非
论文简介:近年来,大语言模型(LLMs)的发展极大提升了文本生成能力,但在生成式写作场景中如何评估其表现仍是一个挑战。现有基准测试主要集中于通用文本生成,或仅涵盖有限的写作任务,难以全面反映高质量写作在不同领域中的多样化需求。为弥补这一不足,我们提出 WritingBench —— 一个全面的基准,用于在 6 个核心写作领域和 100 个子领域 上评估 LLM 的写作能力。此外,我们提出了一种 依赖查询的评估框架,使 LLM 能够动态生成实例特定的评估标准。该框架结合了一个经过微调的批评模型(critic model),能够进行基于标准的评分,从而在风格、格式和长度等方面实现更细粒度的评估。该框架的有效性还通过其数据整理能力得以验证:仅凭一个 7B参数的模型,就能够在写作任务中超越 GPT-4o 的表现。我们将基准数据集、评估工具以及模块化框架组件全部开源,以推动 LLM 在写作领域的发展。
⏩05、Communication-Efficient Diffusion Denoising
Parallelization via Reuse-then-Predict Mechanism
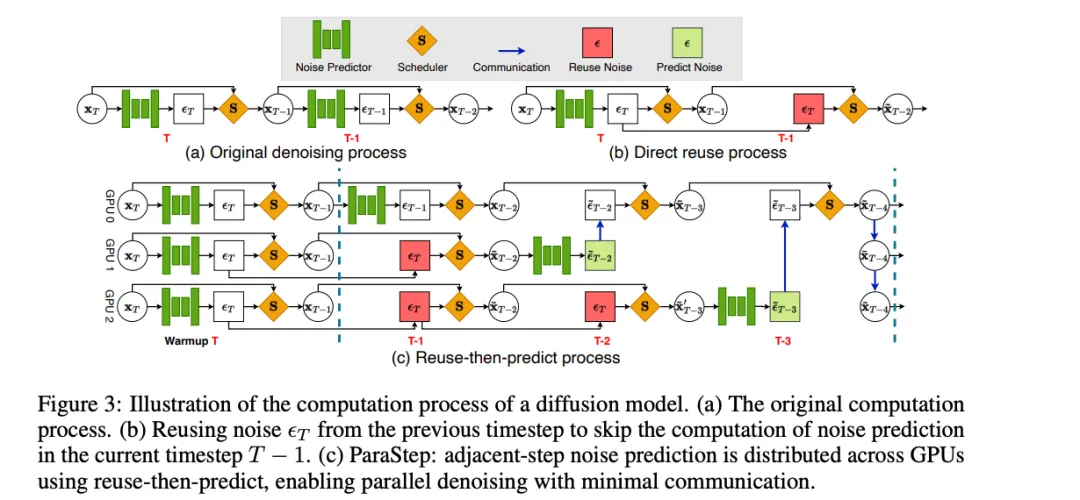
论文作者:王崑运,李波含,俞凯,过敏意,赵杰茹
论文简介:扩散模型已经在图像、视频和音频合成等多种模态中,发展成为一类功能强大的生成模型。然而,由于去噪过程本身具有高度顺序性,其推理通常受到显著的延迟限制。现有的并行化策略尝试通过在多个设备间分配计算来加速推理,但往往会带来较高的通信开销,从而阻碍其在商用硬件上的部署。为解决这一挑战,我们提出了ParaStep,一种基于“重用-预测”机制的新型并行化方法,该方法通过利用相邻去噪步骤之间的相似性,实现扩散推理的并行化。与以往依赖逐层或逐阶段通信的方式不同,ParaStep 采用轻量化、逐步的通信,大幅降低了开销。在 SVD 上实现了最高 3.88 倍的端到端加速,在 CogVideoX-2b 上实现了 2.43 倍,在 AudioLDM2-large 上实现了 6.56 倍,同时保持了生成质量。这些结果表明,ParaStep 是一种可扩展且通信高效的扩散推理加速方案,尤其适用于带宽受限的环境。
