
 语音小管家
来源丨开源星探、AIGC Studio
MultiTalk 是一款开源的音频驱动多人对话视频生成框架,由MeiGen-AI联合中山大学、美团和香港科技大学研发。MultiTalk在语音与嘴形同步方面达到了SOTA性能,并支持通过prompt实现人物、物体与场景的交互。
论文介绍
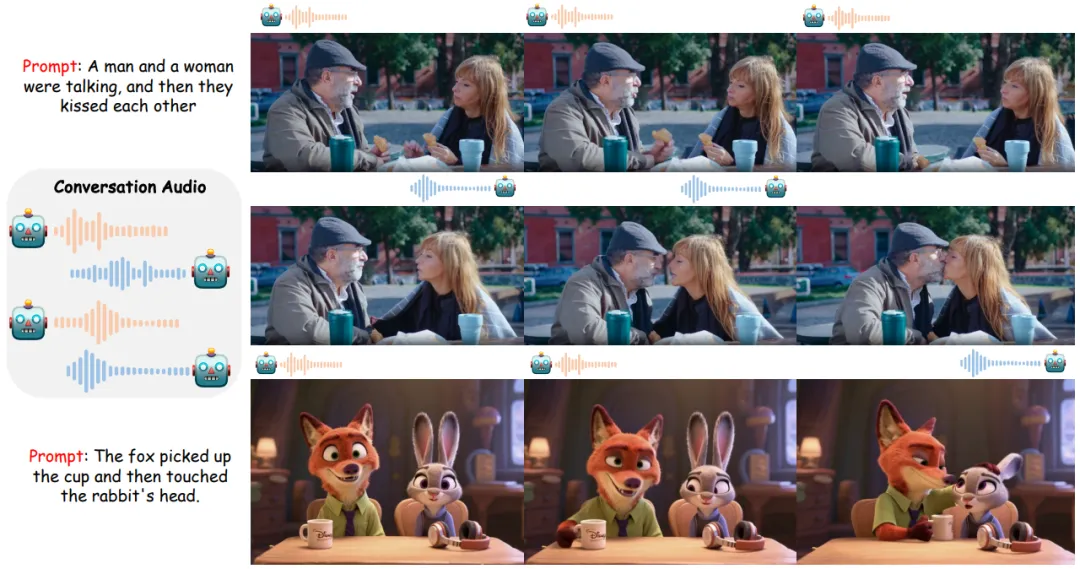
近年来,音频驱动的人体动画技术飞速发展,从逼真的说话头部(Talking Head)到全身动作同步(Talking Body),已能生成高自然度的单人物视频。然而,现有技术大多局限于单人场景,面对多人对话视频生成时面临三大挑战:
多音频流输入适配:如何区分并绑定不同人物的音频信号? 动态人物定位:当人物在画面中移动时,如何精准定位其运动区域? 指令遵循能力:如何让生成的视频严格遵循文本描述的复杂动作(如大幅肢体动作)?
方法概述
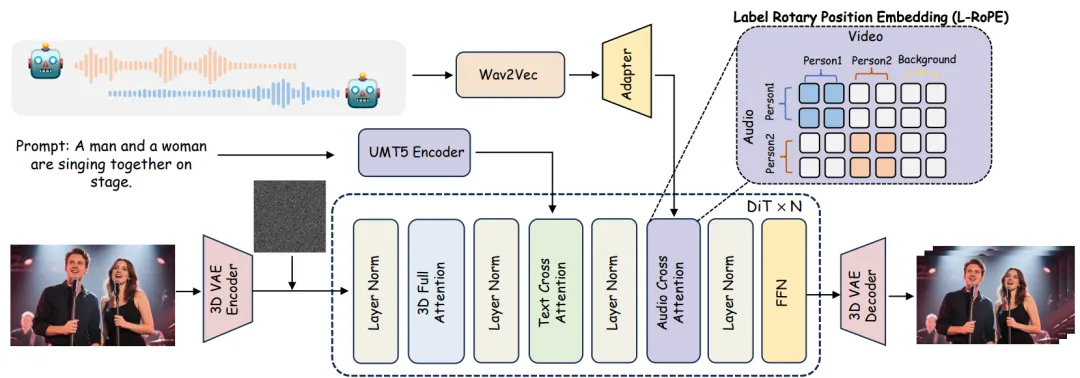
MultiTalk以DiT(Diffusion-in-Transformer)为基础的视频扩散模型作为其核心骨架。基础的图像到视频(I2V)扩散模型通常不原生支持音频输入。为了让模型能够“说话”,MultiTalk在每个DiT块的文本交叉注意力层之后,添加了新的层,这些层包含层归一化和音频交叉注意力机制,专门用于处理和整合音频条件。
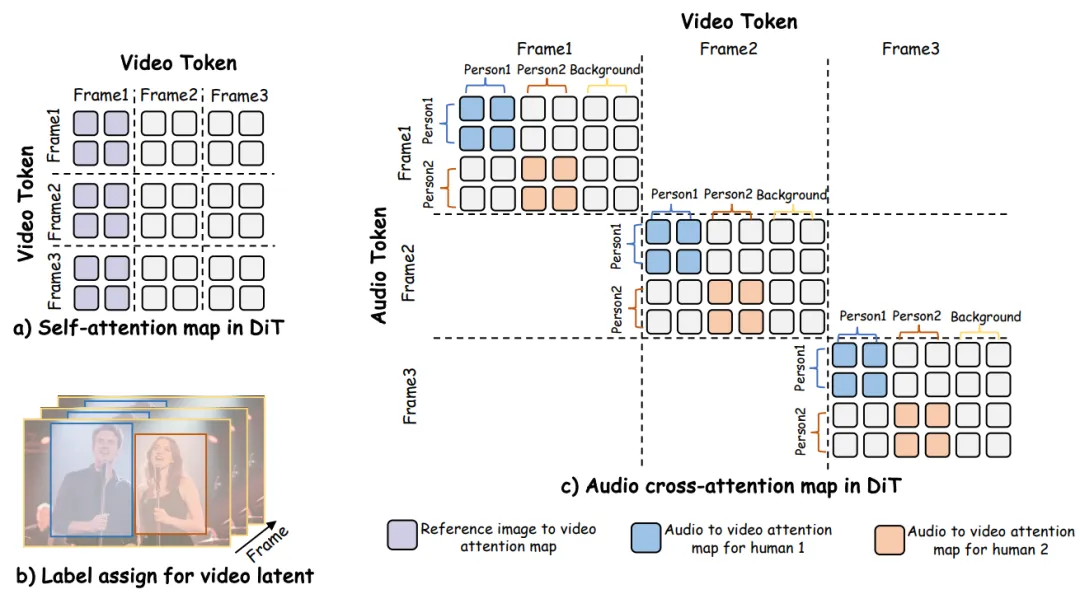
传统方法直接融合多音频流会导致人物与音频错配。MultiTalk提出Label Rotary Position Embedding(L-RoPE),通过以下步骤实现精准绑定:
步骤1:自适应人物定位利用参考图像的自注意力图(Self-Attention Map),计算人物区域与背景的相似度矩阵,动态分割视频潜在特征(Video Latents)为不同人物区域。
步骤2:标签分配与旋转编码为每个说话人分配独立的数值范围标签(如Person1:0-4,Person2:20-24),并通过旋转位置编码(RoPE)将标签映射到音频交叉注意力层。相同标签的音频与视频区域会被激活,从而绑定音频与人物的唇部动作。
实验结果
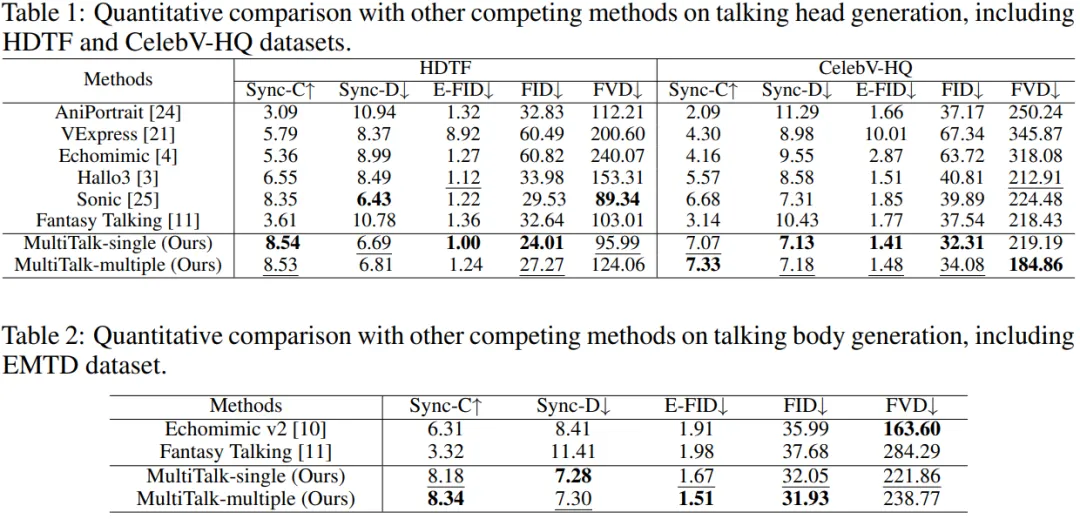
快速入手
1、设置 Python 环境
# 创建并激活 conda 环境
conda create -n multitalk python=3.10
conda activate multitalk

# 安装带 CUDA 支持的 PyTorch
pip install torch==2.4.1 torchvision==0.19.1 torchaudio==2.4.1 --index-url https://download.pytorch.org/whl/cu121
pip install -U xformers==0.0.28 --index-url https://download.pytorch.org/whl/cu121
2、安装 Flash Attention
pip install misaki[en]
pip install ninja
pip install psutil
pip install packaging
pip install flash_attn==2.7.4.post1
3、安装其他依赖项
# 从 requirements.txt 安装 Python 包
pip install -r requirements.txt

# 安装音频处理库 librosa
conda install -c conda-forge librosa

# 安装 FFmpeg(选择一种方法)
conda install -c conda-forge ffmpeg
# 或者
sudo yum install ffmpeg ffmpeg-devel  # 对于基于 yum 的系统
4、FFmpeg 安装
conda install -c conda-forge ffmpeg 5、下载模型权重
# 下载所需模型权重
huggingface-cli download Wan-AI/Wan2.1-I2V-14B-480P --local-dir ./weights/Wan2.1-I2V-14B-480P
huggingface-cli download TencentGameMate/chinese-wav2vec2-base --local-dir ./weights/chinese-wav2vec2-base
huggingface-cli download TencentGameMate/chinese-wav2vec2-base model.safetensors --revision refs/pr/1 --local-dir ./weights/chinese-wav2vec2-base
huggingface-cli download hexgrad/Kokoro-82M --local-dir ./weights/Kokoro-82M
huggingface-cli download MeiGen-AI/MeiGen-MultiTalk --local-dir ./weights/MeiGen-MultiTalk
6、链接或复制 MultiTalk 模型文件
# 首先备份原始索引文件
mv weights/Wan2.1-I2V-14B-480P/diffusion_pytorch_model.safetensors.index.json weights/Wan2.1-I2V-14B-480P/diffusion_pytorch_model.safetensors.index.json_old

# 选项 1:创建符号链接
sudoln -s {绝对路径}/weights/MeiGen-MultiTalk/diffusion_pytorch_model.safetensors.index.json weights/Wan2.1-I2V-14B-480P/
sudoln -s {绝对路径}/weights/MeiGen-MultiTalk/multitalk.safetensors weights/Wan2.1-I2V-14B-480P/

# 或者选项 2:直接复制文件
# cp weights/MeiGen-MultiTalk/diffusion_pytorch_model.safetensors.index.json weights/Wan2.1-I2V-14B-480P/
# cp weights/MeiGen-MultiTalk/multitalk.safetensors weights/Wan2.1-I2V-14B-480P/
这是一个基本示例,可以验证项目是否部署OK,系统会生成一个视频文件,显示人物与提供的音频同步说话。
python generate_multitalk.py \
    --ckpt_dir weights/Wan2.1-I2V-14B-480P \
    --wav2vec_dir 'weights/chinese-wav2vec2-base' \
    --input_json examples/single_example_1.json \
    --sample_steps 40 \
    --mode streaming \
    --use_teacache \
    --save_file single_long_exp
示例 1:单人视频生成
使用本地音频文件
创建一个 JSON 配置文件 single_example.json:
{
  "prompt": "一位女士在录音室里充满激情地对着专业麦克风唱歌。她戴着大耳机,穿着深色开襟毛衣,内搭灰色上衣。",
  "cond_image": "examples/single/single1.png",
  "cond_audio": {
    "person1": "examples/single/1.wav"
  }
}
运行生成命令:
python generate_multitalk.py \
  --task multitalk-14B \
  --size multitalk-480 \
  --ckpt_dir ./weights/Wan2.1-I2V-14B-480P \
  --wav2vec_dir ./weights/chinese-wav2vec2-base \
  --input_json single_example.json \
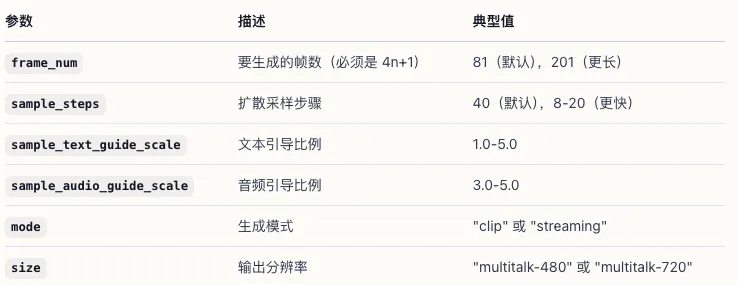
  --frame_num 81 \
  --sample_steps 40 \
  --sample_text_guide_scale 5.0 \
  --sample_audio_guide_scale 4.0 \
  --mode clip
这将生成一个 81 帧的视频(约 3 秒,25 FPS),视频中的人物说话时嘴唇动作与提供的音频文件同步。
使用文本到语音(TTS)
对于基于 TTS 的生成,您的 JSON 应包括要说的文本:
{
  "prompt": "一位女士在录音室里充满激情地对着专业麦克风唱歌。她戴着大耳机,穿着深色开襟毛衣,内搭灰色上衣。",
  "cond_image": "examples/single/single1.png",
  "cond_audio": {},
  "tts_audio": {
    "text": "欢迎来到 multi-talk,这是一个音频驱动的视频生成模型。",
    "human1_voice": "weights/Kokoro-82M/voices/af_heart.pt"
  }
}
使用 TTS 选项运行:
python generate_multitalk.py \
  --task multitalk-14B \
  --size multitalk-480 \
  --ckpt_dir ./weights/Wan2.1-I2V-14B-480P \
  --wav2vec_dir ./weights/chinese-wav2vec2-base \
  --input_json single_example_tts.json \
  --audio_mode tts \
  --frame_num 81 \
  --sample_steps 40
示例 2:多人视频生成
MultiTalk 擅长生成多人对话视频。在多人场景中有两种处理音频的模式:
• add 模式:说话者轮流(顺序音频)• parallel 模式:说话者可以同时说话
使用本地音频文件(Add 模式)
在 add 模式下,每个说话者的音频片段按顺序组合:
{
  "prompt": "在一个休闲环境中,一男一女在车内进行对话。男士穿着牛仔夹克,女士穿着黑色上衣,肩上搭着牛仔夹克。",
  "cond_image": "examples/multi/1/multi1.png",
  "audio_type": "add",
  "cond_audio": {
    "person1": "examples/multi/1/1.WAV",
    "person2": "examples/multi/1/2.WAV"
  }
}
运行生成命令:
python generate_multitalk.py \
  --task multitalk-14B \
  --size multitalk-480 \
  --ckpt_dir ./weights/Wan2.1-I2V-14B-480P \
  --wav2vec_dir ./weights/chinese-wav2vec2-base \
  --input_json multitalk_example_add.json \
  --frame_num 81 \
  --sample_steps 40
使用本地音频文件(Parallel 模式)
在 parallel 模式下,两位说话者的音频同时播放:
{
  "prompt": "在一个温馨的录音室里,一男一女正在一起唱歌。男士站在左侧,女士站在右侧,两人共用一个麦克风。",
  "cond_image": "examples/multi/3/multi3.png",
  "audio_type": "para",
  "cond_audio": {
    "person1": "examples/multi/3/1-man.WAV",
    "person2": "examples/multi/3/1-woman.WAV"
  }
}
命令类似,只需更改输入 JSON:
python generate_multitalk.py \
  --task multitalk-14B \
  --size multitalk-480 \
  --ckpt_dir ./weights/Wan2.1-I2V-14B-480P \
  --wav2vec_dir ./weights/chinese-wav2vec2-base \
  --input_json multitalk_example_para.json \
  --frame_num 81 \
  --sample_steps 40
高级使用选项-长视频生成
对于超过默认 81 帧的长视频,使用流式模式:
python generate_multitalk.py \
  --task multitalk-14B \
  --size multitalk-480 \
  --ckpt_dir ./weights/Wan2.1-I2V-14B-480P \
  --wav2vec_dir ./weights/chinese-wav2vec2-base \
  --input_json multitalk_example_1.json \
  --mode streaming \
  --motion_frame 25 \
  --sample_steps 40
在流式模式下,MultiTalk 分块生成视频并将其拼接在一起。
更多使用方法可以参考项目Readme文档,主要更改相关配置与参数即可。
结 论
MultiTalk提出一种音频驱动多人物对话视频生成方案,其核心突破在于其创新的L-ROPE方法,它通过结合自适应人物定位和带有类别信息的标签编码,有效解决了多流音频的注入和人物绑定这一难题。此外,其精心设计的部分参数训练和多任务训练策略,确保了模型在有限资源下依然能够保持强大的指令遵循能力和高质量的视觉输出。MultiTalk首次将语音驱动的动画从单人推向多人场景,为虚拟主播、影视制作等领域提供了强有力工具。
