
 语音小管家
实时语音转文字(ASR)和说话人识别(Diarization)在多人会议、字幕生成和无障碍辅助中需求日益增长,但传统工具常需云端处理,存在隐私风险和延迟问题。
最近 GitHub 上出现了一款开源项目WhisperLiveKit,提供了完全本地化的实时语音识别解决方案,不仅速度快、延迟低,还支持说话人识别,非常适合会议实时字幕和语音转录场景。
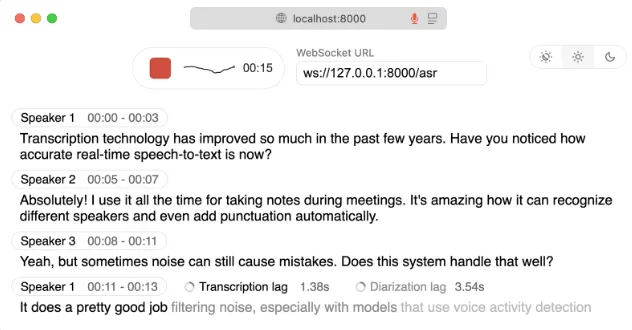
本质上是一个全面的实时语音转录工具包,结合了多项前沿技术,提供即时、准确的转录结果。
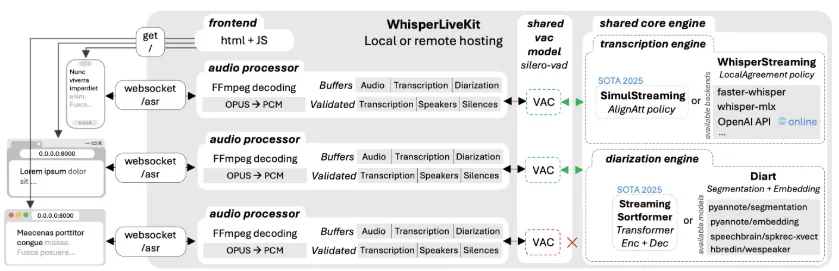
GitHub:https://github.com/QuentinFuxa/WhisperLiveKit
主要功能
•完全本地化处理:无需上传语音数据,隐私安全有保障 •实时语音转文字:支持多种语言和模型大小,转录精准 •智能说话人识别:自动区分不同发言者身份,适合多人会议 •先进流式处理算法:延迟极低,保证实时体验 •多种使用方式:支持 Web 界面和 Python API,开发者与普通用户都能轻松上手
同时项目提供 Docker 快速部署,并支持 GPU 加速运行,开箱即用。
快速入手
前置条件:
系统已安装 Python 3.9 或更高版本 已安装 FFmpeg(音频处理必需) 连接了麦克风(用于测试) 约 1GB 的可用磁盘空间(用于模型下载)
只需要使用Python的 pip 包管理命令即可一键安装 WhisperLiveKit 使用。
pip install whisperlivekit 这将安装核心包及其基本依赖项,包括 FastAPI、faster-whisper 和 websockets。
音频处理需要安装 FFmpeg。可根据操作系统进行安装:
Ubuntu/Debian:
sudo apt update && sudo apt install ffmpeg MacOS:
brew install ffmpeg Windows:
从https://ffmpeg.org/download.html下载 FFmpeg,然后解压文件并将 bin 目录添加到系统 PATH 中。
最后可验证该工具是否安装成功:
whisperlivekit-server --help 启动转录服务器(下载基础模型):
whisperlivekit-server --model base --language en 服务器运行后,打开网页浏览器并访问http://localhost:8000。
还有相关更高级的用法可查看项目文档使用。
总 结
WhisperLiveKit是一款强大的实时语音转文本解决方案,可直接在浏览器中提供即时转录功能。
它基于最先进的语音识别技术,支持完全本地化或内部部署,提供转录和说话人分离功能,确保隐私保护和低延迟。
如果你正在寻找一款无需依赖云端的实时语音识别工具,并且需要在会议、协作或应用中区分不同发言人,那么 WhisperLiveKit 会是一个非常值得尝试的开源项目。
