
 语音小管家
在计算机视觉领域,标注数据一直是“刚需”。但人工标注不仅费时费力,还存在主观偏差,尤其在医学影像、卫星图像等专业领域,更是难以规模化获取高质量标注数据。
为了解决这个痛点,Meta AI 近日正式开源了全新一代通用图像识别模型:DINOv3。
GitHub:https://github.com/facebookresearch/dinov3
HF 模型地址:https://huggingface.co/collections/facebook/dinov3-68924841bd6b561778e31009
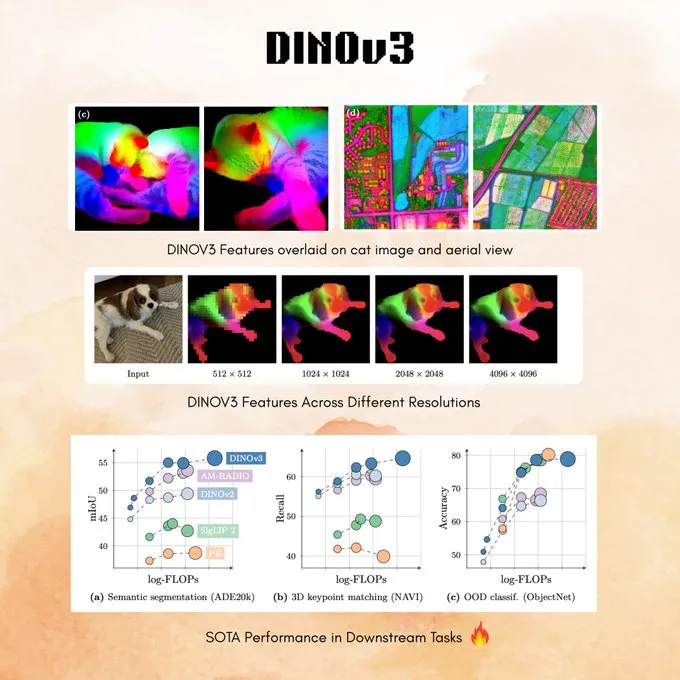
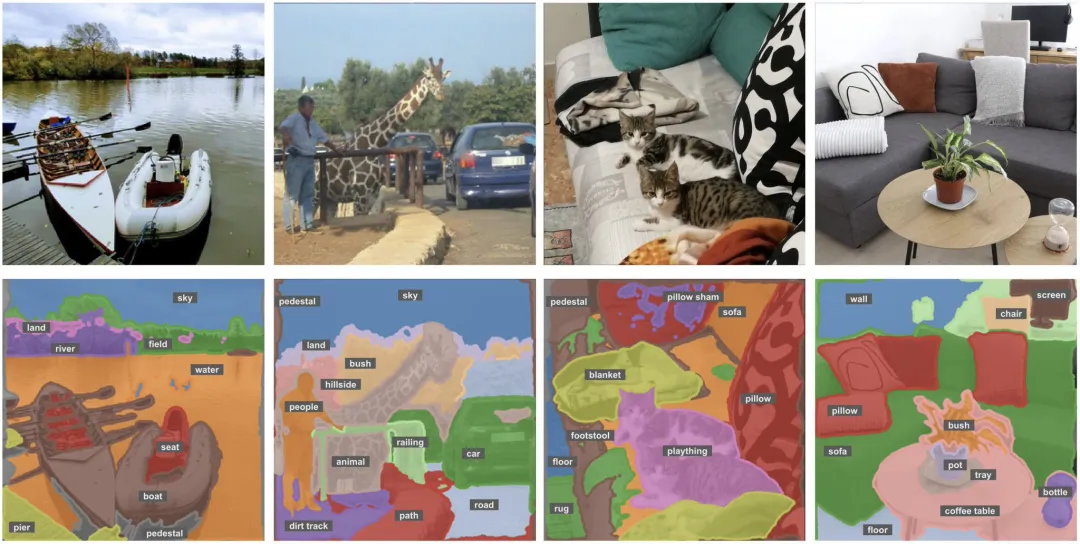
DINOv3 延续了 DINO 系列的自监督学习思路,能够在无需人工标注的情况下,自主学习图像特征,生成高质量、高分辨率的图像表示,在多项视觉任务中性能媲美甚至超越 Google 的 SigLIP 2、OpenAI 的 Perception Encoder 等对手。
这意味着,未来图像 AI 的训练门槛将被进一步拉低,从商业到科研,任何人都可以在无标注数据的前提下,训练出高性能的视觉模型。
核心亮点
DINOv3 的核心引入了几项关键创新,使其区别于以往的视觉模型:
1、多功能架构
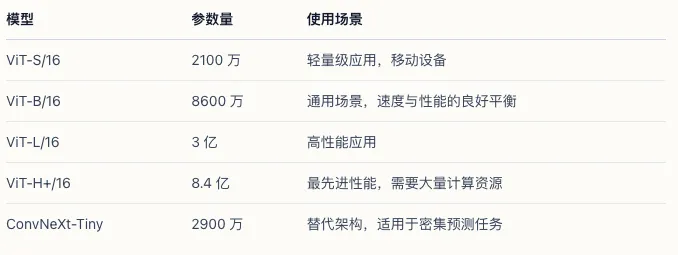
DINOv3 有两个主要的架构系列——Vision Transformers (ViT) 和 ConvNeXt 模型,参数数量从 2100 万到庞大的 70 亿不等。
这种多样性使用户能够根据其特定的计算约束和性能要求选择最佳模型。
2、多数据集训练
这些模型在两个不同的数据集上进行训练:
• LVD-1689M:从 170 亿张网络图像中精心筛选出的 16.89 亿张图像数据集• SAT-493M:包含 4.93 亿张 0.6 米分辨率卫星图像的专业数据集
这种双数据集方法使 DINOv3 在通用计算机视觉任务和专业地理空间应用中都表现出极高的多功能性。
3、先进的训练技术
DINOv3 采用了一套复杂的训练流程,结合了多个目标:
• 带多裁剪的 DINO 自蒸馏损失 • iBOT 掩码图像建模损失 • [CLS] 标记上的 KoLeo 正则化 • 用于提高特征质量的 Gram 锚定
这些技术共同作用,产生鲁棒且可泛化的特征,能够捕捉图像的语义和几何属性。
性能能力
DINOv3 在全局和密集视觉任务中都表现出卓越的性能:
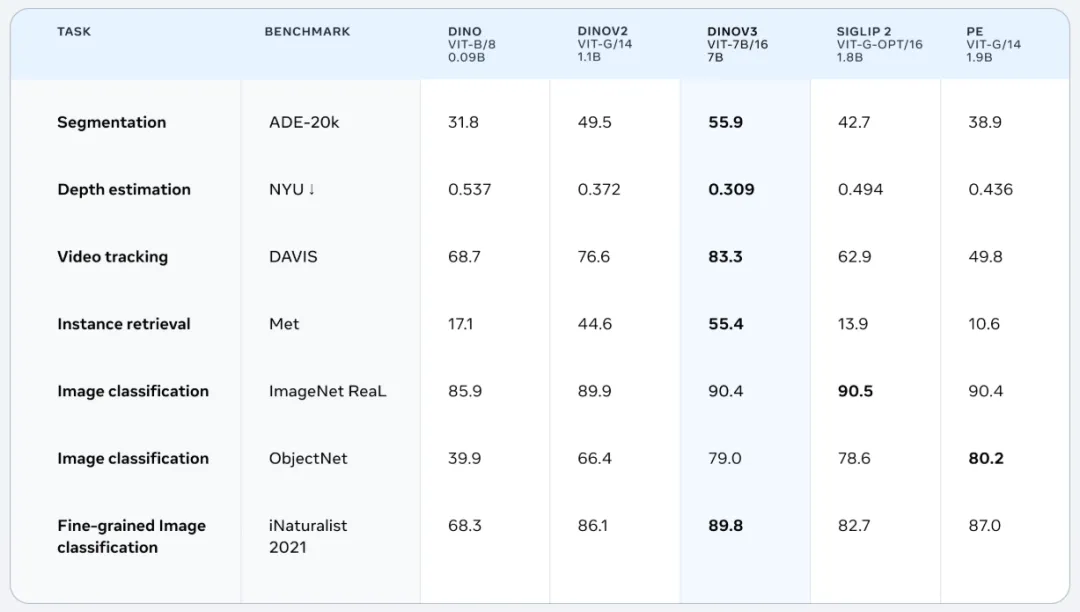
DINOv3 在视觉基础模型中树立了新的标准。首次,一个使用SSL训练的模型在广泛的探测任务中超越了弱监督模型,从细粒度图像分类到语义分割,再到视频中的目标跟踪。
快速入门
① 安装依赖项
首先安装所需的软件包。核心依赖项极少,专注于深度学习和科学计算:
pip install torch torchvision torchmetrics scikit-learn omegaconf ② 克隆并安装 DINOv3
git clone https://github.com/facebookresearch/dinov3.git
cd dinov3
pip install -e .
这将以开发模式安装 DINOv3,使我们能够访问所有模型和工具。软件包结构包含模型、数据加载、评估和训练的核心模块。
DINOv3 设计非常易于访问和使用。提供了多种加载模型的方式。
首先,最简单的入门方式是通过 PyTorch Hub 加载预训练模型:
import torch

# 加载 DINOv3 ViT-Base 模型(8600 万参数)
model = torch.hub.load(
    'facebookresearch/dinov3',
    'dinov3_vitb16',
    pretrained=True
)

# 如果可用则移至 GPU
device = torch.device('cuda'if torch.cuda.is_available() else'cpu')
model = model.to(device)
model.eval()  # 设置为评估模式
其次,该框架还提供了与 Hugging Face Transformers 的集成,使将 DINOv3 集成到现有 ML 流程中更加容易。
from transformers import pipeline
from transformers.image_utils import load_image

# 加载特征提取流水线
feature_extractor = pipeline(
    model="facebook/dinov3-vitb16-pretrain-lvd1689m",
    task="image-feature-extraction"
)
接下来让我们使用加载的模型从图像中提取特征。这是 DINOv3 的核心功能——将图像转换为丰富、有意义的特征表示。
import torch
import torchvision.transforms as T
from PIL import Image
import requests

# 加载并预处理图像
url = "https://images.unsplash.com/photo-1543857778-c4a1a569e7bd"
image = Image.open(requests.get(url, stream=True).raw)

# 定义预处理变换
transform = T.Compose([
    T.Resize(256),
    T.CenterCrop(224),
    T.ToTensor(),
    T.Normalize(mean=[0.485, 0.456, 0.406], std=[0.229, 0.224, 0.225]),
])

# 预处理图像
input_tensor = transform(image).unsqueeze(0).to(device)

# 提取特征
with torch.no_grad():
    features = model(input_tensor)

print(f"特征形状: {features.shape}")  # 应为 [1, N, D],其中 D 是特征维度
DINOv3 输出补丁级特征,其中:
• 第一维是批次大小(本例中为 1) • 第二维是补丁数量(224×224 图像使用 16×16 补丁时为 196) • 第三维是特征维度(ViT-Base 为 768)
这些特征捕获了每个图像补丁的丰富语义信息,可用于分类、分割、目标检测等各种下游任务。
DINOv3 提供一系列模型以满足不同需求:
写在最后
DINOv3以其自监督学习、高质量特征和多任务支持,为你提供了一个从普通照片到卫星、医学图像的通用视觉解决方案。
同时在AI和计算机视觉领域引起了广泛关注。作为Meta在视觉自监督学习方面的最新突破,该模型不仅激发了业界对其能力的兴奋讨论,也引发了关于实际应用的技术探讨。
无论是环境监测、自动驾驶还是医疗诊断,DINOv3都能在这些领域上提供极大助力。
