
 语音小管家
近日,2025年IEEE AASP举办的DCASE挑战赛(Challenge on Detection and Classification of Acoustic Scenes and Events)落幕。作为目前声音事件领域最权威的竞赛,DCASE自2013年组织发起已举办了11届,历届赛事均吸引了全球范围内高校和企业的顶尖声学团队参与。
在2025年DCASE挑战赛中,赛事方首次结合大模型技术趋势,创新性地设置了Audio QuestionAnswering(AQA,音频问答理解)赛道(赛道5)。本文将详细介绍蚂蚁集团在该赛道的夺冠方案。
DCASE2025-audio-question-answering-results
赛事地址:https://dcase.community/challenge2025/task-audio-question-answering-results
1、AQA赛道介绍
音频理解问答任务致力于在交互式音频理解领域推进问答能力,不同于只有音频输入的音频标注,音频定位,音频描述等任务,音频理解问答要求模型能够处理各种不同类型的音频和其对应的问题。
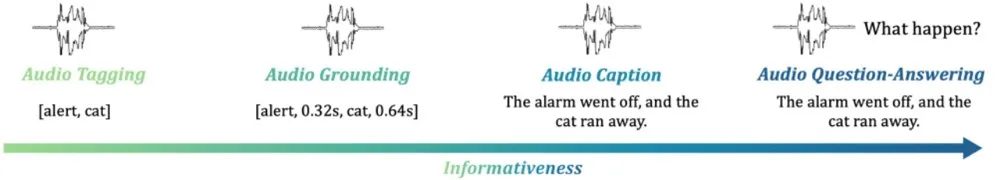
图1:AQA任务介绍
1.1 AQA技术难点
比赛设计的AQA任务挑战的难点包括:
极端多样的音频条件(从600Hz到160kHz的采样率,从不到1秒到超过10分钟的音频长度)
需要专业领域知识(如海洋生物学)的问题
毫秒级精度的时间戳判断
复杂的多事件重叠和时序关系推理
抽象概念和隐含信息的理解
1.2 AQA题目类别
AQA任务包含三个难度递增的子数据集,每一个都针对不同维度的音频理解能力:
生物声学问答:涵盖31种海洋哺乳动物的声音,采样率从600Hz到160kHz不等,音频长度从0.4秒到625秒不等。
时序声景问答:包含26个声音类别,重点测试模型对声音时序关系的理解。系统需要确定声音的活跃状态、类别、时序关系(如发生顺序),甚至精确到毫秒级的时间戳(包括起始、结束时间和持续时间)。
复杂问答(MMAU):基于真实场景音频,提出需要多层次推理涉及识别重叠的声音事件、解释听觉现象序列,或辨别声景暗示的抽象关系的问题,代表了当前音频理解的最高难度水平。
2、蚂蚁技术方案
针对本次比赛的特殊挑战,该团队从数据构建、模型架构和训练范式三个核心方向进行了系统性优化,如图2所示:
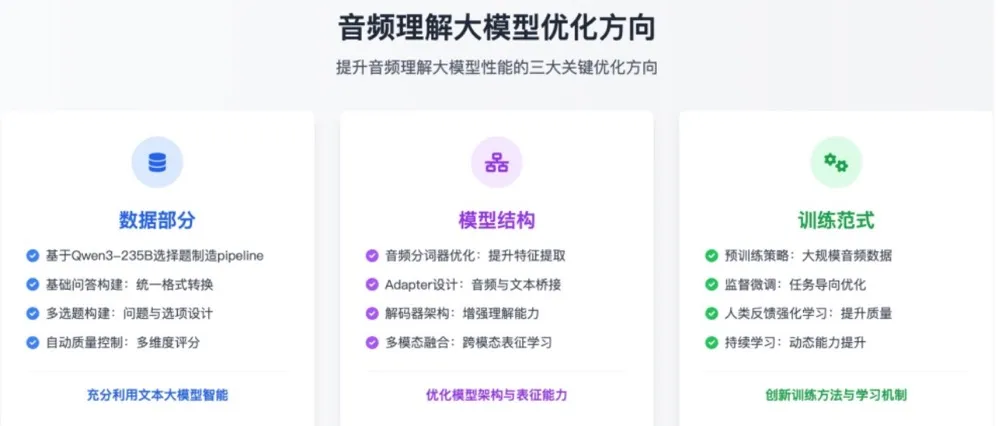
图2:三大优化方向
2.1 数据部分
该团队充分利用文本大模型来构建有竞争力的选择题训练集,在经过多轮实验中确认了基于Qwen3-235B设计的全自动数据处理流水线方案。这里包含三个关键步骤:基础问答构建,多选题构建,自动质量控制。具体流程如图3所示:
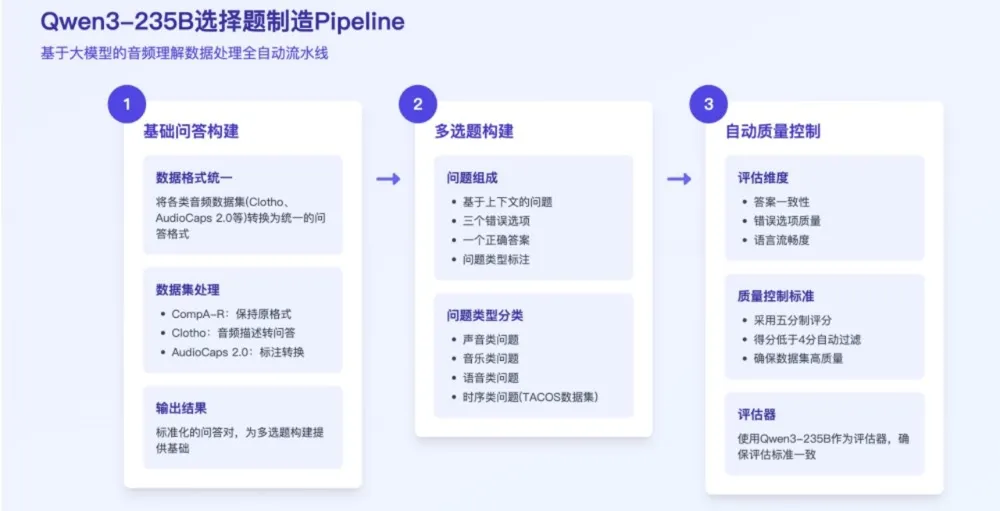
图3:选择题制造pipeline
基础问答构建:将各类音频任务数据集转换为统一的问答题。
多选题构建:利用大模型的能力转换成选择题。
自动质量控制:该团队同时使用另一个大模型做为评估器,从三个维度进行评分:答案一致性,错误选项质量,语言流畅度来对上一个阶段制造的多选题打分,并滤除分数较低的题目。
相关的流程如图4:
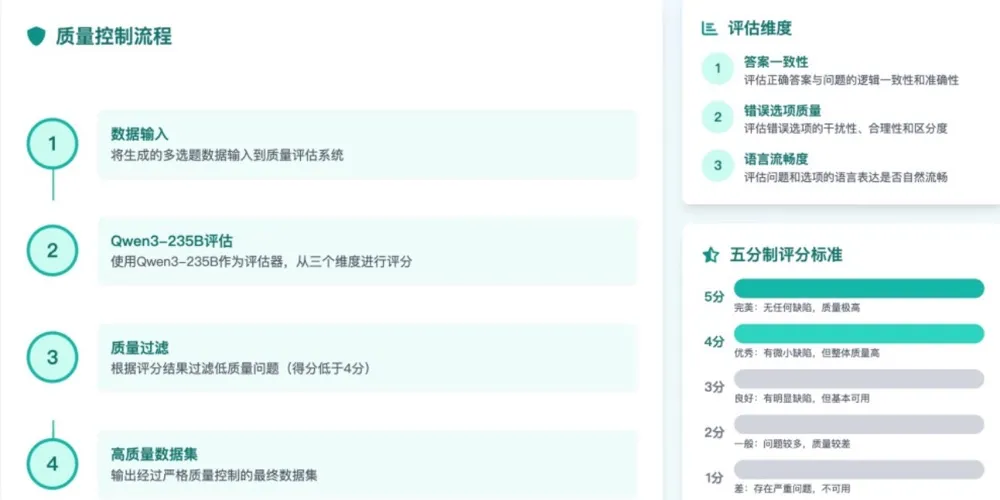
图4:自动质量控制
考虑到时序相关任务的高难度,该团队针对性地构建了模版,再根据问题模版来生成相关的选择题,如图5所示:
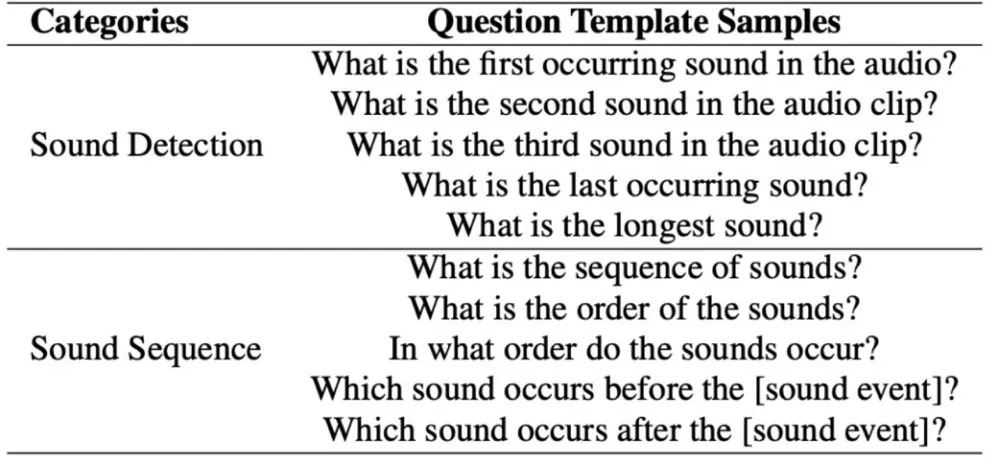
图5:时序数据集问题模版
该团队制造的数据集称为DCASE-AQA-Boost训练集。
2.2 模型结构部分
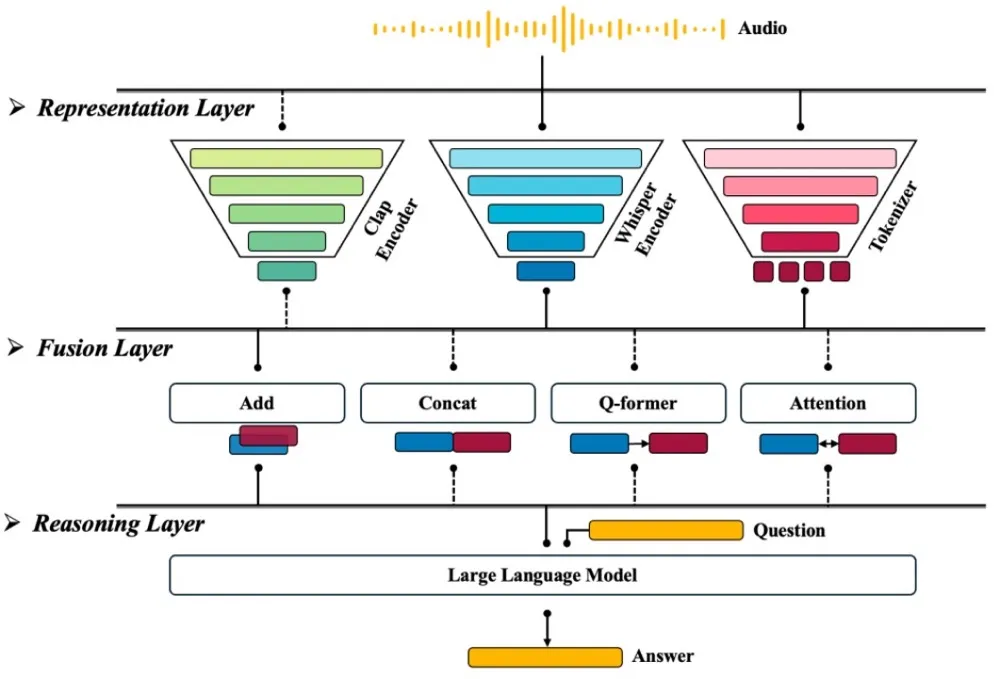
图6: 音频理解大模型的层级结构
该团队把整个音频理解大模型分成三个层:表征层(压缩声音信号)、融合层(整合音频信息)、推理层(基于问答推理)。对于表征层,分别尝试了Whisper/Clap编码器、离散Tokenizer及混合方案,对于融合层,尝试了相加、拼接、Q-former和注意力机制四种方法。
由于时间限制,采用Kimi-Audio-7B和Qwen2-Audio-7B-Instruct作为基座模型,用构造数据进行训练。Kimi-Audio的设计通过直接相加融合离散和连续特征,扩展了语义声学表征边界。对于Qwen2-Audio,也尝试了多编码器融合来拓展其能力边界,后续将探索更优的融合方法并公布结果。
2.3 训练范式
基于上述的两个基座模型,开发出了Qwen2-Audio-R1-8B和Kimi-Audio-SFT-12B这两个版本的模型。
Qwen2-Audio-R1-8B
引入了三阶段训练范式来优化模型。
微调(SFT):使用广泛的音频问答数据集进行训练,以实现跨多样化音频问答任务的统一学习。使用DCASE-AQA-Boost数据集的预训练部分进行监督微调。
强化学习(GRPO):使用DCASE任务5提供的训练集,以提升其在任务的三个组成部分中的表现。
强化学习(GRPO):使用精心策划的DCASE-AQA-Boost数据集的微调部分,并采用GRPO作为训练策略,来强化其在表现不佳任务上的性能。
Kimi-Audio-SFT-12B
采用了简化的两阶段微调。首先使用预训练数据集进行SFT,建立跨数据集中各种音频领域的基础音频-语言理解能力。随后,使用数据集的微调部分进行额外的SFT。
通过上述方法微调后的模型在DCASE开发集上进行评估。表1展示了两种模型在不同训练阶段的性能进展,表2展示了最终模型在DCASE开发集不同任务类别上的性能。
表1:DCASE开发集不同阶段的性能
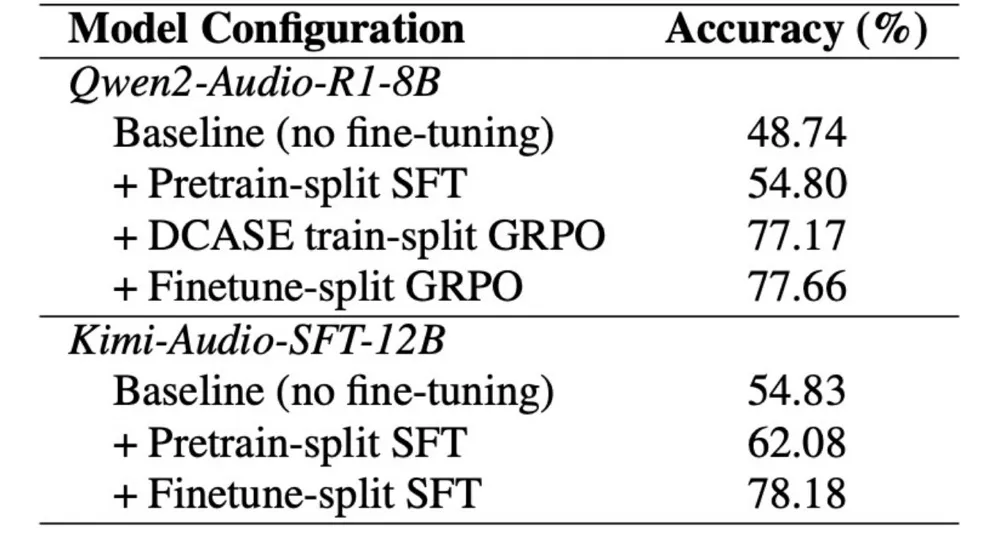
表2:模型在不同领域的算法性能
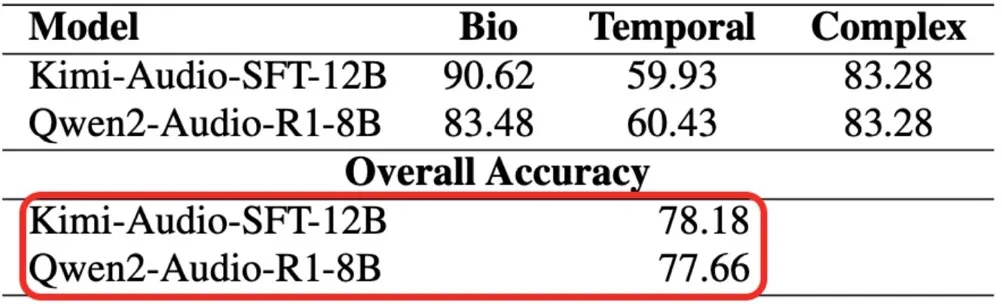
结果表明,通过团队的方法,两种模型都获得了显著的性能提升:
对于Qwen2-Audio-Instruct,基线准确率从48.74%提高到完整三阶段训练范式后的77.66%。最显著的提升发生在使用DCASE训练集的GRPO阶段,突显了强化学习的有效性。
Kimi-Audio在两阶段SFT训练后从基线的54.83%开始达到78.18%的准确率。尽管没有使用GRPO,Kimi-Audio仍然实现了略高的最终性能(78.18%对比77.66%),表明了模型架构与数据集构建方法之间的兼容性。
表2中的详细介绍了不同类别的算法性能:
两种模型在生物声学理解方面表现出色,Kimi-Audio-SFT-12B达到90.62%的准确率,Qwen2-Audio-R1-8B达到83.48%。
在复杂音频场景方面,两种模型表现同样强劲,在1633个复杂音频题目上达到相同的83.28%准确率。
时序推理仍然是最具挑战性的任务类别,两种模型能力相对适中。
结果表明,使用DCASE-AQA-Boost进行的初始SFT阶段提供了稳定的改进,为后续训练阶段奠定了基础。
