
 语音小管家
随着ChatGPT、Claude等文本大模型的爆火,人们开始期待更自然的语音交互方式。然而,当前的语音大模型在知识理解方面表现如何?它们能否像人类一样通过纯语音进行复杂的知识问答?
来自香港中文大学的研究团队在ACL 2025主会上发表了一项突破性研究,首次提出了专门评估端到端语音大模型知识理解能力的基准——VoxEval。这项工作揭示了当前语音大模型在知识理解方面的严重不足,为未来的研究指明了方向。
论文链接:https://arxiv.org/abs/2501.04962
Github:
本文第一作者:崔文谦,香港中文大学博士生,致力于语音大模型,多模态大模型,AI音乐生成等方向的研究。
现有评估方法的三大局限
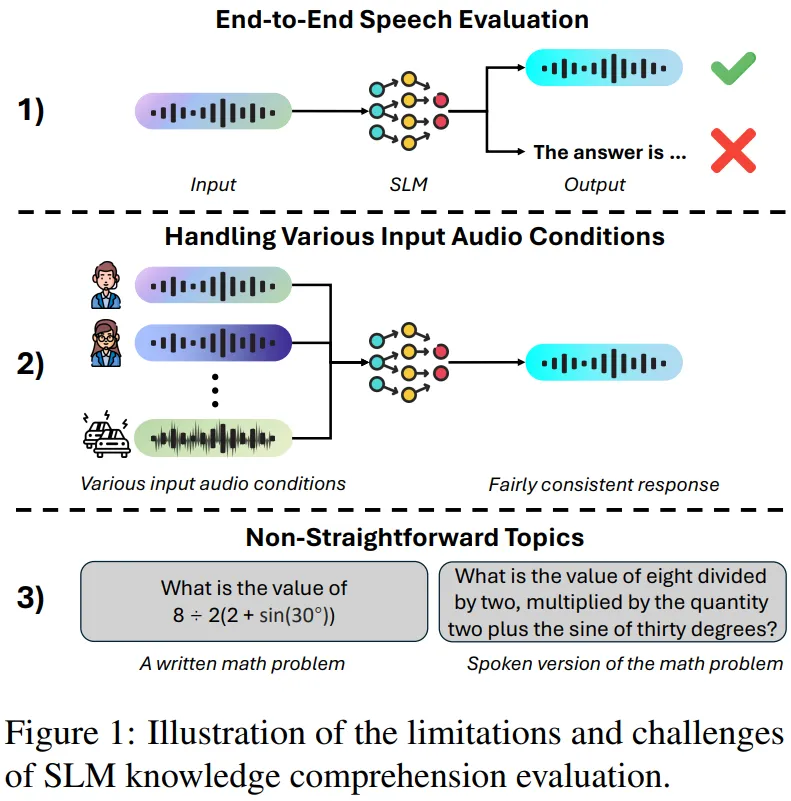
目前的语音大模型评估存在致命缺陷。研究团队发现,现有基准要么只支持"语音输入-文本输出"的评估模式,要么无法处理真实世界中多样化的音频条件,更无法评估数学推理等复杂任务的语音表达能力。
想象一下,当你在满是噪音的环境下对语音助手说"8除以2乘以括号2加sin30度括号"时,它能正确理解并回答吗?这正是VoxEval要解决的核心问题。
VoxEval:革命性的语音知识理解基准
VoxEval基准包含13,938个语音问答对,覆盖56个知识领域,是首个支持完全端到端语音评估的知识理解基准。
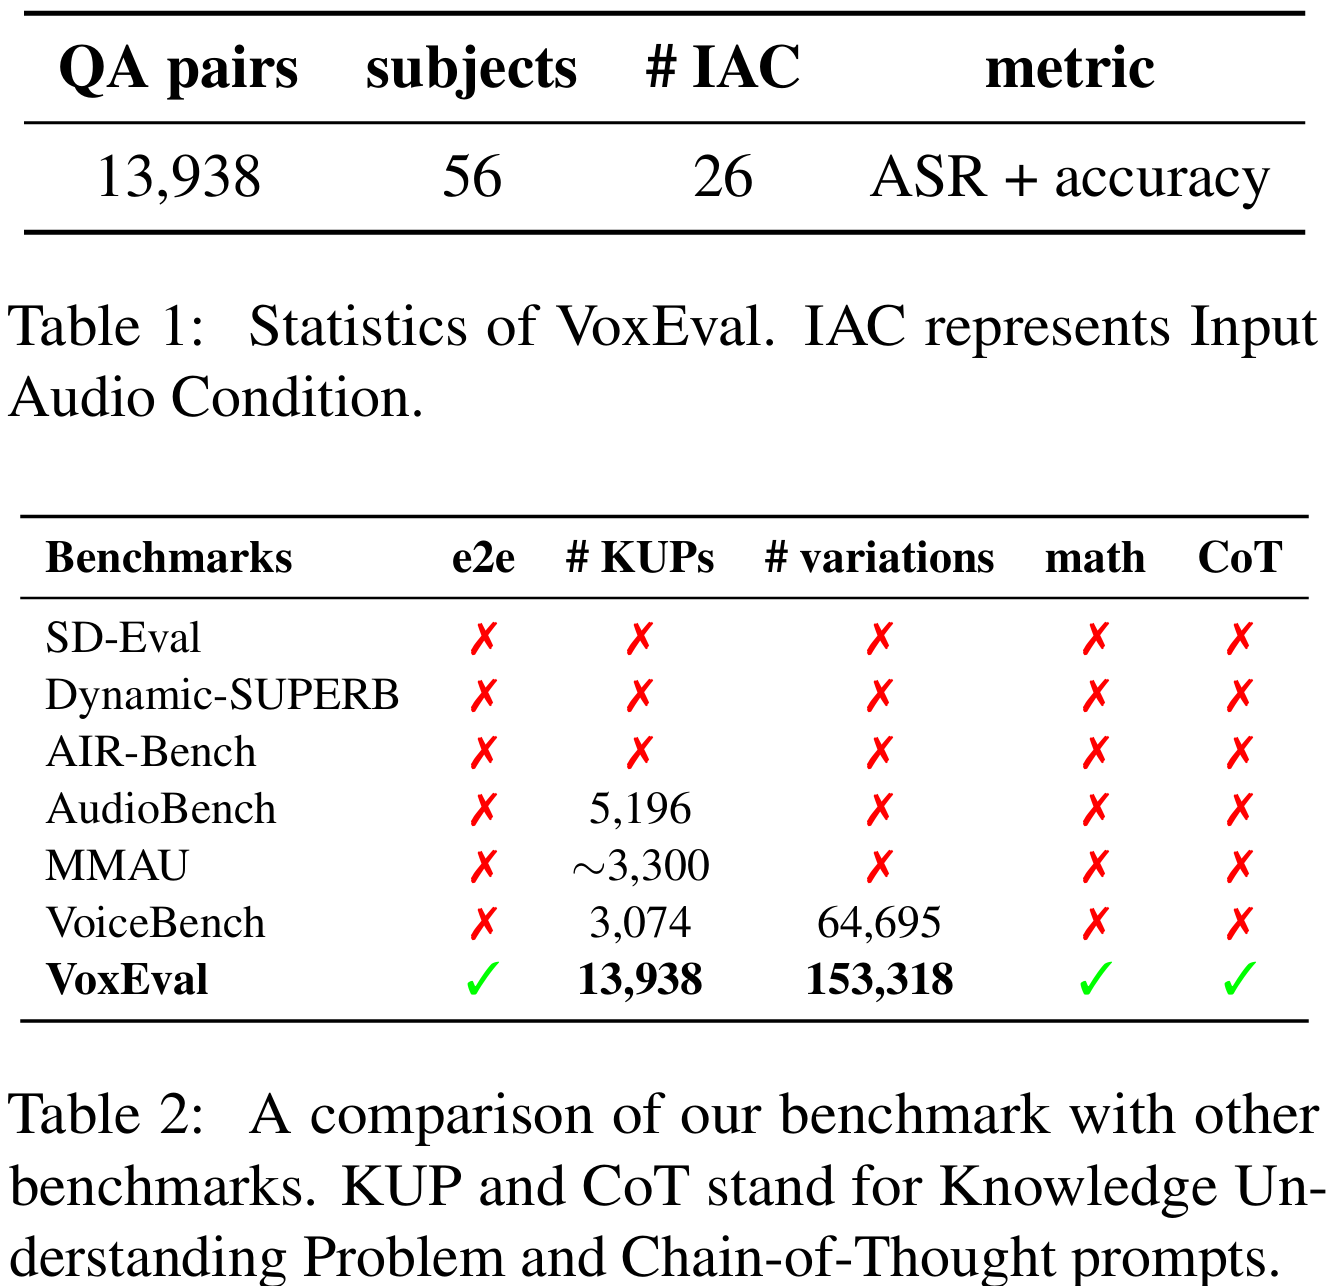
该基准的三大创新特点让它脱颖而出:
完全端到端的语音评估。与以往基准不同,VoxEval的问题和答案都是纯语音格式,真正模拟了人类的语音交互场景。这种设计更贴近实际应用,因为研究表明,从"语音到文本"的交互模式切换到"语音到语音"的交互模式时,模型性能会显著下降。
多样化的音频条件测试。现实世界中,用户的语音条件千差万别——不同的说话人、语音风格、背景噪音等都会影响模型表现。VoxEval通过26种不同的音频条件变化,全面测试模型的鲁棒性。
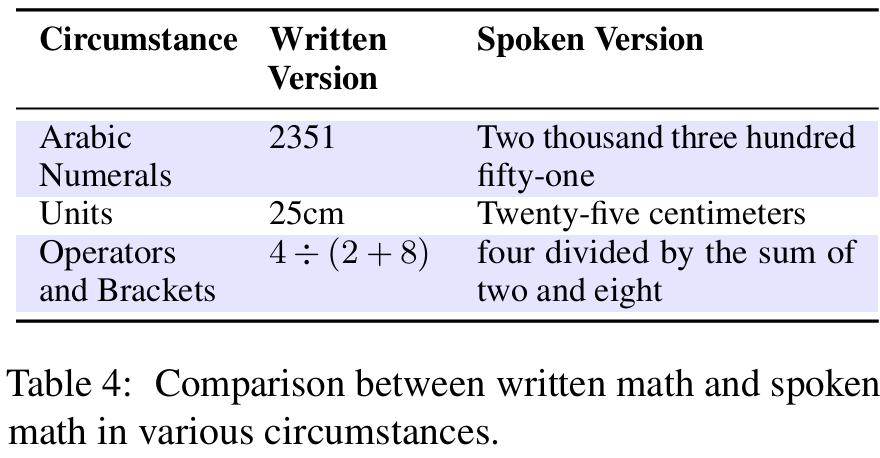
数学推理能力的开创性评估。团队首次将数学表达式转换为口语形式,并引入思维链(CoT)提示,评估语音大模型的数学推理能力。这一创新解决了数学符号难以用语音表达的技术难题。
令人震惊的评估结果
研究团队对五个最新的语音大模型进行了全面评估,结果令人深思。
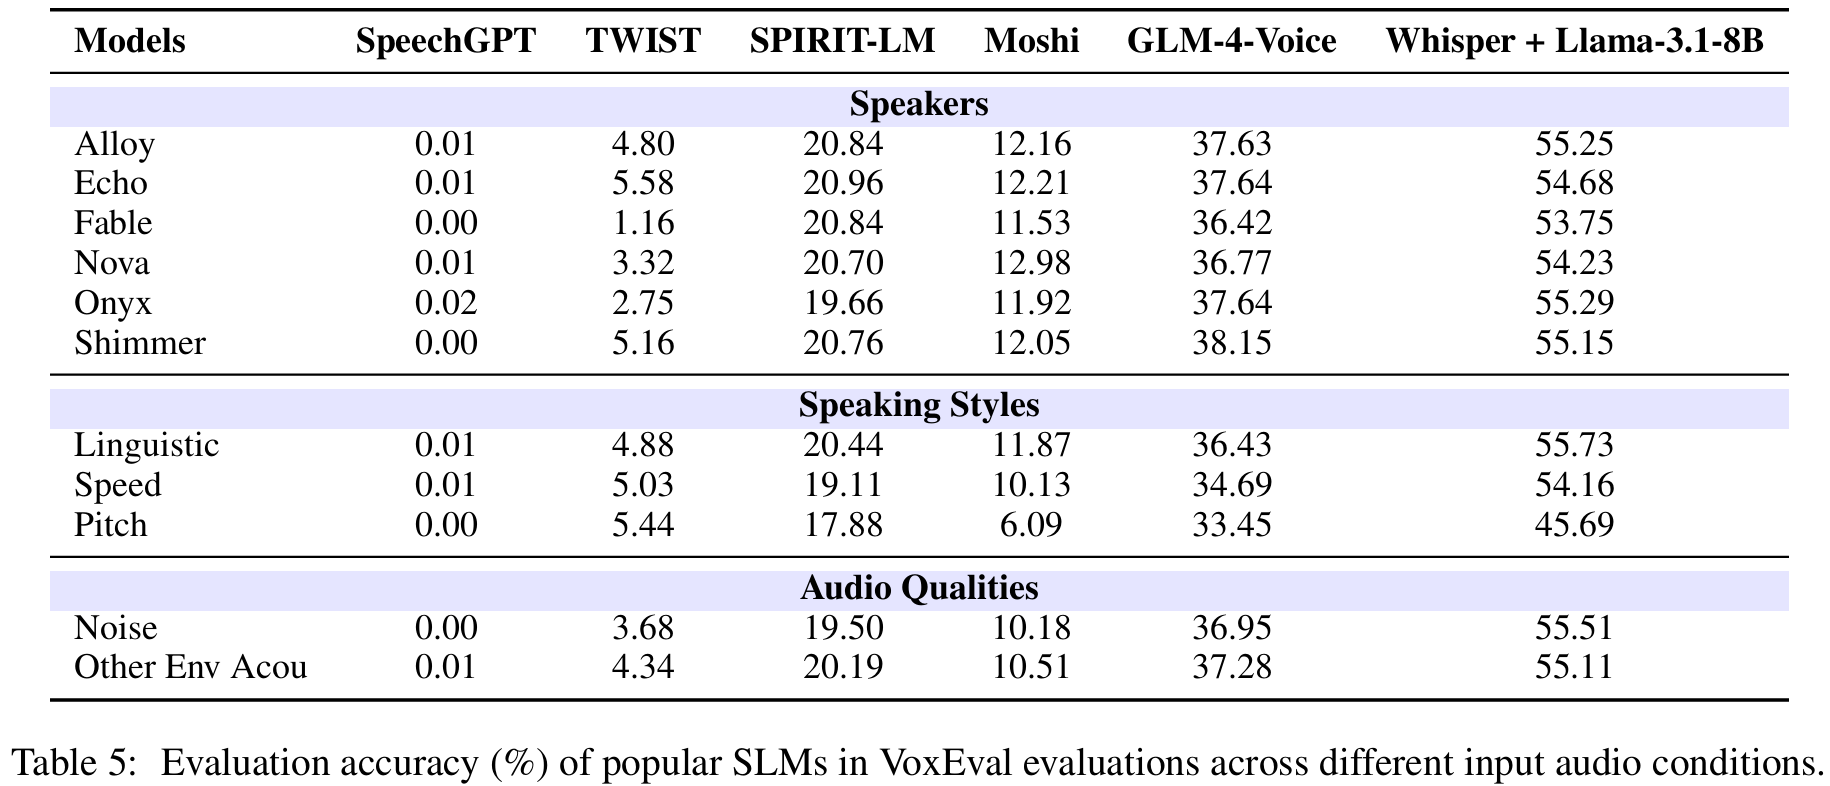
整体表现欠佳。大多数模型的准确率甚至低于随机猜测的25%,只有GLM-4-Voice勉强超过这一基线。这表明当前的语音大模型在遵循指令和准确回答方面还存在根本性问题。
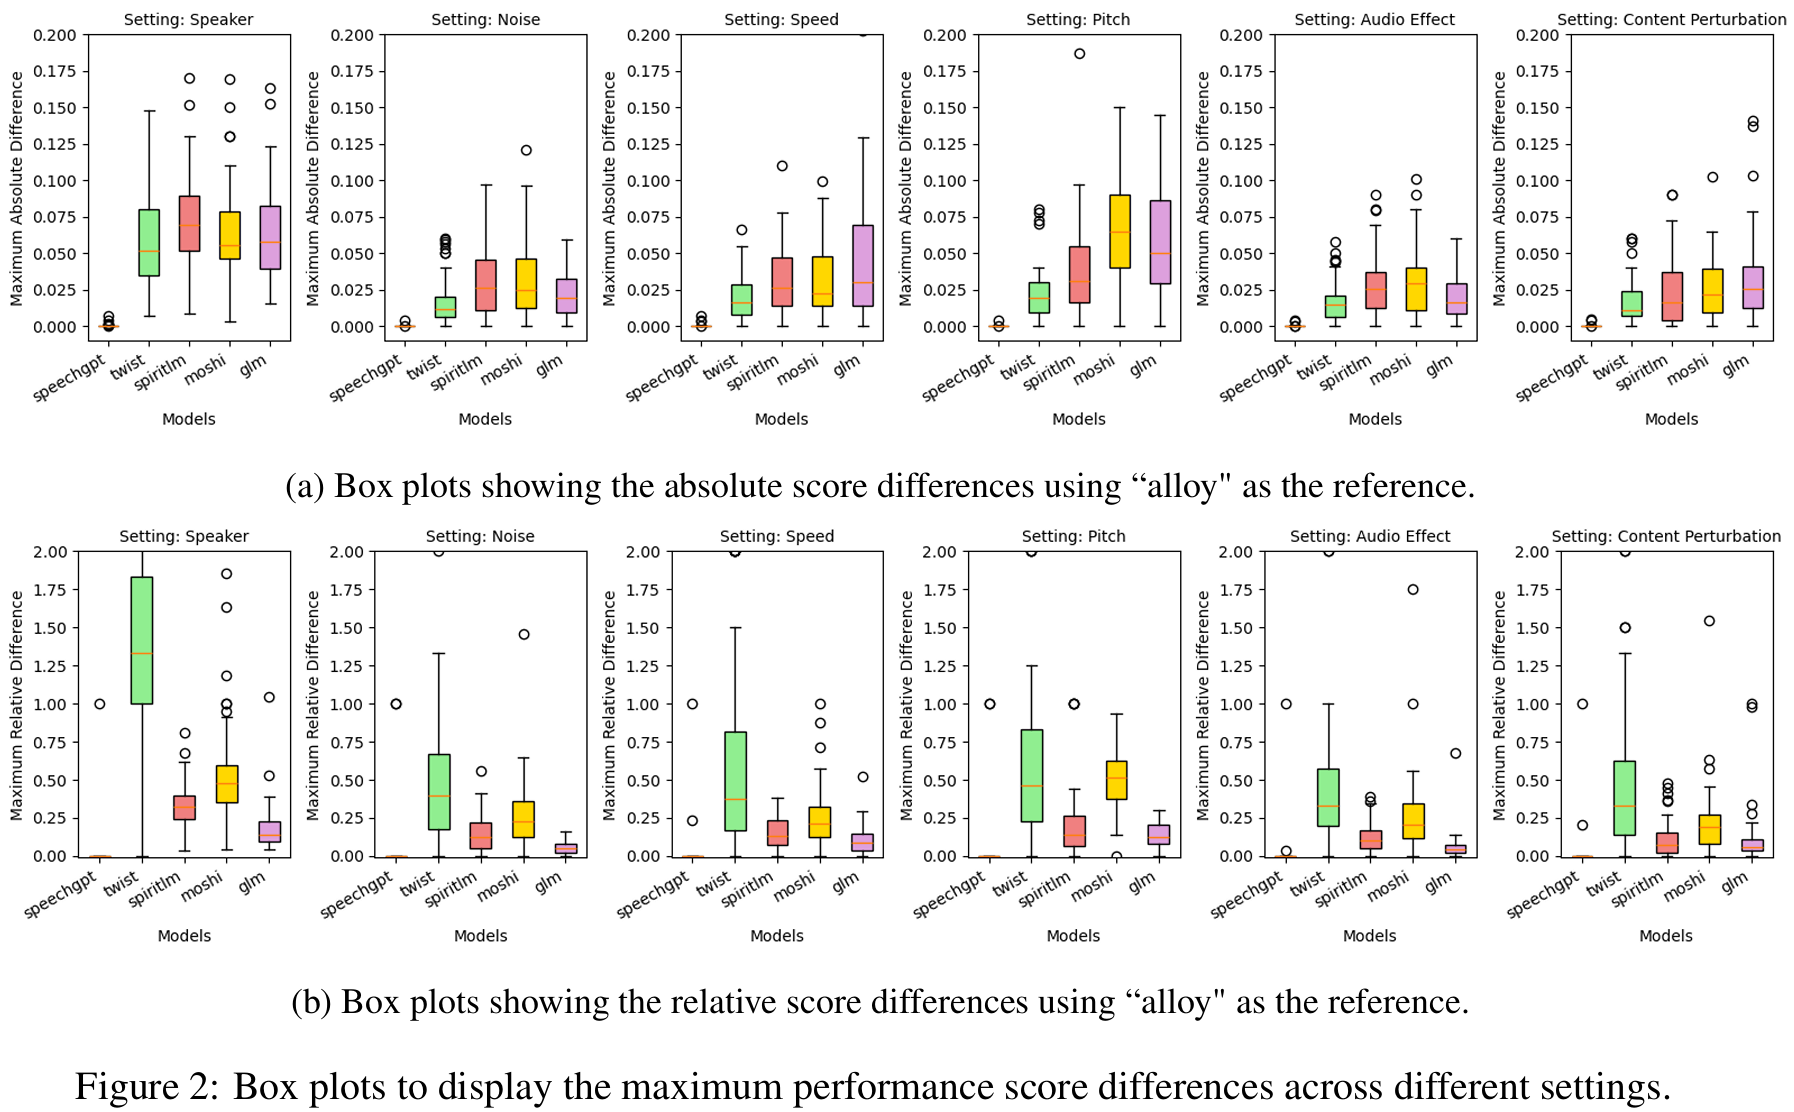
音频条件敏感性严重。虽然不同说话人对模型影响较小,但语音风格和音频质量的变化可能导致高达6%的性能下降。其中,音调变化对模型的挑战最大。
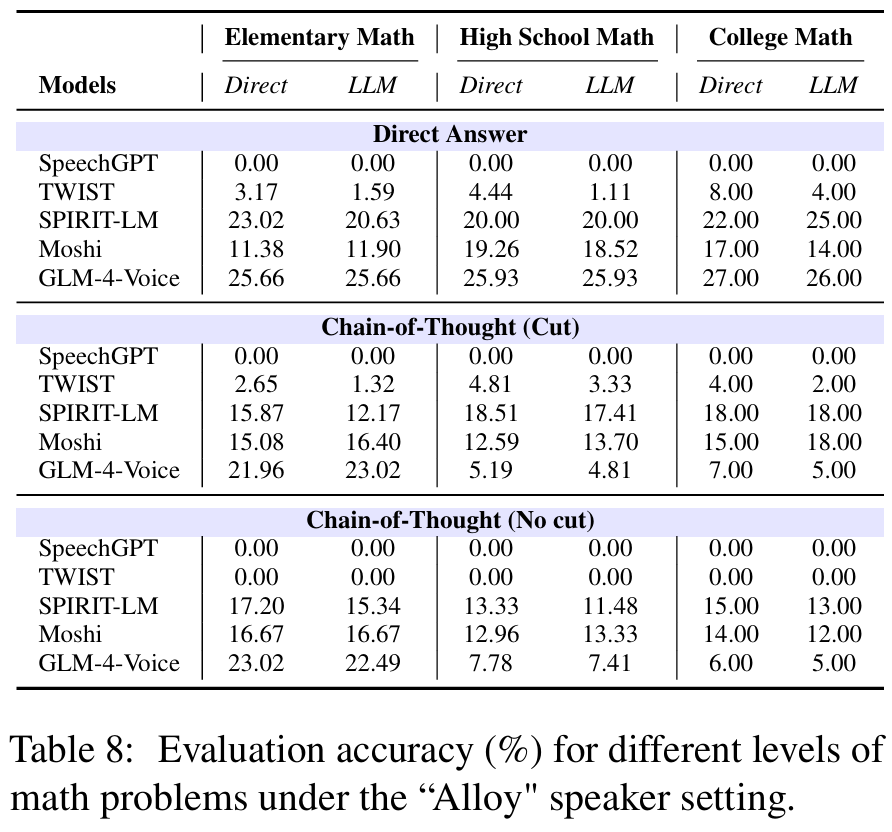
数学推理能力极其有限。令人意外的是,思维链提示不仅没有提升模型表现,反而降低了所有模型的性能。这与文本大模型的表现形成鲜明对比,说明语音大模型需要专门的推理增强技术。
对比实验揭示差距
为了更好地理解语音大模型的现状,研究团队还与级联模型(ASR+文本大模型)和闭源API模型进行了对比。
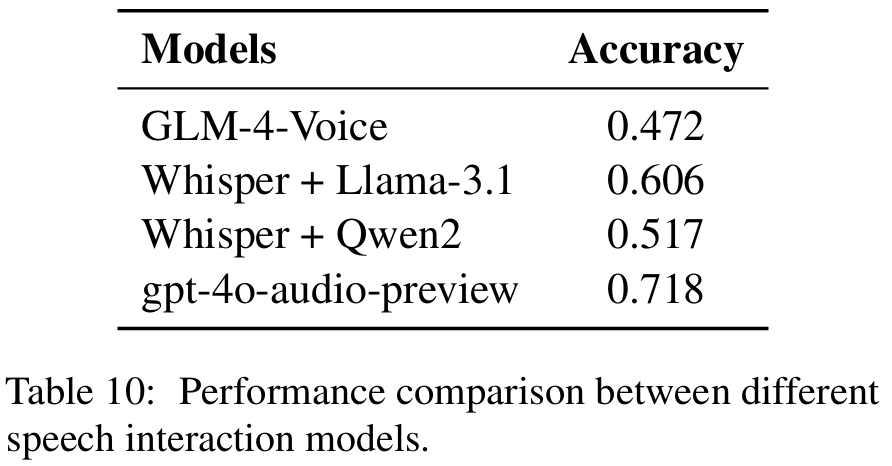
结果显示,传统的级联模型仍然优于端到端语音大模型,而闭源模型的表现更是遥遥领先。这说明语音大模型的发展潜力巨大,但仍有很长的路要走。
技术创新与方法论突破
VoxEval的构建过程本身就是一项技术创新。研究团队基于MMLU数据集,通过OpenAI的文本转语音API生成高质量的语音数据,并设计了五种语言变化技术来模拟真实的语音交互场景。
在数学表达式的处理上,团队使用GPT-4o将书面数学问题转换为口语形式,这一方法为未来的语音数学教育应用奠定了基础。
未来展望与研究意义
VoxEval的发布标志着语音大模型评估进入了新阶段。这项ACL 2025主会论文不仅揭示了当前技术的不足,更为未来的研究指明了三个关键方向:提升语音大模型的基础知识理解能力,使其能够在纯语音交互中保持高准确率;增强模型对多样化音频条件的鲁棒性,确保在真实应用场景中的稳定表现;开发专门针对语音模态的推理增强技术,特别是数学和逻辑推理能力。
开源贡献与学术影响
值得一提的是,VoxEval数据集已在GitHub上开源,为全球研究者提供了宝贵的评估工具。这项工作的发表将推动整个语音AI领域的发展,为构建更智能、更可靠的语音助手奠定坚实基础。
