
 语音小管家
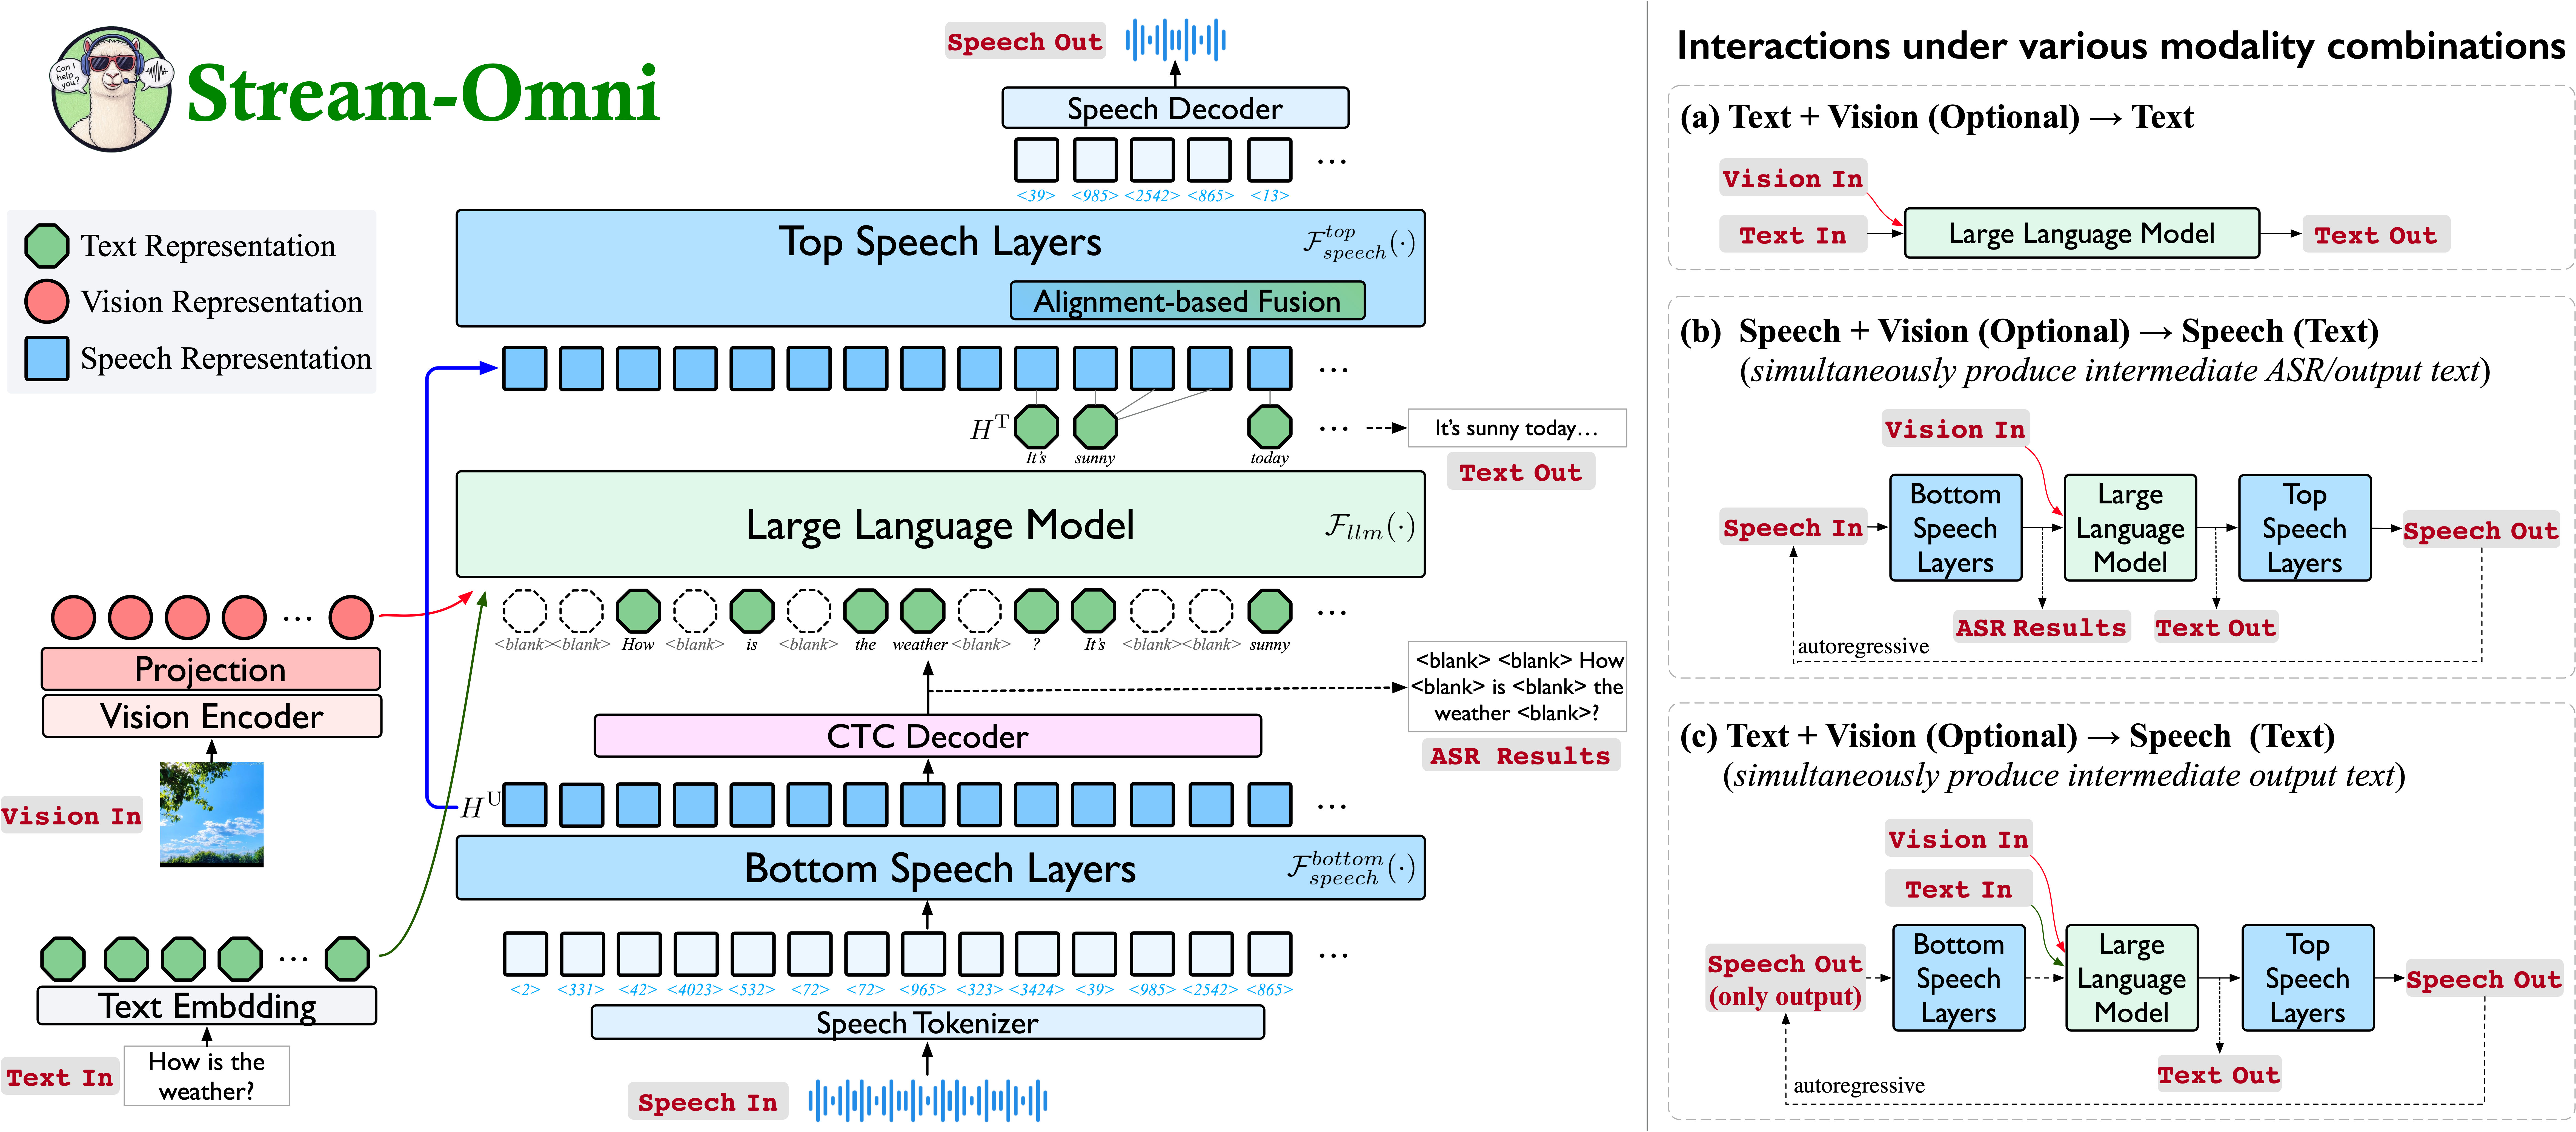
1. 多模态架构设计
骨干架构:以大型语言模型(LLM)为核心驱动,提供强大的语言理解和生成基础 视觉对齐机制:采用序列维度拼接方式,将视觉编码器提取的特征与文本输入融合 语音对齐技术:基于CTC(连接时间分类)的层维度映射,在LLM底部和顶部添加语音处理层
2. 高效训练策略
数据需求优化:仅需23,000小时语音数据等少量全模态数据完成训练 多任务学习:同时训练视觉-文本、语音-文本及全模态任务,提升跨模态理解能力 监督学习结合:通过精心设计的对齐机制实现有限数据下的高效模态对齐
3. 实时交互能力
流式处理:支持"边听边看"的实时交互体验 中间输出:在语音交互过程中同时提供ASR转录和模型响应的文本输出 同步生成:基于特殊语音层设计,实现文本和语音的同步实时生成
功能特性
多模态输入输出支持
Stream-Omni支持多种模态组合的灵活交互:
文本+视觉 → 文本输出 文本+视觉 → 语音输出 语音+视觉 → 文本输出 语音+视觉 → 语音输出
核心能力表现
视觉理解:准确解析图像内容,理解视觉信息与文本的关联 语音交互:流畅的语音识别和生成,支持自然对话 跨模态融合:将视觉、语音、文本信息有机结合,提供丰富的交互体验
应用场景
智能交通领域
在车载系统中,驾驶员通过语音查询路线信息,系统结合导航地图等视觉信息,实时提供文本提示和语音反馈,提升驾驶安全性。
教育辅助工具
学生语音提问时,系统根据教材图表等视觉内容提供详细的文本解释和语音回答,增强学习理解效果。
智能家居控制
作为家居助手,结合摄像头环境信息,通过语音指令控制设备,提供智能化的文本或语音反馈。
医疗辅助诊断
医生查看病历时,系统结合X光片、CT图像等视觉报告,提供详细的语音解释和文本分析,辅助准确诊断。
智能客服服务
客服人员语音交流时,系统实时显示相关产品图片、操作流程等视觉信息,提升服务质量和效率。
技术创新点
高效对齐机制
通过序列维度拼接和层维度映射的双重对齐策略,有效解决了多模态信息融合的技术难题。
少样本学习
相比同类模型需要大量训练数据,Stream-Omni在有限数据下实现了优秀的多模态交互性能。
实时响应优化
创新的语音层设计使模型能够同步生成文本和语音,为用户提供更自然的交互体验。
