
 语音小管家
本文介绍清华大学人机语音交互实验室(THUHCSI)在ICLR 2025发表的论文:RFWave:基于多频带Rectified Flow的高效音频波形重建。
本文由来自传音控股TEX AI的刘朋、独立研究员代东洋以及清华大学深圳国际研究生院合作完成,提出了一个名为RFWave的创新性音频波形重建方法。针对现有扩散模型在音频生成任务中质量高但速度慢的问题,RFWave巧妙地结合了多频带处理和Rectified Flow技术,实现了从梅尔频谱图或离散声学标记高效重建高保真的音频波形。RFWave的独特之处在于它在帧级别同时处理所有子带以生成复数频谱图,并借助Rectified Flow的直线传输特性,仅需10个采样步即可完成高质量重建。实验结果表明,RFWave不仅在重建质量上表现优异,更在计算效率上取得巨大突破,在RTX 4090上实现了高达160倍于实时的音频生成速度。
代码开源及评估集(涵盖语音/歌声/音效):https://github.com/bfs18/rfwave
结果展示:https://rfwave-demo.github.io/rfwave/
1、背景介绍
音频波形重建技术在增强数字交互体验方面扮演着至关重要的角色,它使得从低维特征(如梅尔频谱图)生成逼真的语音和声音成为可能,广泛应用于虚拟助手、娱乐系统等多种场景。自回归模型和生成对抗网络(GANs)等深度学习方法已在该领域取得显著进展,其音质远超传统信号处理方法。然而,自回归模型因其序列预测特性导致生成速度较慢;GANs虽然能并行预测采样点,速度较快且质量高,但面临着判别器设计复杂、训练不稳定或模式崩溃等挑战。
为了克服这些问题,研究者们开始探索基于扩散模型的波形重建方法。扩散模型展现出训练稳定和重建高质量波形的潜力,但其主要瓶颈在于推理速度:它们通常需要在波形采样点级别操作,并需要大量的采样步骤才能生成高质量样本,这使得其速度远慢于GANs,尤其是在与大规模Transformer声学模型结合时,限制了其在实时应用中的潜力。
2、主要挑战与解决方法
RFWave旨在解决现有扩散模型在音频波形重建任务中的核心挑战:如何在保持高质量输出的同时,大幅提升生成速度并降低计算资源需求。
挑战一:扩散模型采样速度慢。RFWave解决方案:引入Rectified Flow。Rectified Flow的核心思想是在数据和噪声之间构建一条直线传输路径,这使得模型可以用更少的采样步骤(本文中仅需10步)就能完成高质量的重建,从而显著提升采样效率。
挑战二:采样点级别建模带来的高GPU显存和计算需求。RFWave解决方案:模型在短时傅里叶变换(STFT)帧级别进行操作,而非单个波形采样点。这种方式能更高效地处理音频特征,并显著降低GPU显存占用。
挑战三:如何在少量采样步数和帧级别操作下仍能保证高重建质量。RFWave解决方案:
a)多频带策略(Multi-band Strategy):将复数频谱图划分为多个子带,并使用高效的ConvNeXtV2作为骨干网络同时处理所有子带。这不仅通过并行处理提升了合成速度,还通过独立建模各子带避免了累积误差,保证了音频质量。
b)优化的损失函数(Enhanced Loss Functions):引入了三种增强损失函数,包括能量平衡损失(energy-balanced loss)、重叠损失(overlap loss)和STFT损失。这些损失函数协同工作,进一步提升重建波形的整体质量,特别是在处理静音区域噪声和子带间平滑过渡方面效果突出。
c)基于直线度的采样时间点选择(Sampling Time Points based on Straightness):提出一种基于Rectified Flow传输路径直线度来选择采样时间点的技术,使得在相同的采样步数下,模型能在更具挑战性的区域进行更精细的采样,从而提升样本质量。
3、研究方案
模型整体架构
RFWave采用了一种多频带Rectified Flow结构,并以ConvNeXtV2作为其骨干网络。其核心思想是将输入的梅尔频谱图或离散声学标记(如Encodec token)转换为高保真音频波形。模型可以在时域或频域对带噪样本进行建模,而神经网络始终在STFT帧级别运行。
输入:梅尔频谱图或Encodec声学标记,以及可选的Encodec带宽索引。
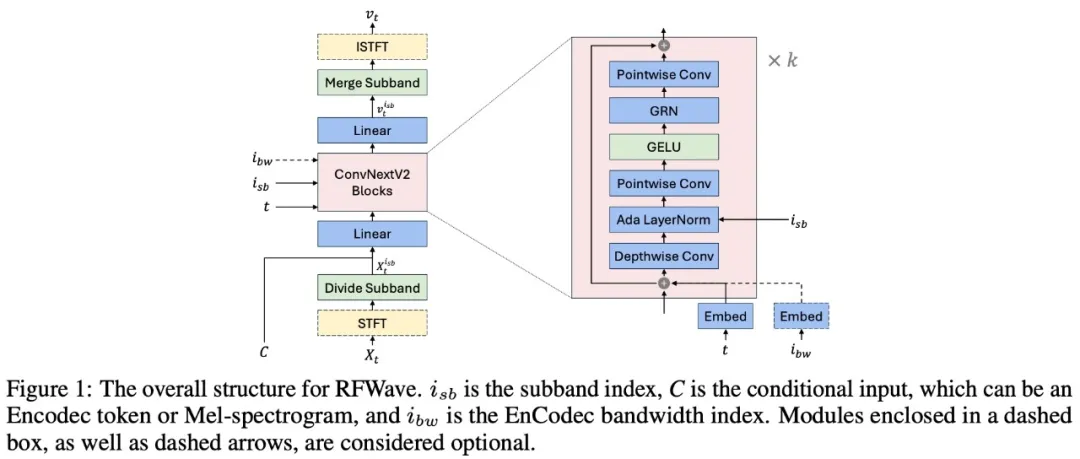
核心处理(如图1所示):
🔸初始噪声(X0)在时域或频域生成。
🔸对于时域建模,噪声首先通过STFT转换为复数频谱图。
🔸复数频谱图被划分为多个子带(Subbands)。
🔸每个子带的带噪样本 (xtisb) 与条件输入 (C, 如梅尔谱或Encodec token)、时间步 (t)、子带索引 (isb) 和可选的带宽索引 (ibw) 一同送入共享的ConvNeXtV2骨干网络,预测该子带的速度 (vtisb)。
🔸预测的子带速度合并后,如果是在时域建模,则通过ISTFT转换回时域,然后进行欧拉步进更新样本;如果是在频域建模,则直接在频域进行欧拉步进。
🔸重复此过程N(本文为10)个采样步骤。
🔸如果最后一步在频域,最终通过ISTFT得到重建波形。
关键技术细节
1.多频带处理(Multi-Band Processing):
a. 模型将全频带复数频谱图均匀划分为若干子带。
b. 所有子带共享同一个ConvNeXtV2模型进行处理,通过将子带分组到单个批次中实现并行训练/推理,显著减少了推理延迟。
c. 独立建模子带避免了低频带误差向高频带累积的问题。
2.时域vs.频域建模(Operating in Time vs. Frequency Domain):
a. 时域建模:X0, X1, Xt, vt均在时域。在每个采样步骤中,时域样本Xt需要STFT操作转换到频域送入网络,网络输出需要ISTFT操作返回时域。为了提高性能,引入了基于PQMF的波形均衡化。
b. 频域建模:X0, X1, Xt, vt均在频域(复数频谱图)。整个采样过程在频域完成,最后只需一次ISTFT。预处理涉及对复数频谱图进行维度级的均值-方差归一化。
c. 实验表明,时域配置在保留高频细节方面略有优势,尽管计算开销稍高。
3.增强损失函数(Enhanced Loss Functions):
a. 能量平衡损失(Energy-balanced Loss):针对MSE损失在静音区域无法有效抑制微小噪声的问题。通过计算真实速度(X1-X0)在特征维度上的标准差作为权重系数σ,对损失进行加权,使得模型更关注低能量区域的相对误差。
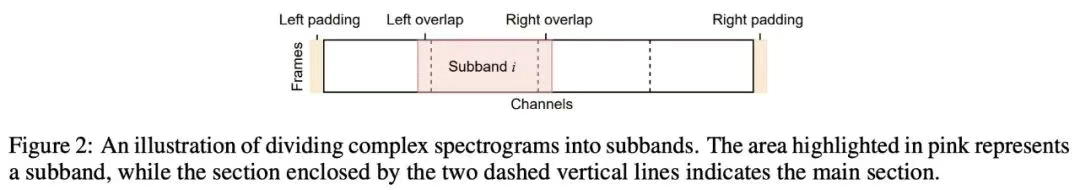
b. 重叠损失(Overlap Loss):为解决多频带独立预测可能导致的子带间不连续问题。在划分频谱图时,让相邻子带间有重叠区域(如图2所示,本文为8维)。训练时最小化重叠区域预测的MSE,推理时移除重叠部分。
c. STFT损失(STFT Loss):在GAN声码器中广泛应用的幅度谱和对数幅度谱损失。由于Rectified Flow中模型输出v(Xt,t|C)≈X1-X0,因此可以近似得到hat(X)1=X0+v(Xt,t|C),并对此近似的hat(X)1应用STFT损失,有效减少背景噪声下的伪影。
4.基于等直线度的采样时间点选择(Selecting Time Points for Euler Method via Equal Straightness):
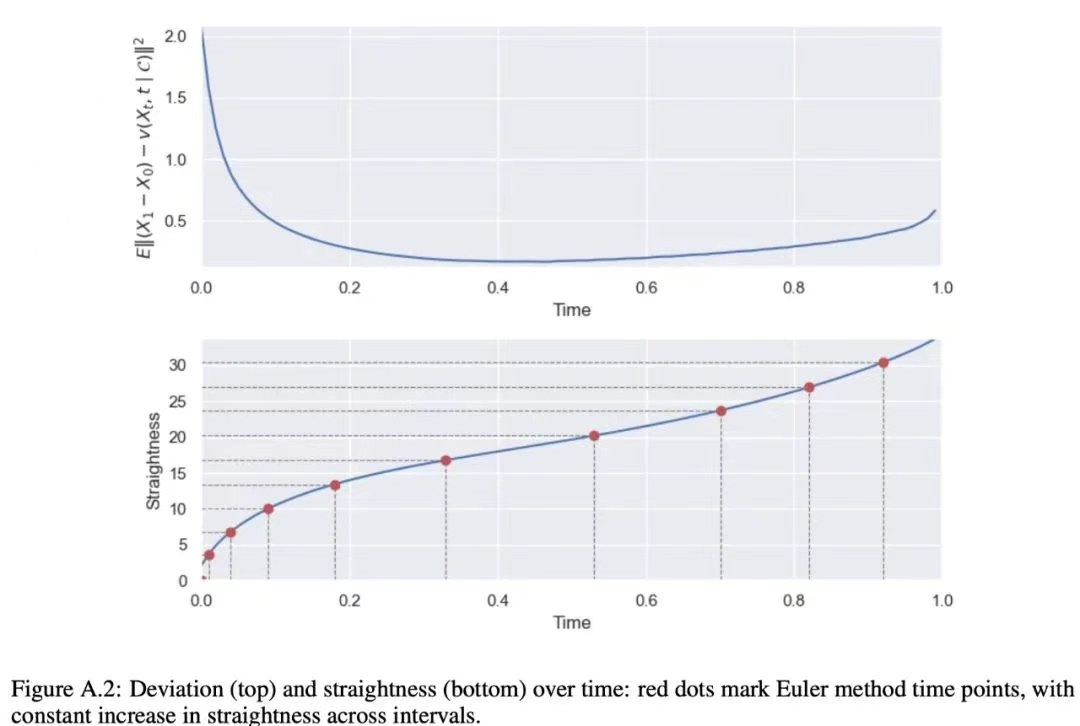
a. 传统欧拉法使用等间隔时间步。本文提出根据学习到的速度场v的“直线度”S(v) 来选择采样时间点。
b. 目标是使得每一步欧拉积分的“直线度增量”相等,这意味着在轨迹弯曲(更难预测)的区域采样更密集,而在轨迹平直的区域采样更稀疏。
c. 在相同的总采样步数下,该方法优于等间隔采样。
4、实验验证
实验数据与设置
梅尔频谱图输入:
🔸与扩散模型对比:在LibriTTS(语音)、MTG-Jamendo(音乐)、OpenCpop(歌唱)数据集上分别训练和测试。
🔸与GAN模型对比:在LibriTTS上训练,并在LibriTTS测试集(域内)和MUSDB18测试集(域外)上评估。
离散Encodec Token输入:
🔸在包含Common Voice、DNS Challenge、MTG-Jamendo、FSD50K、AudioSet的大规模混合数据集上训练通用模型。构建了一个包含15个外部数据集的900个样本的统一评估集(见代码开源中的评估集说明)。
基线模型:PriorGrad、FreGrad(扩散模型);Vocos、BigVGAN(GAN模型);EnCodec、Multi-Band Diffusion(MBD,针对token)。
评估指标:客观指标(ViSQOL、PESQ、V/UV F1、Periodicity)和主观MOS评分。
主要实验结果
梅尔频谱图作为输入
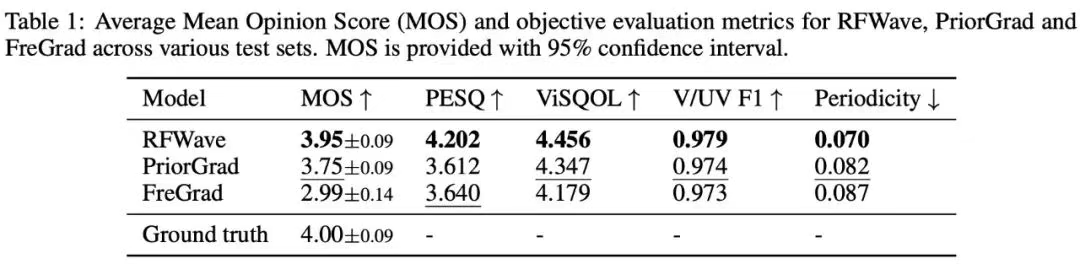
与扩散模型对比:如表1所示,RFWave在所有测试集上的客观和主观指标均一致优于PriorGrad和FreGrad。RFWave能生成更清晰、更一致的高频谐波。
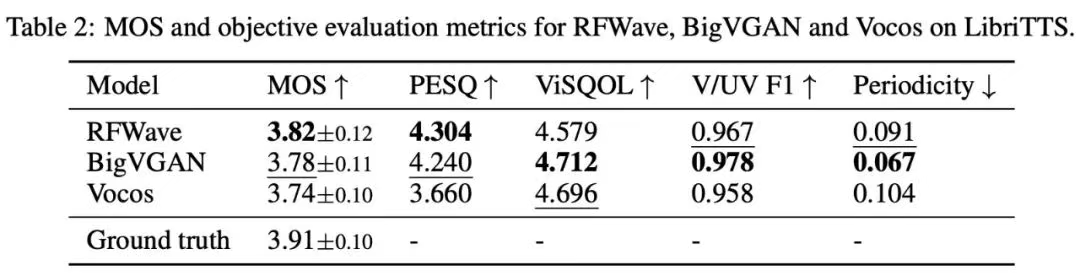
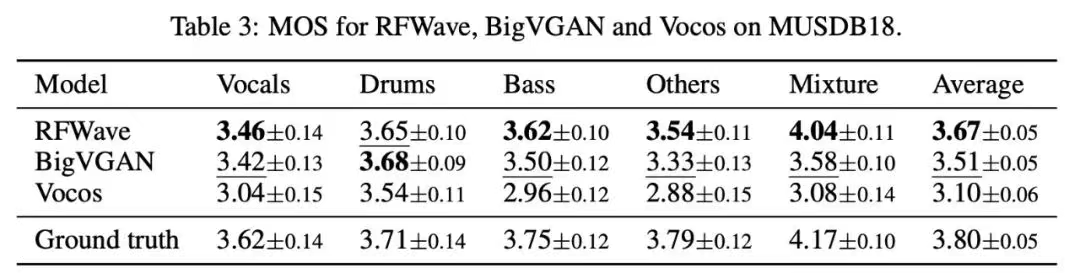
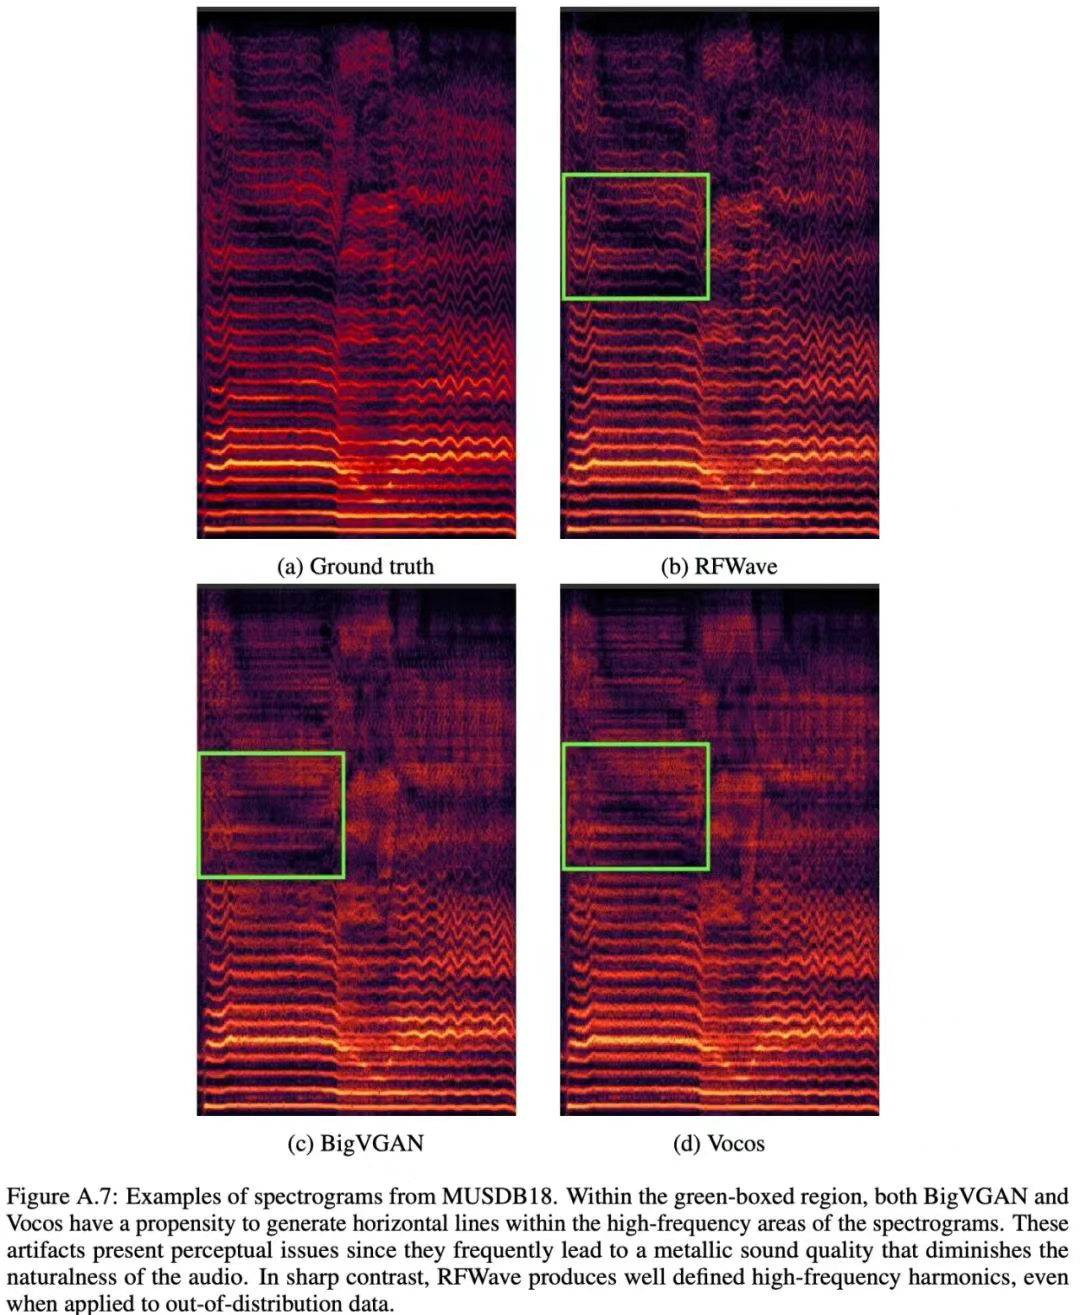
与GAN模型对比:如表2所示,在域内数据集上(LibriTTS),RFWave优于SOTA GAN模型(BigVGAN、Vocos)。如表3所示,在域外数据集上(MUSDB18),RFWave显著优于BigVGAN和Vocos,展现了作为扩散类型模型在泛化性和鲁棒性上的明显优势;如图A.7所示,GAN模型倾向于在高频区域产生水平线伪影,而RFWave即使在域外数据上也能持续产生清晰的高频谐波。
离散Encodec Token作为输入
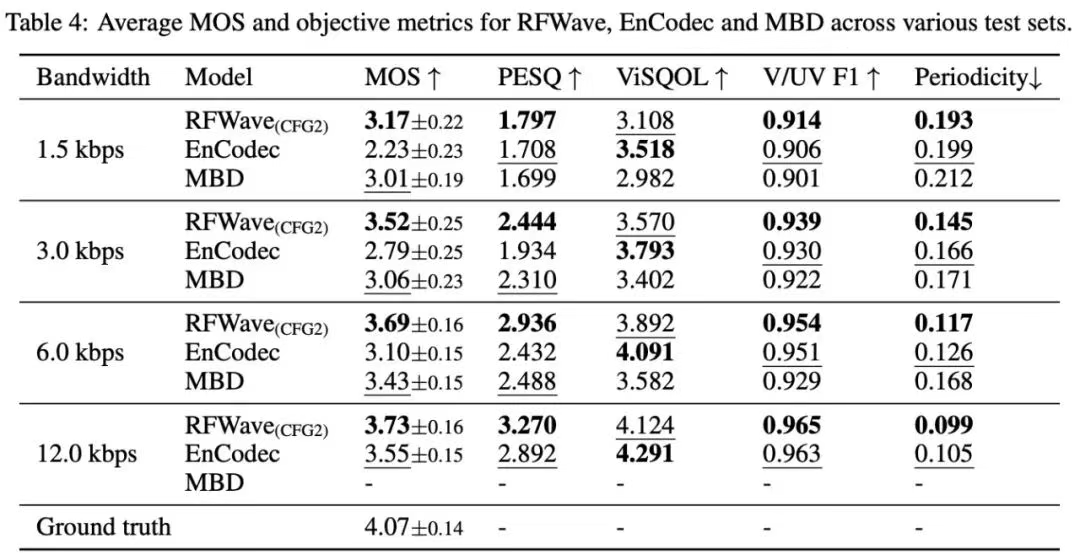
如表4所示,RFWave(配合Classifier-Free Guidance, CFG)在多数带宽和听觉内容下的平均MOS和客观指标上达到最优(ViSQOL除外,该指标可能对GAN模型有偏好)。随着带宽增加,性能普遍提升。从6.0kbps增加到12.0kbps对RFWave的MOS提升略微。
消融实验与分析
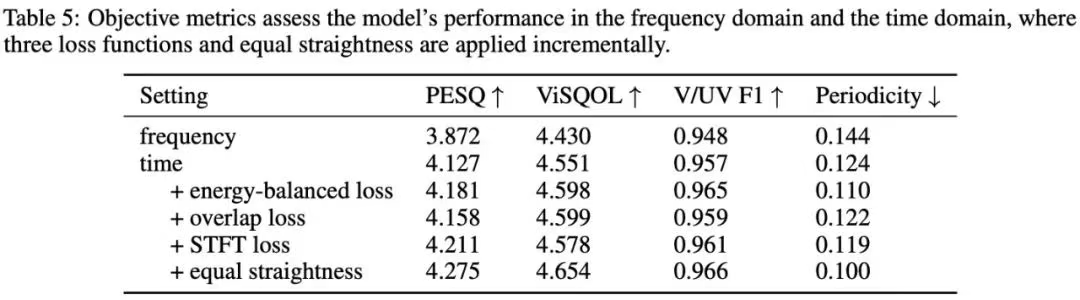
时域vs.频域:如表5所示,时域模型性能优于频域模型,因其ISTFT操作引入了周期性信号,类似Snake激活函数的效果。
损失函数:能量平衡损失和STFT损失均带来性能提升。重叠损失虽略微降低PESQ,但能确保子带间平滑过渡。
等直线度采样:提升了整体性能。
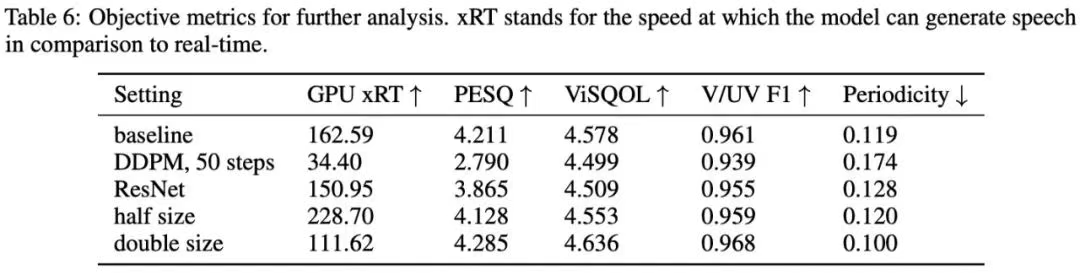
骨干网络与流类型:如表6所示,Rectified Flow对于模型高效生成高质量样本至关重要。ConvNeXtV2骨干优于相似参数量的ResNet。增加骨干网络大小能提升性能但降低效率。
推理速度
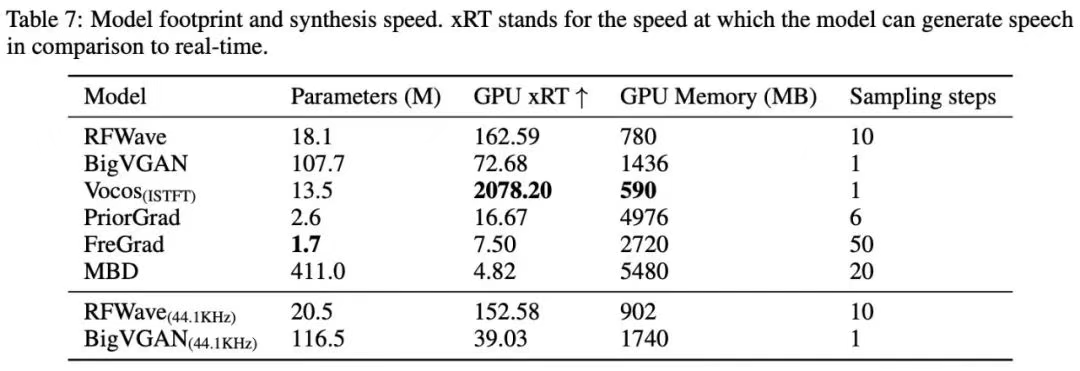
如表7所示,在NVIDIA GeForce RTX 4090 GPU上,RFWave(22.05kHz)的推理速度高达162.59倍实时(xRT),远超PriorGrad(16.67xRT)和FreGrad(7.50xRT),甚至快于BigVGAN(72.68xRT)。在处理高采样率音频(44.1kHz)时,RFWave(152.58xRT)相比BigVGAN(39.03xRT)的优势更为明显,显示了帧级模型在处理高分辨率音频时的巨大潜力。
5、结论
本文提出了RFWave,一种基于多频带Rectified Flow的音频波形重建新方法。通过精心设计,RFWave有效克服了传统Diffusion类模型推理速度慢的难题。其核心优势在于能够在帧级别同时处理所有子带生成复数频谱图,并结合Rectified Flow的特性,仅用少量采样步骤(10步)即可实现高质量音频重建。全面的实验评估表明,RFWave不仅达到了SOTA的重建质量,更在计算效率上实现了飞跃,生成速度高达160倍实时,与GAN相当甚至更快,为实时、高要求的音频生成应用开辟了新的可能性。这项工作为未来高效生成模型的设计提供了宝贵的思路。
