
 语音小管家
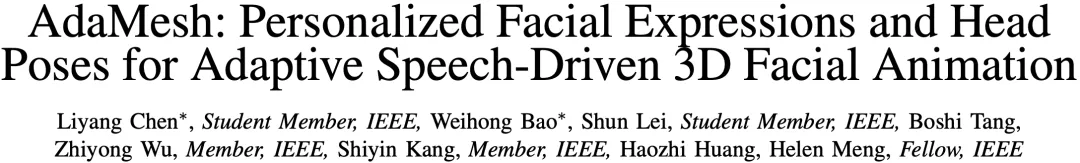
语音驱动的三维人脸动画旨在根据输入语音生成同步的面部运动,这项技术近年来受到了广泛关注。然而,现有方法普遍忽略了说话者的个性化风格,例如独特的面部表情和头部姿态,导致生成的人脸动画缺乏真实感和个性表达。部分工作尝试通过微调模型来建模不同人物的个体风格,但受限于训练样本的数量,生成效果仍不理想。
为此,本文提出一个全新的基于个性化面部表情与头部姿态建模的语音驱动三维人脸动画生成方法AdaMesh。该方法只需一段约10秒的视频作为参考,即可学习说话者独特的表达风格,生成既生动真实又具有个性化特征的人脸动画。所提方法包含两个关键组件:
表情适配器(Expression Adapter):一种低秩混合微调机制,用于高效微调表情模块,从而精准捕捉个性化面部表情风格;
头部姿态适配器(Pose Adapter):一个离散头部姿态先验,通过语义感知的姿态风格矩阵检索出合适的头部姿态风格嵌入,无需微调即可实现个性化的头部动作建模。
在多个实验设置下,AdaMesh均显著优于现有最先进方法,能够更好地还原参考视频中的说话风格,同时生成自然、富有表现力的三维人脸动画。
论文:https://ieeexplore.ieee.org/document/10884957/
代码开源及结果展示:https://github.com/thuhcsi/AdaMesh
1、背景介绍
语音在人类交流中扮演着重要角色,而在虚拟现实、影视制作和游戏创作等场景中,如何让虚拟角色“开口说话”且看起来真实自然,正成为技术发展的关键之一。近年来,语音驱动的三维人脸动画逐渐受到学术界与工业界的广泛关注。这项技术的核心目标是根据输入语音生成同步的面部动画,包括嘴唇运动、面部表情和头部姿态。
以往的研究多聚焦于提升嘴唇与语音的同步程度,在“说得准”方面取得了明显进展,但却往往忽视了说话风格中的个性化因素,例如面部表情的张力、头部动作的节奏与幅度等。在实际交流中,个性化的表达风格,哪怕是一个微妙的抬眉或轻轻的点头都可能大大增强虚拟角色的表现力和互动感染力。缺乏这些元素的人脸动画虽然“对口型”,但却依然显得僵硬、缺乏生气。因此,如何让人脸动画不仅“说得对”、还要“说得像”、甚至“说得有风格”,成为了当前语音驱动人脸动画研究的一个关键挑战。本文探索的方向,正是赋予虚拟角色个性化的表达能力,让他们不仅能“说”,还能以独特而自然的方式“表达”。
2、关键挑战
在实现个性化语音驱动人脸动画的过程中,面临以下几个关键挑战:
数据稀缺导致的过拟合与遗忘问题:在实际应用中,用户往往只能提供不足一分钟的视频用作风格参考。在如此有限的数据条件下,直接对整个模型进行微调容易导致灾难性遗忘,即模型在学习新说话风格的同时丧失原有的语音同步能力,同时也容易发生过拟合,使得模型在新语音上生成的表情变得僵硬、缺乏丰富性。
头部动作的生成不够多样:语音对头部动作的控制较弱,在样本稀缺时通过简单回归方式生成动作,容易导致生成结果趋于平均、动作幅度变小,缺乏真实对话中的表现力和变化性。
表情与姿态的个性化建模被“一刀切”处理:传统方法往往用同一个机制建模面部表情和头部动作,忽略了两者在语义承载、动态范围等方面的差异,难以充分刻画其各自的个性化风格。
3、主要贡献
为解决上述问题,本文提出了AdaMesh,一个新颖的自适应语音驱动三维人脸动画方法。该方法针对面部表情与头部姿态的不同特性,设计了两个专用的微调适配器:
表情适配器(Expression Adapter):针对微调易过拟合的问题,本文基于低秩微调(LoRA)机制设计了一个高效的数据驱动微调模块,适用于少样本个性化学习。为进一步捕捉表情的时间动态特性,本文将LoRA扩展至卷积操作,并提出了混合低秩微调(Mixture-of-LoRA, MoLoRA)策略,通过不同rank大小的LoRA组合提升表达能力与灵活性。
头部姿态适配器(Pose Adapter):针对头部动作缺乏多样性的难题,本文将姿态生成任务从“回归问题”转化为“生成问题”,采用向量量化变分自编码器(VQ-VAE)结合生成式Transformer模型(PoseGPT)实现更具多样性的动作生成。此外,本文提出了语义感知姿态风格矩阵(Semantic-aware Pose Style Matrix),以检索匹配用户风格的姿态嵌入,从而更好地保留动作中语义上的“肯定”、“否定”与“转折”等交流特征。
通过这一套个性化建模机制,AdaMesh不仅显著提升了面部表情与头部动作的个性还原能力,也有效缓解了小样本带来的过拟合与动作单一等问题。
4、研究方案
模型总体架构
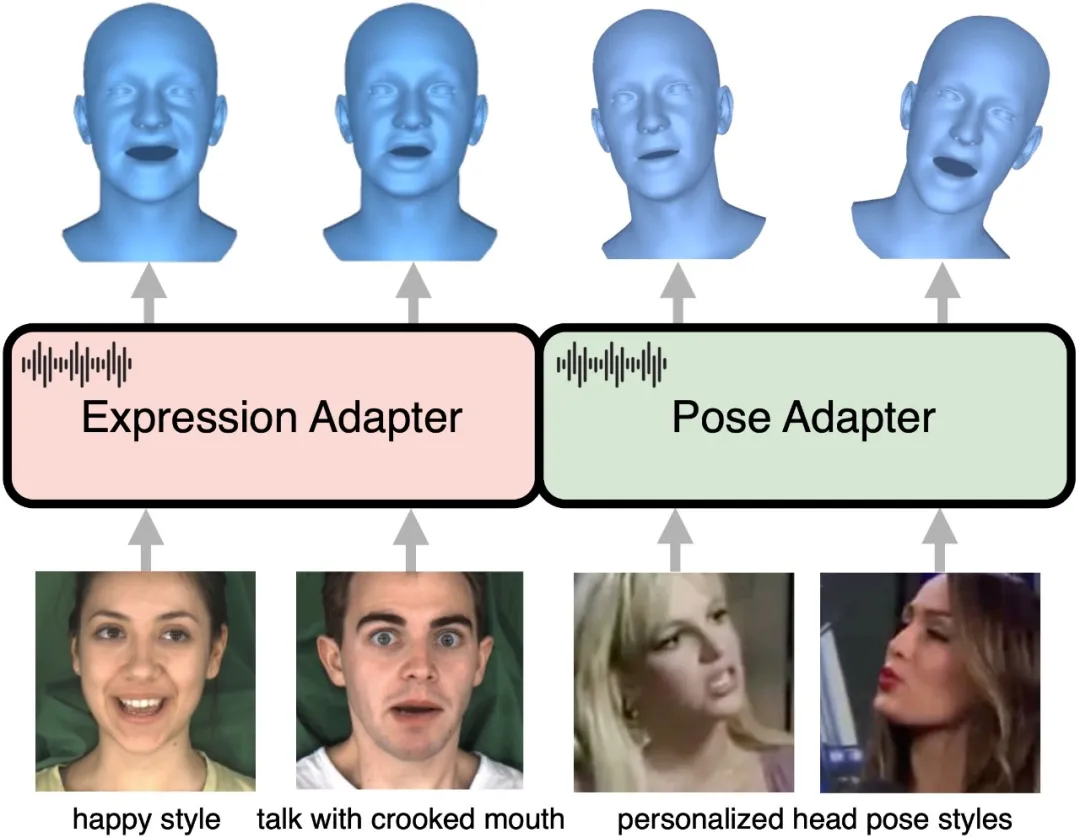
上图展示了本文提出的语音驱动三维人脸动画生成方法,专为捕捉特定人物的个性化面部表情与头部姿态而设计。考虑到面部表情与头部姿态在数据特性上的显著差异,本文独立建模这两种风格特征:
面部表情建模:面部表情通常与语音内容具有较强相关性,即语音中蕴含的文本内容可被映射为基本的面部动作。在此基础上,个体的表情风格可以被视为一种偏移信号,叠加在通用面部动作之上,从而表现出不同情绪。 因此,本文构建了一个表情适配器,利用参考视频中的表情序列进行风格迁移,使模型能够生成更具表现力的个性化表情。
头部姿态建模:与表情不同,头部动作更强调语义表达(如点头表示肯定、摇头表示否定等),并具有显著的个体风格特征。本文将头部姿态建模为一种周期性信号,在语音的驱动下呈现特定语义上的“起伏”。因此,本文提出头部姿态适配器,通过构建语义感知姿态风格矩阵,结合离散头部动作词典与自回归姿态预测器,从参考视频中抽取用户独有的姿态风格,实现多样化的头部动作生成。
最终,所提方法将生成的个性化面部表情与头部姿态融合,利用参数化人脸模型进行三维重建和渲染,输出高保真度的三维人脸动画结果,赋予虚拟角色“有表情”“有态度”的交流能力。
表情适配器
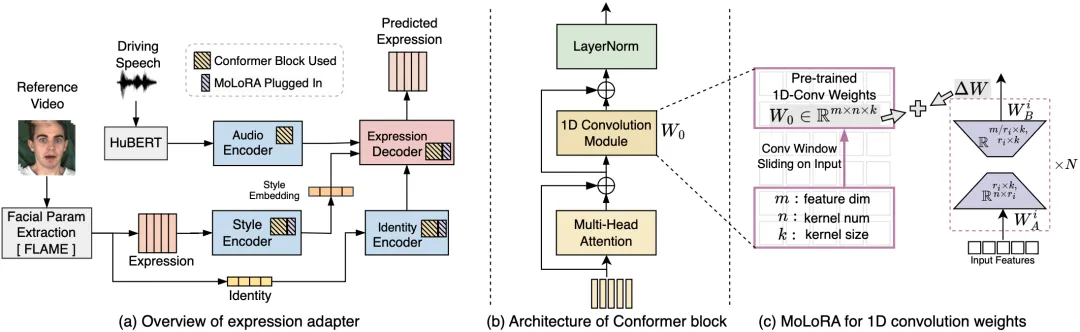
如上图所示,表情适配器包含多个功能模块:(1)音频编码器(Audio Encoder),使用 HuBERT提取语音中的鲁棒语义信息,并进一步通过三层Conformer模型编码这些特征,为后续的表情预测提供稳定输入。(2)身份编码器(Identity Encoder):不同说话人的面部结构差异会显著影响表情表现。为避免传统方法中one-hot编码带来的泛化能力差问题,AdaMesh借助参数化人脸模型提取连续型身份参数,并经过卷积模块与条件归一化处理,提取个体身份特征。(3)风格编码器(Style Encoder):语音中包含的仅是语义信息,无法直接预测个体化的表情风格。因此,本文将参考视频中的表情序列编码为一个紧凑的风格嵌入(Style Embedding),并与语音特征、身份特征一起输入到解码器中,辅助生成具有风格特征的表情序列。(4)表情解码器(Expression Decoder):该模块采用残差连接结构堆叠多个Conformer层,结合多源信息进行粗到细的表情预测,实现面部细节与整体动态的协调建模。
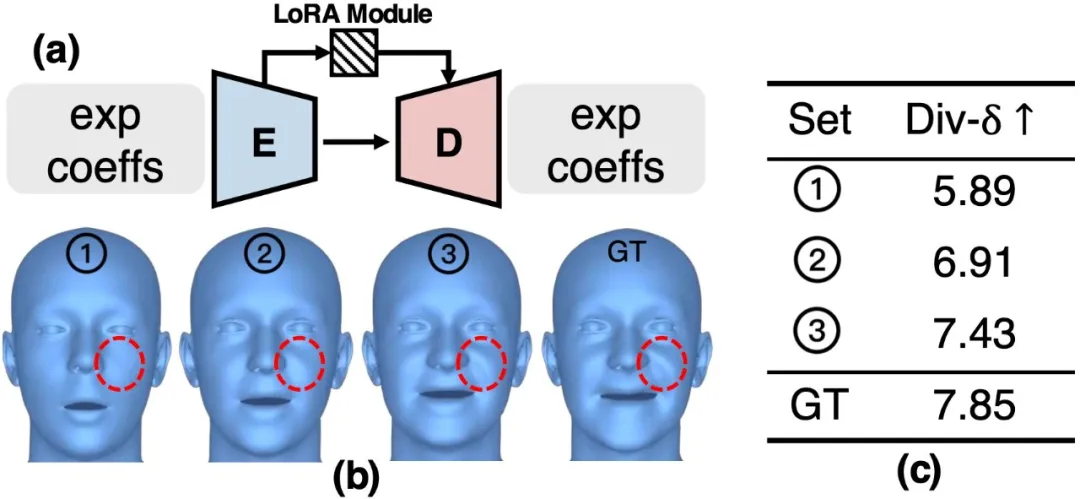
其中,混合抵制微调(MoLoRA)是多尺度表情建模的关键。面部表情的时间动态是多尺度的,既包含粗粒度的情绪信息(如喜怒哀乐),也包含精细的肌肉细节(如嘴角翘动、皱眉等)。下图中,我们观察到不同秩大小的LoRA模块可以捕捉不同层级的面部特征:低秩可以保留整体面部的粗粒度情感特征;高秩可以捕捉细腻的局部动态(如颊部肌肉变化),提升表情的多样性与真实感。因此,本文组合不同秩的LoRA模块以提高微调参数的表达能力。此外,与传统LoRA仅作用于线性层不同,MoLoRA将低秩矩阵分解扩展到了卷积层,使其能更灵活地建模局部空间特征。
MoLoRA机制被运用在表情适配器中除音频编码器的所有模块上,微调后新模块参数可以表示为下列公式,即原模块参数W0和MoLoRA参数ΔW之和,MoLoRA即为N个不同秩的卷积或线性层参数的组合:
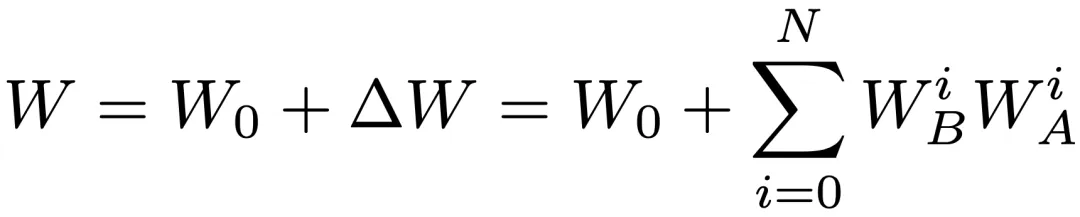
头部姿态适配器
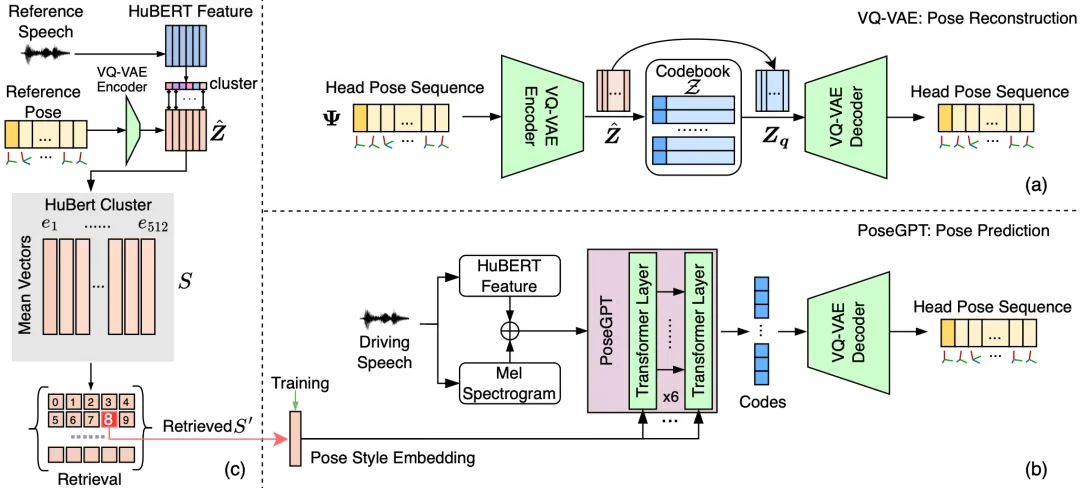
上图展示了头部姿态适配器,该模块的核心设计包括:
1.VQ-VAE建立离散头部动作词典:头部姿态作为一种连续时间序列,其变化规律往往受语音语义与个体风格双重影响。为了覆盖更广泛的动作风格并增强模型的泛化能力,本文首先使用VQ-VAE对头部姿态进行离散化建模。具体而言,输入的连续头部姿态序列经过卷积编码器压缩为上下文感知的潜在表示,随后通过矢量量化映射到最接近的离散代码,形成离散的姿态序列。该过程无需语音参与,因此可在大规模视频数据集上训练,构建覆盖丰富风格的离散姿态空间。
2.PoseGPT从语音中预测姿态编码:在得到稳定的离散姿态空间后,本文引入PoseGPT,实现从语音到姿态的自回归生成。PoseGPT将语音的HuBERT特征与梅尔频谱图编码为多层Transformer输入,同时结合每个训练样本的姿态风格标签(Style Embedding),最终生成对应的头部动作离散姿态代码。通过交叉注意力机制,PoseGPT能够有效学习语音语义、韵律与头部动作之间的映射关系,并通过教师强制训练(Teacher Forcing)稳定学习过程。最终生成的离散姿态序列将输入到VQ-VAE解码器中,恢复为连续的头部动作轨迹。
3.语义感知的姿态风格矩阵与检索:传统的动作风格多仅考虑时序动态,忽略了语义因素的影响。为解决该问题,本文借助HuBERT的语义聚类能力,结合姿态离散序列,提出了语义感知姿态风格矩阵。具体而言,HuBERT将语音帧聚类为512个语义单元,而对应的姿态帧通过VQ-VAE编码器转换为潜在表示。本文根据语音帧的语义标签,将所有具有相同语义单元的姿态特征聚合,构建一个语义-姿态对应矩阵S,实现对同一语义单元下典型姿态风格的编码。这种方式不仅增强了姿态风格的多样性表达能力,也使得风格迁移具备更强的语义一致性。最终,在“微调”阶段,PoseGPT根据输入语音所隐含的语义特征,从风格数据库中检索最接近的语义姿态矩阵,实现零微调下的个性化姿态风格迁移。
5、实验验证
实验数据集
由于缺乏具备个性化说话风格的3D人脸动画公开数据集,本文在训练中采用了多种2D音视频人脸说话数据集。在表情风格适配器的预训练阶段,本文采用了中性风格的Obama演讲数据集作为基础数据源;在头部姿态风格适配器的预训练阶段,则使用了大规模的VoxCeleb2数据集,该数据集包含约100万段由6112位说话人录制的视频,具备丰富多样且自然的头部动作风格。
在模型适配微调阶段,本文为表情风格适配器引入了MEAD数据集,该数据集包含60位演员在7种不同情绪下的多段表达视频,有助于模型学习更具情感色彩的面部表达。针对姿态风格适配器的训练,本文采用了VoxCeleb2-Test子集进行迁移学习,测试集中说话人未在预训练中出现,从而验证模型的泛化能力。
数据预处理
本文将所有视频数据统一重采样至25帧/秒。由于原始数据为2D视频,本文采用当前最先进的人脸三维重建方法SPECTRE提取每帧对应的FLAME三维人脸参数。为了进一步提升重建数据的真实性,本文并未直接使用预训练模型进行推理,而是对每段视频单独微调SPECTRE网络参数,从而获得更高保真的3D重建效果。基于提取出的身份(Identity)、表情(Expression)以及头部姿态(Pose)参数,可逐帧还原对应的3D人脸网格顶点。
在音频方面,本文将语音下采样至16kHz,并使用HuBERT-base模型提取语音特征。由于音频与视频的帧率不一致,本文通过插值方式将语音特征对齐至视频帧率,确保音视频信息的时间同步。
可视化对比
本研究将AdaMesh与多种先进的方法从以下三个方面进行比较:
语音口型同步度:指角色的口型动作与语音内容是否同步,即角色在说话时嘴唇的张合、形状是否准确反映出语音的发音。高同步度意味着用户观看时会觉得角色“说话自然”,口型与声音协调一致。
面部表情丰富度:指角色在说话或互动时所展现出的面部表情是否多样、真实,能够体现情绪变化(如开心、生气、惊讶等),丰富的面部表情有助于提升角色的表现力和用户的沉浸感。
头部运动自然度:指角色头部的动作是否符合人类自然的行为习惯,例如点头、侧头、微微转动等,自然的头部运动能增强交流的真实性,减少僵硬、机械的感觉。
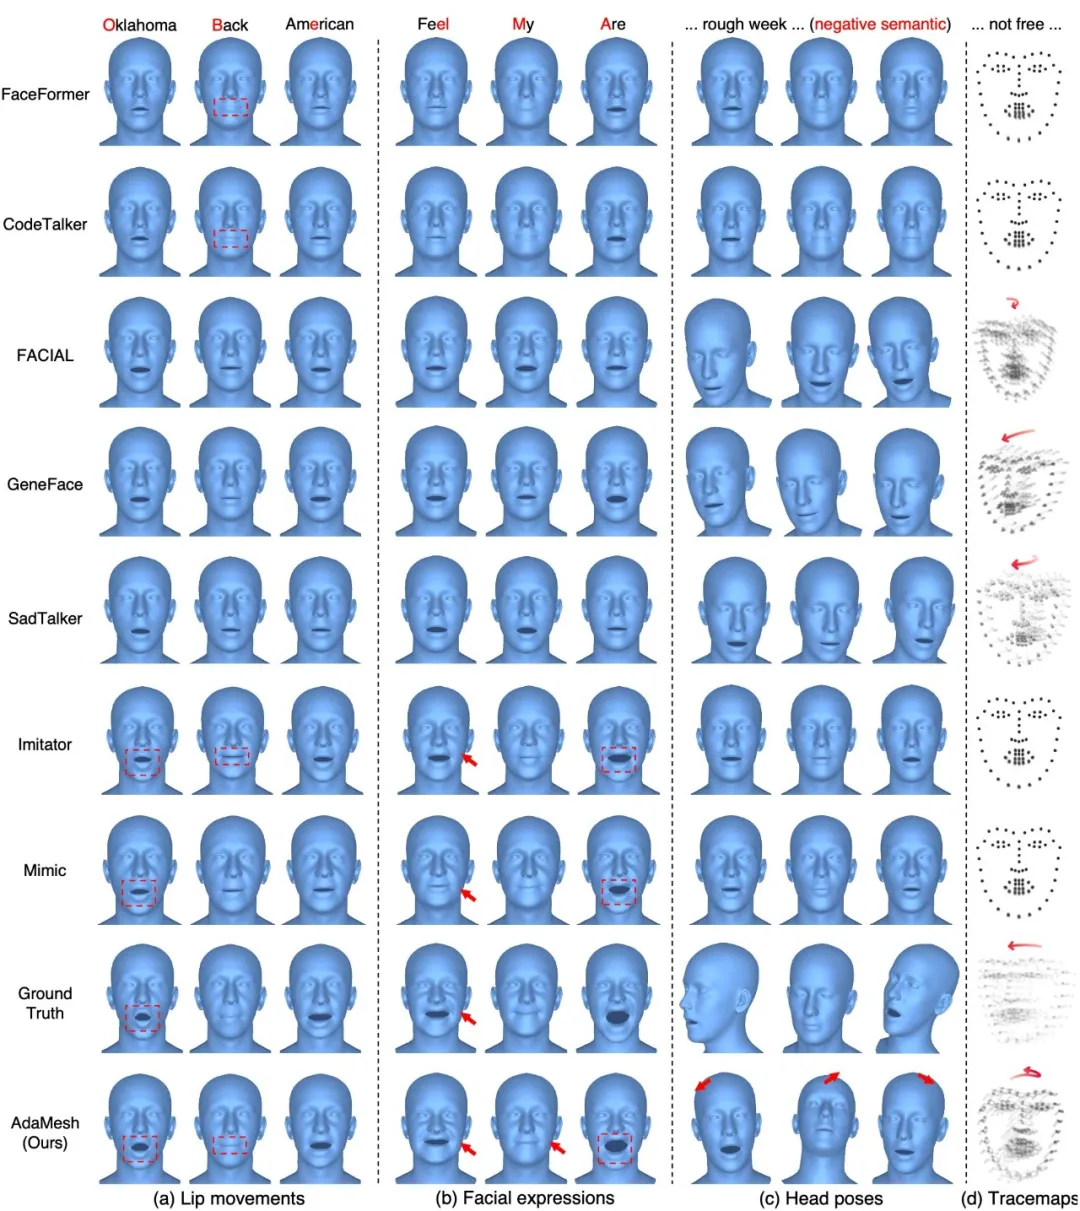
从上图可以看出,AdaMesh在发音(如/ou/和/ei/)时能生成更准确的嘴型,比其他方法更自然。AdaMesh能保留更丰富的面部细节,尤其在面颊和嘴唇区域,比其他方法更具表现力。MoLoRA模块在不影响口型准确度的前提下,大大增强了表情的多样性和风格。AdaMesh在表达情绪明显的句子中,生成的头部动作幅度更大、更接近真实表现,尤其在表达负面情绪时更为自然。轨迹图显示其头部运动具有更高的自由度,反映了其在生成多样性方面的优势。
客观评测实验
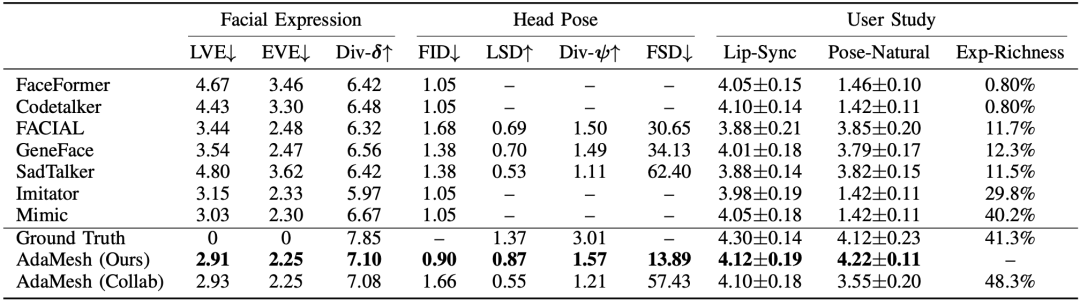
上表展示了AdaMesh与对比方法的多种客观指标评测结果。在面部表情方面,本文方法在唇部顶点误差(LVE)上取得了最低值,表明AdaMesh在唇动同步方面具有更高的准确性。AdaMesh同时在唇部以外区域顶点误差(EVE)上也取得最优表现,说明该方法能有效适应说话人的个性化表情风格。在表情多样性方面,AdaMesh的表情多样性分数最高,验证了模型生成的面部动态更生动、更自然。在头部姿态方面,AdaMesh在头部运动真实(FID)分数上显著优于其他方法,说明其生成的头部动作更逼真。特征语义对齐距离(FSD)得分最低也表明其生成的头部姿态具有更好的语义一致性。
微调数据量与参数量影响
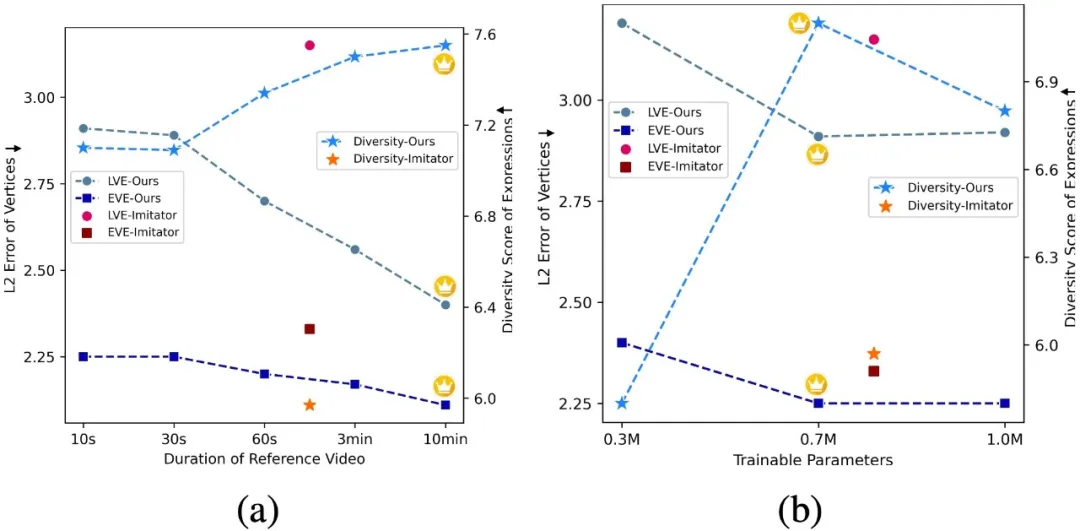
由于姿态适配器本质上是一个零样本模型,因此本文仅分析微调数据量对表情适配器性能的影响。上图(a)中,同一颜色系列的点表示相同的方法,而相同的标记符号代表相同的评估指标,因此具有相同标记的点可在不同方法间进行对比。图中包含两个y轴,图例明确指出每个y轴所对应的指标。从图中可以得出结论:微调数据量的增加能够显著提升模型性能。在相同数据量的条件下,AdaMesh的整体表现明显优于Imitator,进一步验证了本文方法在微调效率和性能上的优势。
上图(b)比较了不同秩大小组合的MoLoRA与传统的LoRA。从图中可以观察到,在秩大小组合为[4, 8, 16, 32](横坐标为0.7M)时,模型获得了最高的表情多样性评分,同时在LVE和EVE指标上也取得了最低的误差值。此外,在优化参数数量大致相同的前提下,本文方法在所有评估指标上均优于Imitator,进一步验证了MoLoRA在参数效率和性能表现上的优势。
语音与头部姿态的相关性分析
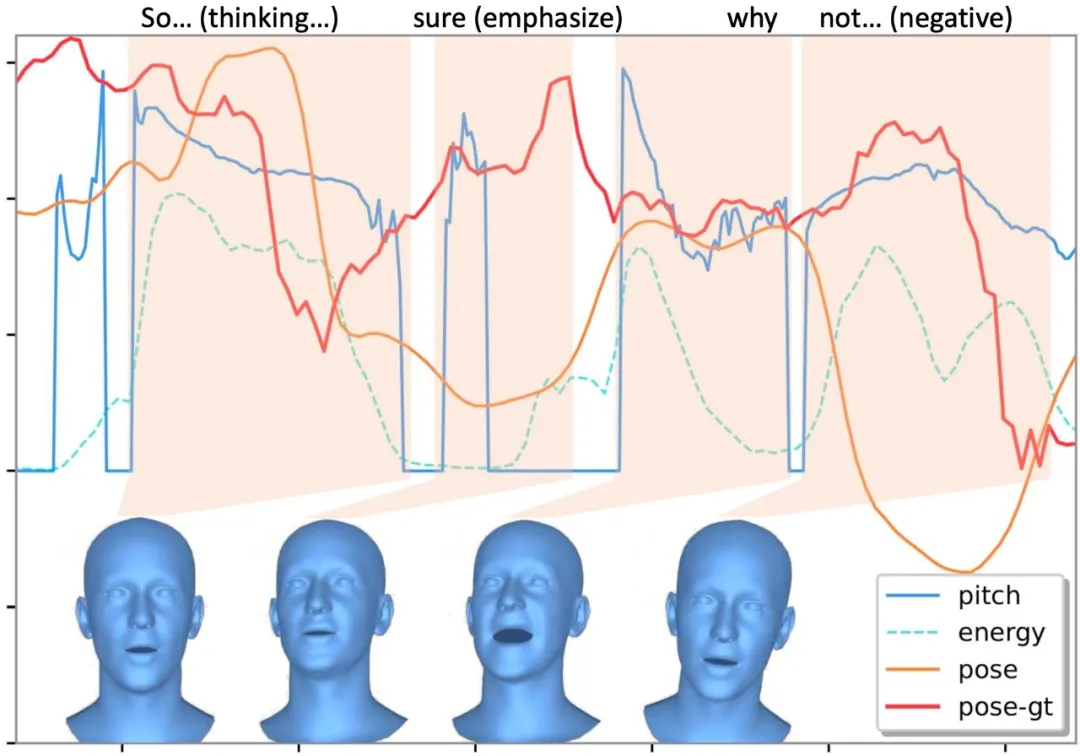
由于头部动作本身较为细微,特别是在以网格平面图的形式表示时,其语义相关性难以直观观察。因此,上图绘制了语音特征与头部姿态的曲线变化。尽管由于语音与头部姿态之间存在一对多映射,预测的头部姿态与真实姿态在绝对值上存在差异,但可以观察到:头部姿态的显著变化通常伴随着语音中的音高和能量的波动,这代表了强调或情绪的变化,表明两者之间存在正相关关系。
当语音内容包含强调或否定等语义特征时,头部姿态会发生明显变化,进一步说明生成的头部姿态包含一定的语义信息。无论是在预测的头部姿态还是真实头部姿态中,说话过程中关键字的姿态曲线均有明显起伏,验证了所生成姿态对参考风格的成功复现。此外,尽管训练数据中存在不稳定的头部抖动,本文的方法仍能够生成平稳的头部姿态。这得益于在大规模数据集上训练的VQ-VAE,有效过滤了这些不稳定的抖动现象,该效果也得到了用户研究的验证。
头部姿态风格的可视化分析
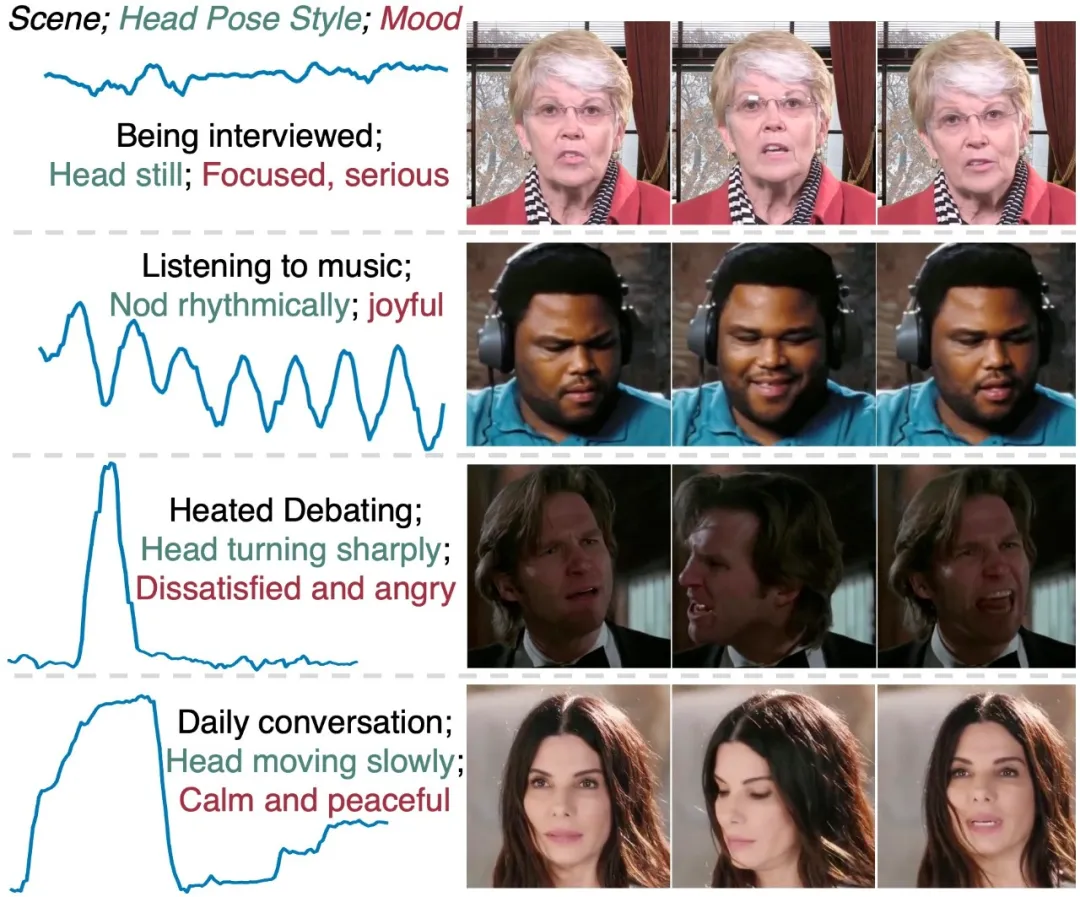
上图通过对姿态风格矩阵进行聚类,可视化了部分聚类中心以及离群样本。结果表明,不同个体之间存在显著的头部姿态风格差异。通过观察对应的真实视频与音频,本文发现头部姿态风格受到多种因素的影响,包括说话者所处的场景、个性特征以及当下的情绪状态。上述现象验证了对头部姿态风格进行有针对性建模的合理性与必要性。
不同拓扑结构比较
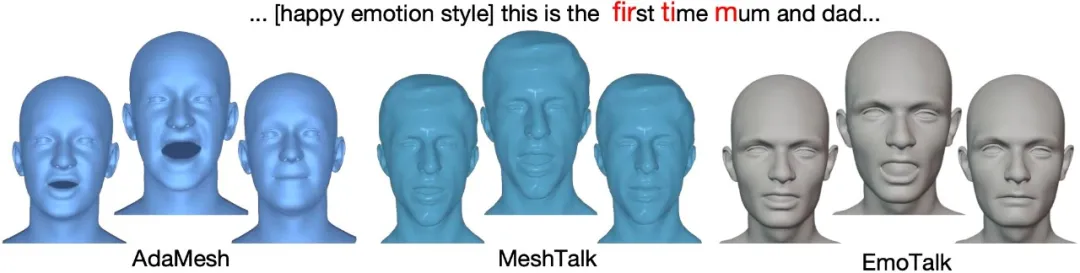
与其他拓扑结构的方法比较:上图将AdaMesh与其他采用不同拓扑结构的方法MeshTalk和EmoTalk进行了比较,这些方法难以直接转换为FLAME格式。AdaMesh 在唇形同步和面部表情丰富性方面表现出更优异的性能。
肖像级真实感的对口型人脸生成

上图进一步展示了所提方法可以通过一个简单的基于条件GAN的特定人物图像渲染器,生成连贯的真实感视频。面部表情与头部姿态由本文提出的AdaMesh预测得到。随后,图像渲染器以二维网格平面序列和身份图像序列为输入,合成匹配网格序列表情细节与身份外观的肖像视频。本文还将结果与最新的对口型人脸生成方法EMO进行了比较。AdaMesh实现了与EMO相当的唇形同步性能,这表明所提方法在面部表情预测方面具有足够的准确性,同时也可以作为生成真实感虚拟人头像的有效手段。
6、结论
本文提出了一种用于语音驱动的三维人脸动画生成方法AdaMesh,其目标是从给定的参考视频中捕捉个性化的说话风格,从而生成丰富的面部表情和多样的头部姿态动作。所提出方法的核心思想是:针对面部表情和头部姿态的不同数据特性,分别设计适配策略。针对面部表情提出的MoLoRA策略,以及针对头部姿态的检索式适配策略,均与各自模态的数据特性相契合。所提出的方法在数据有限的微调场景下,有效解决了面部表情建模中的灾难性遗忘与过拟合问题,以及头部姿态建模中平均化生成的问题。大量实验结果和方法分析表明,AdaMesh实现了高质量且高效的风格微调迁移,并优于现有的多种先进方法。
