
 语音小管家
本文介绍清华大学人机语音交互实验室(THUHCSI)在会上发表的第1篇论文:Speechcraft:大规模自然语言细粒度描述的表现力语音数据集。
文本-语音多模态学习任务(Speech-language Multimodal Learning)中,语音风格所包含的多样音韵信息及副语言信息为跨模态对齐带来了重大挑战。为此,亟需大规模、高质量的语音风格数据集。本文提出了一种自动语音标注系统,通过多维度专业分类器和描述模型提取语音特征,并利用LLM生成富有表现力和生动的人类语言描述的注释。与传统的标签或模板方法相比,该系统提供了更深入的语音风格理解,并支持大规模高质量的数据生成。基于此系统,我们构建了SpeechCraft数据集,包含约2000小时音频和其对应的逾两百万条语音标注,具有细粒度的描述内容和多样化的表达方式。实验结果表明,SpeechCraft显著提升了风格化语音可控合成和语音风格理解任务的性能。
代码和模型开源及结果展示:https://github.com/thuhcsi/SpeechCraft
背景介绍
随着对多模态大模型的探究兴起,端到端语音大模型在语音合成和理解等方面取得了显著进展。然而,现有研究主要集中在基本的语音特征对齐关系,如语音合成的可懂度和声音事件的分类上,而对语音风格的细微差别探索不足,从而限制了语音合成模型的细粒度可控能力及语音对话模型的意图理解能力。现有的文本到语音(TTS)系统缺乏对语音风格的精确、灵活控制,而现有的语音理解系统则难以捕捉到语音表现力的细微差别。
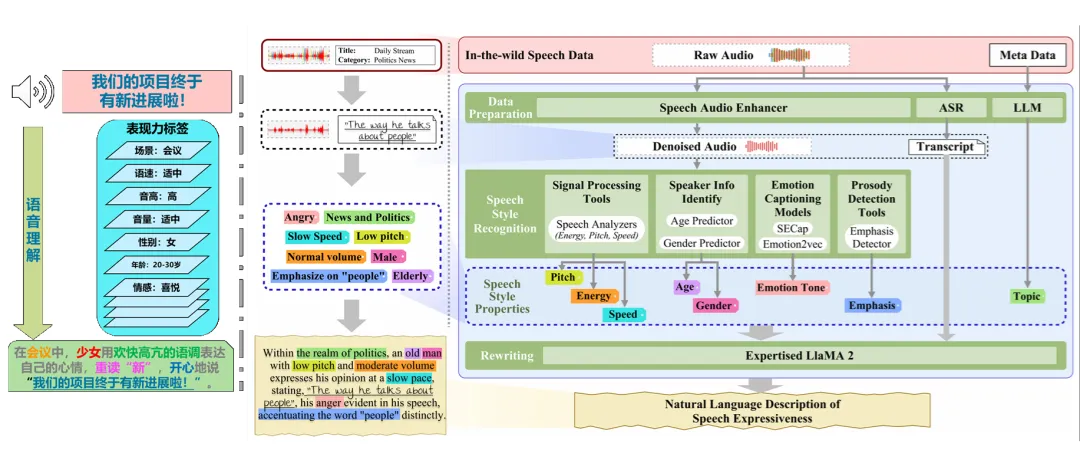
语音风格不仅包括音色、语调,还包括说话者的身份、情感、语境上下文和谈话主题等信息。由于现存开源的语音风格描述数据较少,且除了常见的语音全局分类属性,缺乏对语音丰富细节的细粒度刻画。因此,我们提出了一种自动语音标注系统,对in-the-wild语音片段进行富有表现力的人类语言描述的注释。该系统首次在描述风格时引入了对语句重音、情感语气、文稿内容等方面的关注,利用专家模型从原始音频中对多维度语音属性进行表述,并利用LLM将各种属性整合成兼具全局及局部语音信息的描述解读。与以往基于标签或模板的标注框架不同,我们的系统对音频进行逐句定制化的自然语言描述转写,从而提供了对语音风格的深入理解,为多模态大模型训练解锁了大量高质量数据。
自动语音风格标注系统
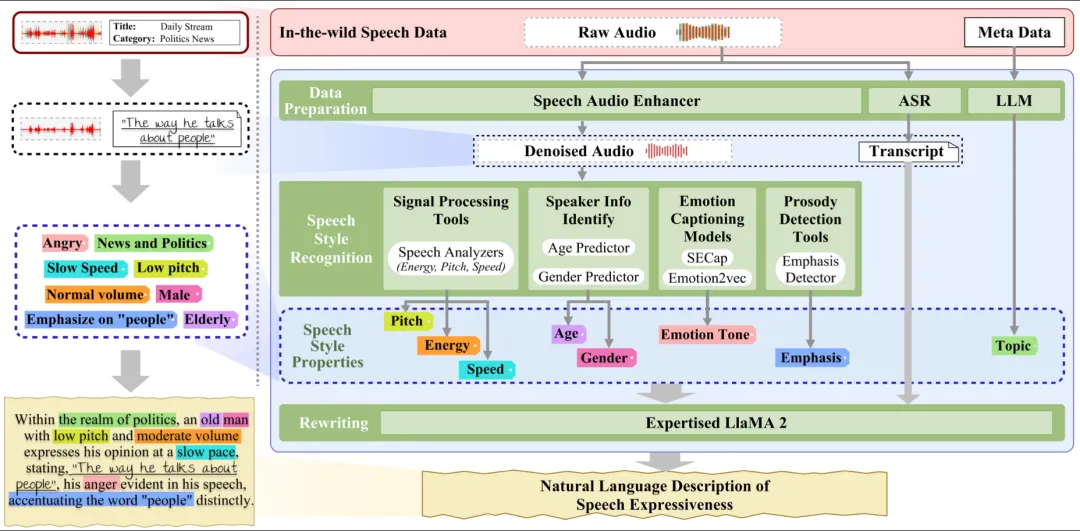
本文所提出的自动语音风格标注系统包括数据准备、属性提取和LLM转写三个阶段。我们首先对多来源的原始音频数据进行去躁、切分、语音识别等标准预处理,以提高数据质量,同时利用音视频来源的网络标签等原始属性建立标准元数据,并归纳出音频所谈论的话题。其后,我们使用各种音频特征提取模型来表征语音的风格属性,并利用大语言模型的能力,将检测到的语音属性转换为自然语言描述。
该系统的主要特点可以总结为细粒度性、多样性、指令性。
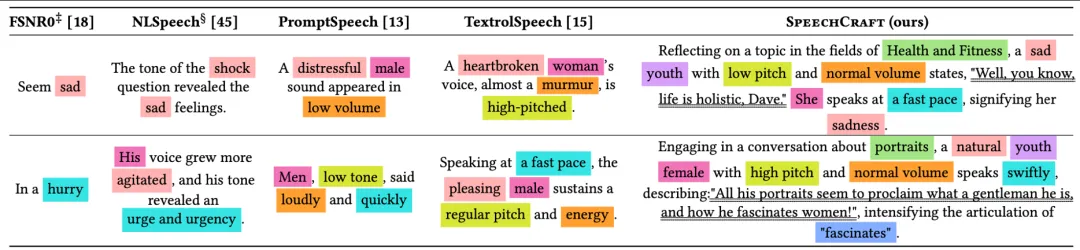
细粒度性(Fine-grained)主要体现在标注系统对全局与细节属性的兼顾及对情感语气基调的精准捕捉。该系统的语音风格识别不仅关注语音的全局属性,如性别、语速、音量等,还深入挖掘细节属性,例如重音强调、句内音高变化等。全面捕捉逐条语音的独特风格特征,为后续的自然语言描述提供丰富而精准的信息。同时,系统通过先进的语音情感描述技术,如SECap模型,对情感基调采用自然语句描述而非传统single-word情感标签的方式,使得生成的语音描述能够真实反映说话者的情感状态,增强描述的多样性并减少信息损失。
多样性(Diversity)指的是该系统的标注过程专注于破除模板化描述,并丰富所生成描述的词汇与句式。传统的语音标注往往针对有限、固定的标签组合采用LLM批量生成预定义的模板,在大规模数据标注时损失了语音的特异性。我们摒弃了模板化的方式,利用LLM强大的语言生成能力,为每个音频片段生成定制化的自然语言描述,避免了重复的标注结果。微调LLM时,我们通过同义词替换、句式重组、多轮中英互译等数据增强方法,使得描述文本在表达同一属性时能够呈现出不同的语言风格,进一步提升了描述的多样性,使其更贴近人类自然语言的表达习惯。
指令性(Instruction-Style)即指提供了语音风格和内容的统一指令形式,将说话内容(Transcription)融入语音风格描述,形成整体控制指令。以往的可控语音合成模型在处理文本和描述时,往往采用分开的通道,导致难以建模文本不同部分之间的细粒度风格差异。而我们所提出的标注系统通过将文本融入在描述中,使模型能够更好地理解语音内容与细粒度风格之间的关联,实现对语音合成过程中全局与细节风格的统一控制,提升了语音合成的精准度和表现力。更进一步,这种统一的构建形式不仅适用于语音指令数据集,还能够方便地扩展到音频指令数据集,为未来描述声音事件、语音内容和场景氛围等更广泛的音频信息提供了基础,增强了系统的可扩展性和适用性。
大规模双语语音描述数据集
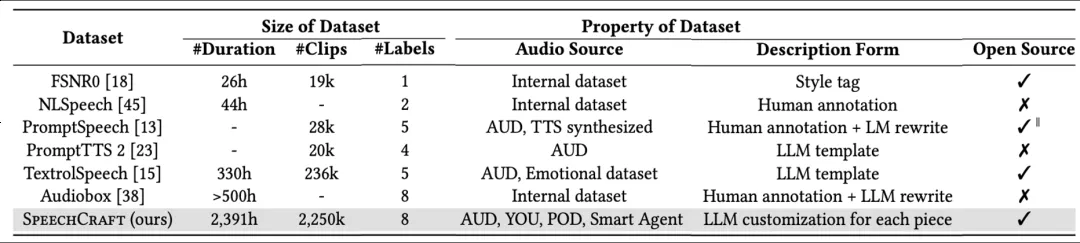
将上述语音标注系统应用于高质量双语语音合成数据集,我们创建了一个大规模的开源语音风格数据集SpeechCraft,它包含了大约2000小时的音频数据和超过两百万条的语音描述。
数据来源
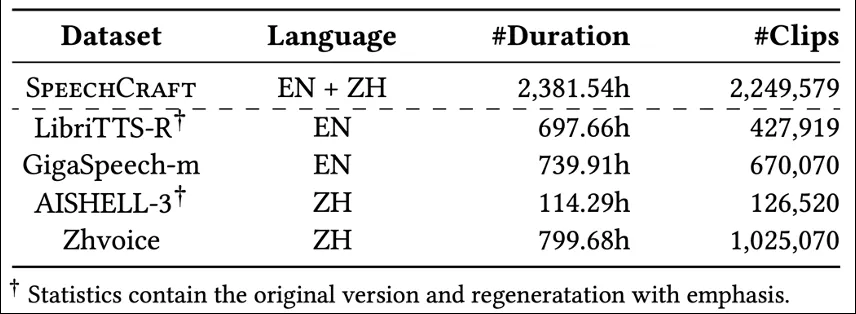
SpeechCraft数据集基于四个流行的双语语音合成数据集构建,包括AISHELL-3、Zhvoice、LibriTTS-R和GigaSpeech-m。这些数据集涵盖了不同的语音场景、说话者特征和情感表达,为SpeechCraft提供了丰富多样的语音样本。同时,针对无开源数据的重音识别及可控合成任务,我们提出了一种基于FastSpeech2和关键词抽取的重音数据合成方法,对AISHELL-3和LibriTTS-R这两套中英数据进行重音嵌入,为后续细粒度可控生成及意图检测工作提供了新的数据支持。
数据分析
以下图表共同展示了SpeechCraft数据集的多样性和平衡性,以及标注系统在生成高质量、细粒度语音描述方面的有效性。
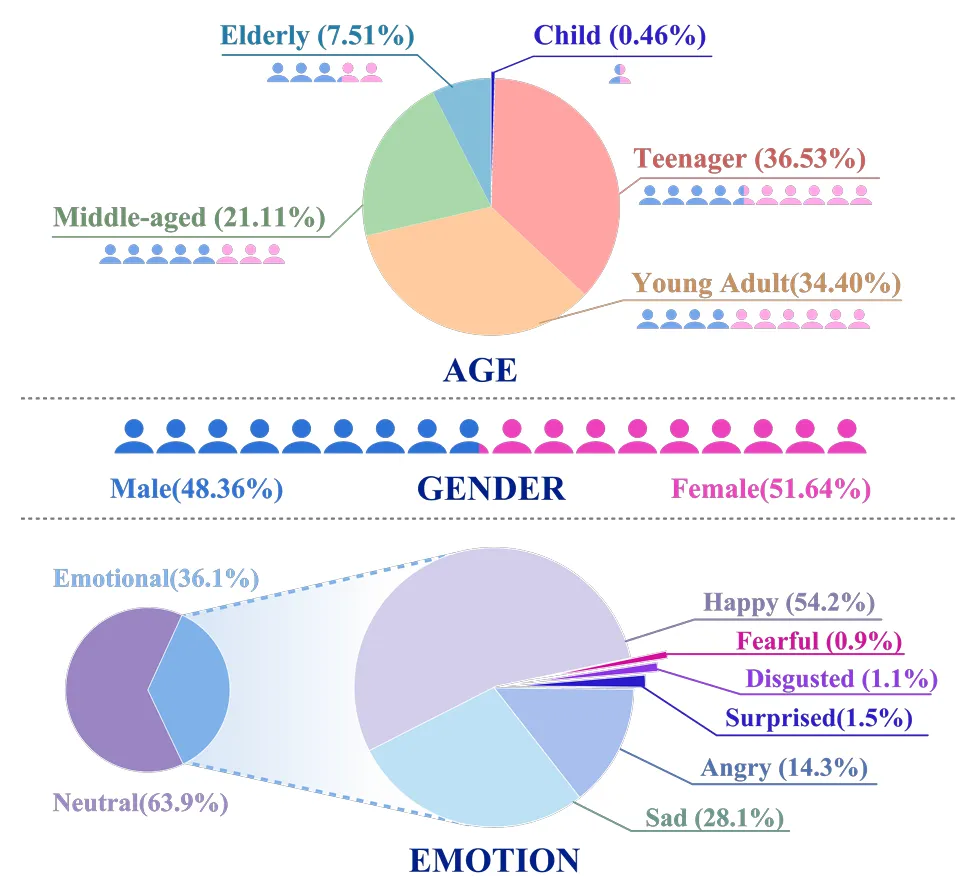
上述饼图展示了SpeechCraft数据集中不同年龄、性别和情感的分布情况。数据集在性别上相对平衡。由于我们直接采用了高质量TTS数据,其主要为有声书录制、社交媒体及视频网站爬取的音视频,故在年龄-儿童、情感-害怕/恶心等样本类别中存在不均衡现象,与数据来源的音频特征分布呈现一致的表现。
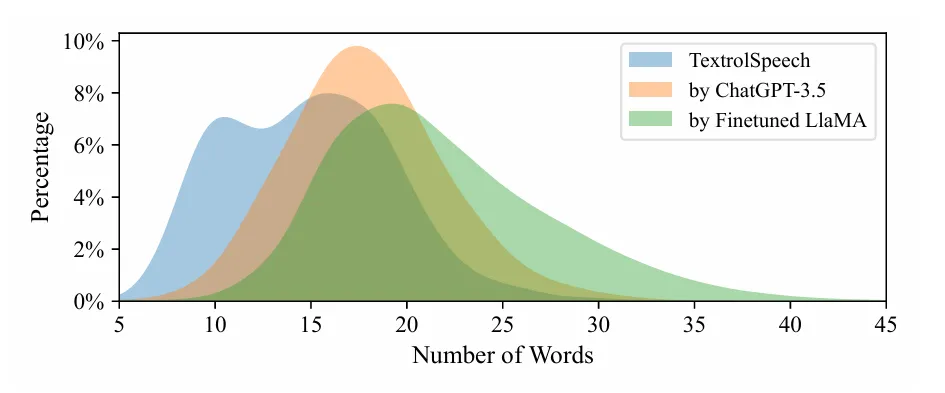
以上句长分布图展示了三种语音描述句长的分布情况。句长间接反映了描述的详细程度和信息量。本文所使用的微调后的LLM所生成的描述句子长度分布情况与ChatGPT-3.5和TextrolSpeech相比存在右移,意味着它提供了更丰富的信息。
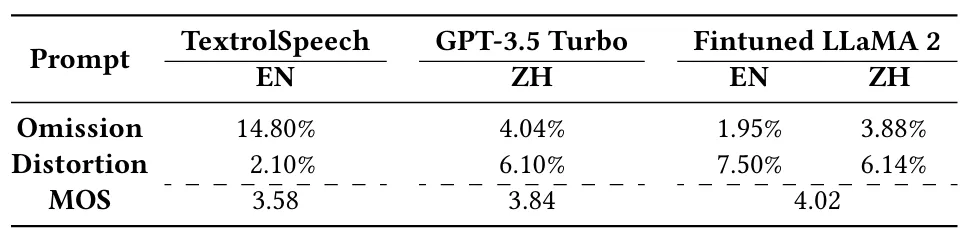
同时,如上表所示,比较三者的遗漏(Omission,指模型在生成描述时未涵盖的原始标签信息)、失真(Distortion,指模型在生成描述时改变了原始标签信息)和平均意见得分(MOS)可知,本文所使用的经微调的LLM能够准确的保留输入的原始信息,同时具备更与人类价值观对齐的综合转写质量。
实验验证
我们在三项语音-文本相关的下游任务上进行实验,以验证SpeechCraft数据集的有效性以及其对语音-语言多模态学习任务性能的提升,主要包括:表现力语音合成中的风格控制能力、重音合成的细粒度控制能力、及自动文字描述系统(Captioning Model)在描述声学属性和说话者身份等方面更广泛的风格理解能力。
表现力语音合成
我们使用SpeechCraft数据集中来训练两个文本到语音(TTS)模型:Salle和ParlerTTS,与使用TextrolSpeech数据集训练的模型进行比较分析。评测指标包括风格属性的召回准确率、音频质量MCD(Mel-Cepstral Distortion)及SECS(Speaker Embedding Cosine Similarity),和主观用户实验。
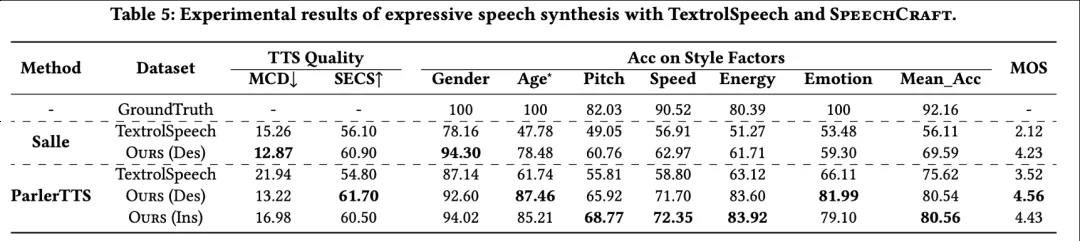
SpeechCraft数据集在提升TTS模型的语音合成质量、风格属性识别准确率以及用户满意度方面表现出了显著的优势。其中,ParlerTTS模型在SpeechCraft数据集上的表现优于Salle模型,尤其是在Instruction版本(描述中含语音转录文稿)的数据上,这表明将文稿与风格描述结合的方法对于提高模型性能是有益的。同时,SpeechCraft数据集的细粒度和多样性对于提高模型在表达性语音合成任务中的表现至关重要。
细粒度重音控制
我们利用合成的重音数据和对应的不同版本细粒度风格指令,比较SpeechCraft数据集的描述版本(Description Version,描述中不含语音转录文稿)和指令版本(Instruction Version,描述中含语音转录文稿)在语音合成中的重音控制效果,探索指令版本的潜在应用。
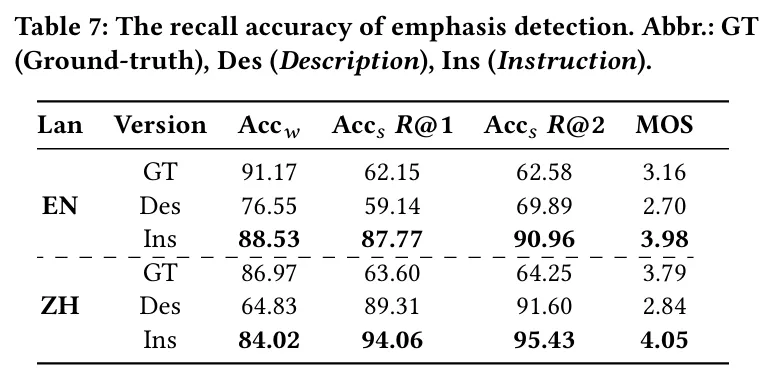
我们首先训练了一个基于深度神经网络与卷积神经网络的重音检测模型,其在合成的中英文重音数据上分别达到了87%和91%的准确率,用以测试SpeechCraft数据集的细粒度重音描述能否激发有效的重音控制效果。评估指标包括词级别重音识别准确率(Accw)和句级别重音识别准确率(Accs)。如上表所示,SpeechCraft的指令版本在两种语言中都显示出了高准确率,尤其是在句子级别上,这表明将文本转录与风格描述结合的方法对于提高细粒度重音控制能力的有效性。
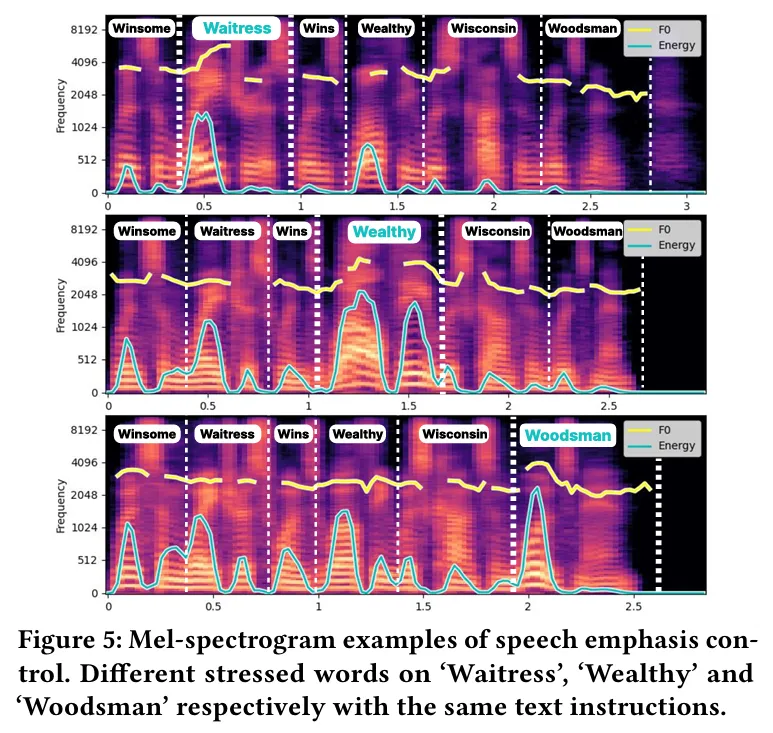
我们还通过案例研究,使用梅尔谱图来可视化指定同一句中不同重音词汇的合成语音效果,直观地展示重音控制能力。如上图所示,其中F0(黄色线条)代表基频(即音高)、Energy(青色线条)代表语音的能量。尽管重音词存在差异,F0的峰值和能量的峰值均对应于强调的词汇,显示出强调的一致性。这种细粒度的控制能够提高语音合成的自然性和表现力,对于创建更加丰富和真实的语音交互体验至关重要。
端到端语音风格描述
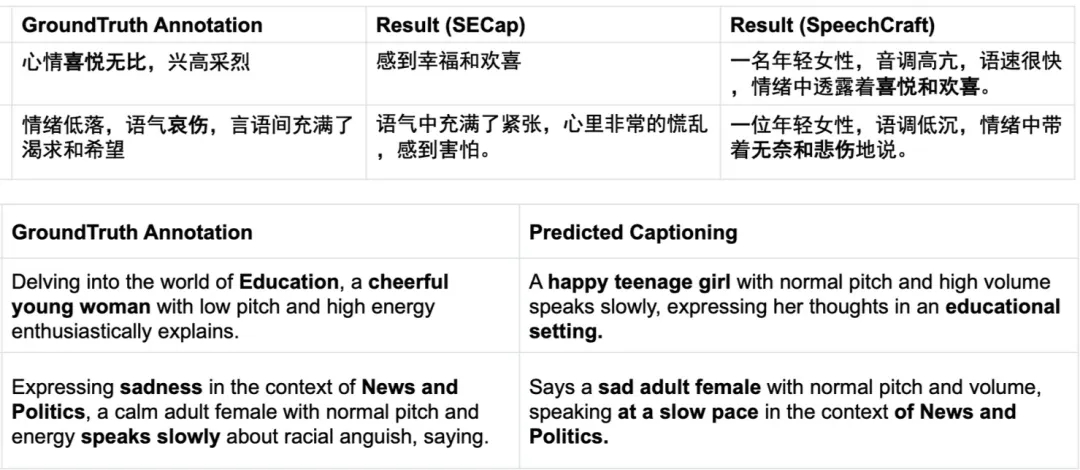
为了验证SpeechCraft数据集对端到端语音风格理解模型的性能提升,我们复现了目前最新的的情感描述模型SECap,并在SpeechCraft的Description版本上进行重新训练。我们的模型实现了对整体语音风格的连贯描述,并在MOS指标上略优于SECap版本的纯情感描述(3.79 vs 3.58)。更多样例请访问我们的Demo页面。
结论
在本文中,我们提出了一个自动语音风格标注系统,采用精细的语音风格识别和LLM转写,为in-the-wild音频形成细粒度且定制化的语音描述。此外,我们创建了大规模开源双语表现力语音数据集SpeechCraft,为多模态大模型训练提供了高质量数据基础。实验表明,我们的数据集在提升文本到语音(TTS)和语音到文本(SST)模型性能方面表现出色。它增强了表现力语音合成中的细粒度风格控制能力,并首次实现了端到端全局语音风格理解。
