
 语音小管家
异常声音检测(Anomalous Sound Detection,ASD)是指在仅知道机器正常工作声音的前提下,判断待测机器声音是否存在异常。近期,清华大学联合上海交通大学、华北电力大学等单位,提出了一种面向工况属性信息不完备场景的自适应原型学习异常声音检测方法,有效提升了工况缺失和域迁移场景下的ASD检测效果。该论文已发表于ICASSP 2025。
A. Jiang, X. Zheng, B. Han, Y. Qiu, P. Fan, W.-Q. Zhang, L. Cheng, and J. Liu, “Adaptive prototype learning for anomalous sound detection with partially known attributes,” inProc. IEEE International Conference on Acoustics, Speech, and Signal Processing (ICASSP), 2025.
doi: 10.1109/ICASSP49660.2025.10889514.
背景介绍
机器运行的声音中往往隐藏着设备故障的蛛丝马迹,可使用AI技术对声音进行分析,实现设备的不间断监控与故障的实时报警。然而特殊场景下,设备的故障数据非常稀缺,往往只能用于评估模型而不能用于训练模型,否则会出现过拟合。基于以上需求,异常声音检测(Anomalous Sound Detection,ASD)技术应运而生。ASD技术是指在仅知道机器正常工作声音的前提下,判断待测机器声音是否存在异常,即训练集只包含正常声音,不包含任何异常声音。由于不需要异常数据用于训练,ASD技术特别适合大型设备运维、早期故障识别等异常数据稀缺的场景。
ASD模型通常包含两部分:特征提取器和异常检测器。特征提取器采用深度神经网络提取声音表征,而异常检测器采用KNN等统计学方法进行异常检测。其中声音表征的质量最为关键,本文称这些声音表征为原型。为提升原型的质量,最好的ASD模型往往采用自监督预训练的音频模型初始化特征提取器,并采用机器的工况属性标签(例如机器类型、转速、设备编号等)微调特征提取器,由此得到的原型既保留了预训练的泛化能力,又适配了机器声音的独有特征。因此,工况属性标签的质量很大程度上影响了原型的质量。
然而工况属性标签的质量往往参差不齐。
部分机器工况缺失。本文称缺失工况的机器为粗粒度机器,而有具体工况的机器为细粒度机器。打标签时,粗粒度机器只能被映射为一个类内差异大的类,而细粒度机器则会被映射为多个类内差异小的类,出现了标签语义不对齐的问题。在训练时,粗粒度机器的原型会被压缩为机器共有的特征,而丢弃了与工况相关的高层语义信息。这些语义信息对于区分正常异常至关重要,丢弃它们会大幅降低原型的区分能力。
工况存在域迁移。部分工况运行时间长、数据多,本文称为源域;另一部分工况运行时间段、数据少,本文称为目标域。源域的数据量往往远大于目标域的数据量,导致ASD模型对目标域数据的适配效果差。
工作原理
针对以上问题,本文提出了一种自适应原型学习方法。
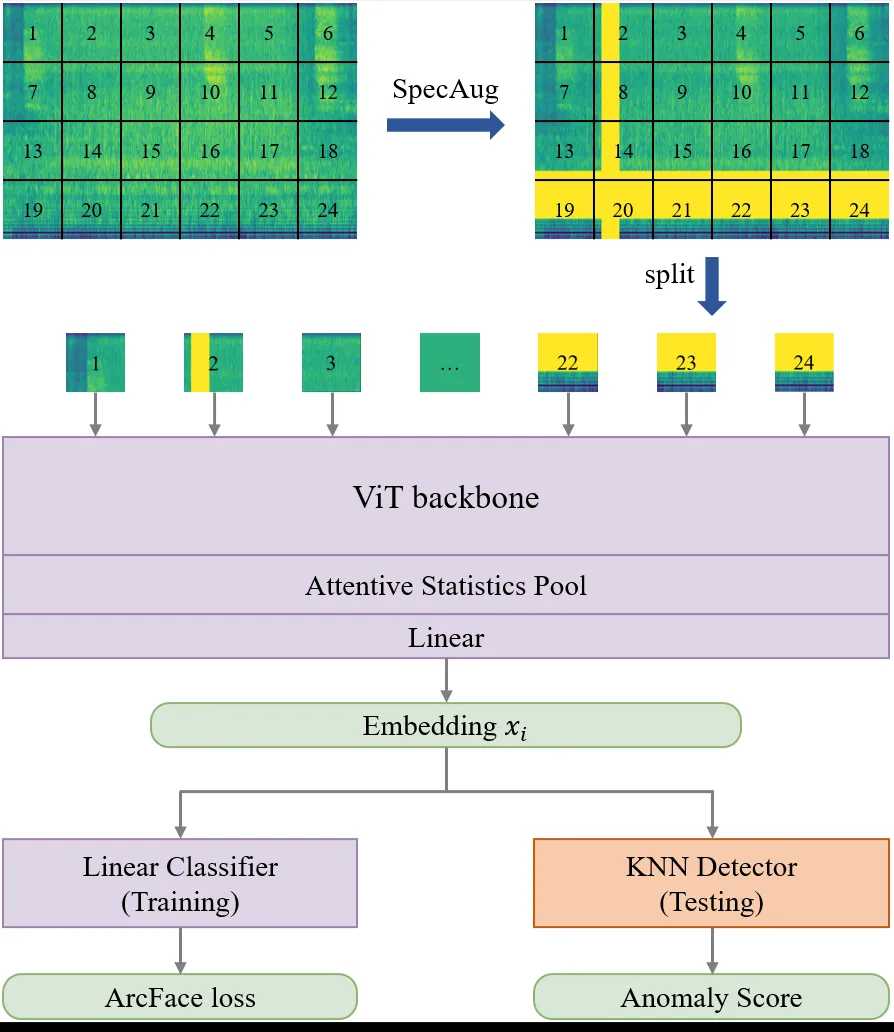
本文采用研究团队提出的AnoPatch模型构建初始ASD模型,并在其上开发了自适应原型学习方法。AnoPatch模型的特征提取器采用ViT-Base,网络参数使用BEATs初始化。异常检测器为2个KNN检测器,分别处理源域和目标域,最终异常分数为二者分值更小的。
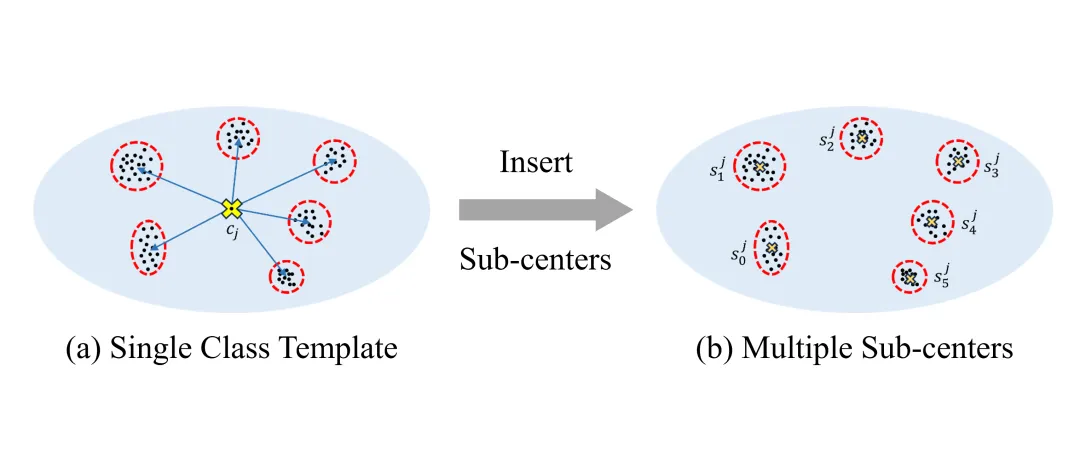
针对工况缺失问题,本文向每个粗粒度机器的原型空间插入了n个可学习的子中心,每个子中心代表一个隐藏的工况。训练采用ArcFace损失,该损失函数通过压缩原型与类模板的夹角实现更好的分类效果,其中类模板为线性分类头的对应行向量。在训练时,对于粗粒度机器,首先把特征提取器输出的原型映射到最近邻的子中心,再将该子中心作为类模板。而细粒度机器则根据工况选择对应的类模板,与正常流程一致。最后再将原型与更新后的类模板一起送入ArcFace损失。
针对工况域迁移问题,本文使用SMOTE算法对目标域的原型进行上采样。SMOTE算法是一种基于KNN的插值方法,通过设置采样比例可以保证其鲁棒性。上采样后的目标域原型再用于构建目标域KNN检测器。后续检测流程与AnoPatch相同。
实验结果
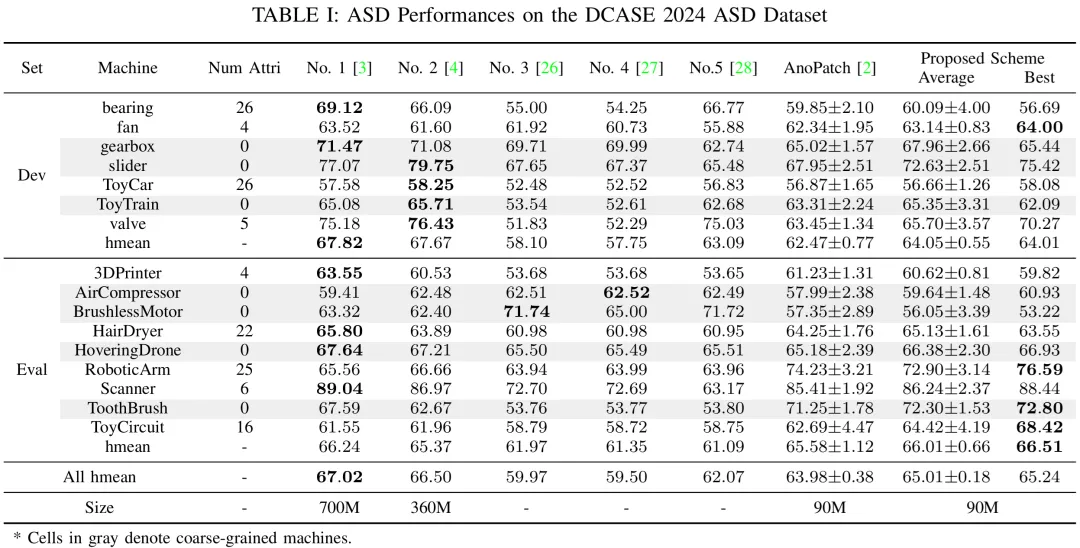
在DCASE 2024 竞赛任务二的开发集和评估集上,所提出的方法取得了65.01%的平均准确率,相比于AnoPatch模型提升了1.03%。与DCASE竞赛提交的系统相比,本方法大幅领先于第3名达5.04%,仅低于第1名和第2名(均为研究团队的工作)。而前两名均为融合系统,参数量分别为700M和360M,本方法仅使用90M参数,推理效率更高。
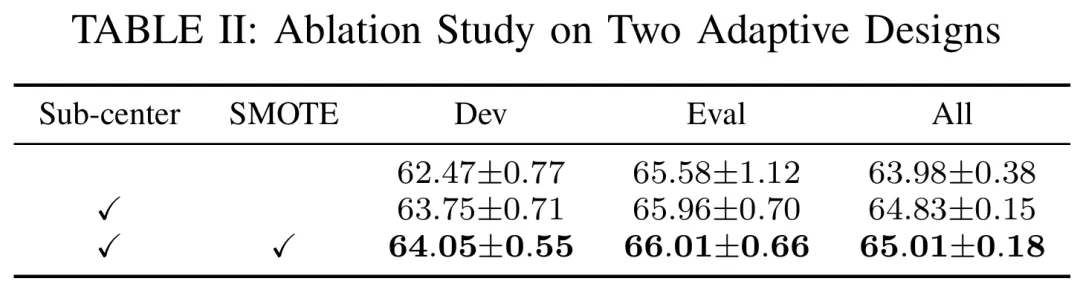
为验证所提方法的有效性,研究团队进一步进行了消融实验。首先,为验证两步自适应学习方法均有效果,本文在AnoPatch的基础上,逐步加入两种自适应学习方法。引入可学习子中心后,检测结果从63.98%提升到64.83%;而继续引入SMOTE上采样后,检测结果进一步提升到65.01%。两步自适应学习方法均有效提升ASD性能。
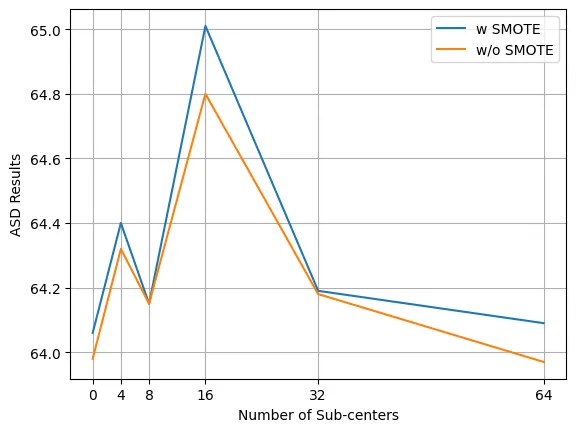
其次,本文对比了检测效果随子中心个数的变化。当子中心数为16时,检测效果最好。值得注意的是,所有细粒度机器的平均工况数为14.88,最优子中心数为16说明每个子中心能对应到一个隐含的工况。
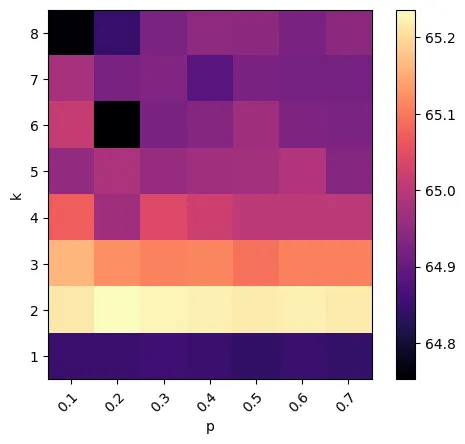
最后,本文对比了SMOTE参数对检测效果的影响。上图中,横轴为上采样的比例,纵轴为KNN的k取值,热力图颜色越浅表示效果越好。由图可知,当k=2时检测效果出现了稳定提升。而不加SMOTE上采样时的检测结果是64.83%,上图中绝大多数参数组合都优于该值,说明SMOTE上采样方法鲁棒性较好。
针对ASD场景下缺失工况和域迁移问题,本文提出了两步自适应原型学习方法。针对缺失工况问题,本文向粗粒度机器插入可学习的子中心,用这些子中心拟合隐含的工况类模板。针对域迁移问题,本文使用SMOTE对目标域原型进行上采样。所提出的方法在DCASE 2024数据集上取得了1.03%的提升,消融实验也证明了两步自适应学习的有效性与鲁棒性。
学生作者信息
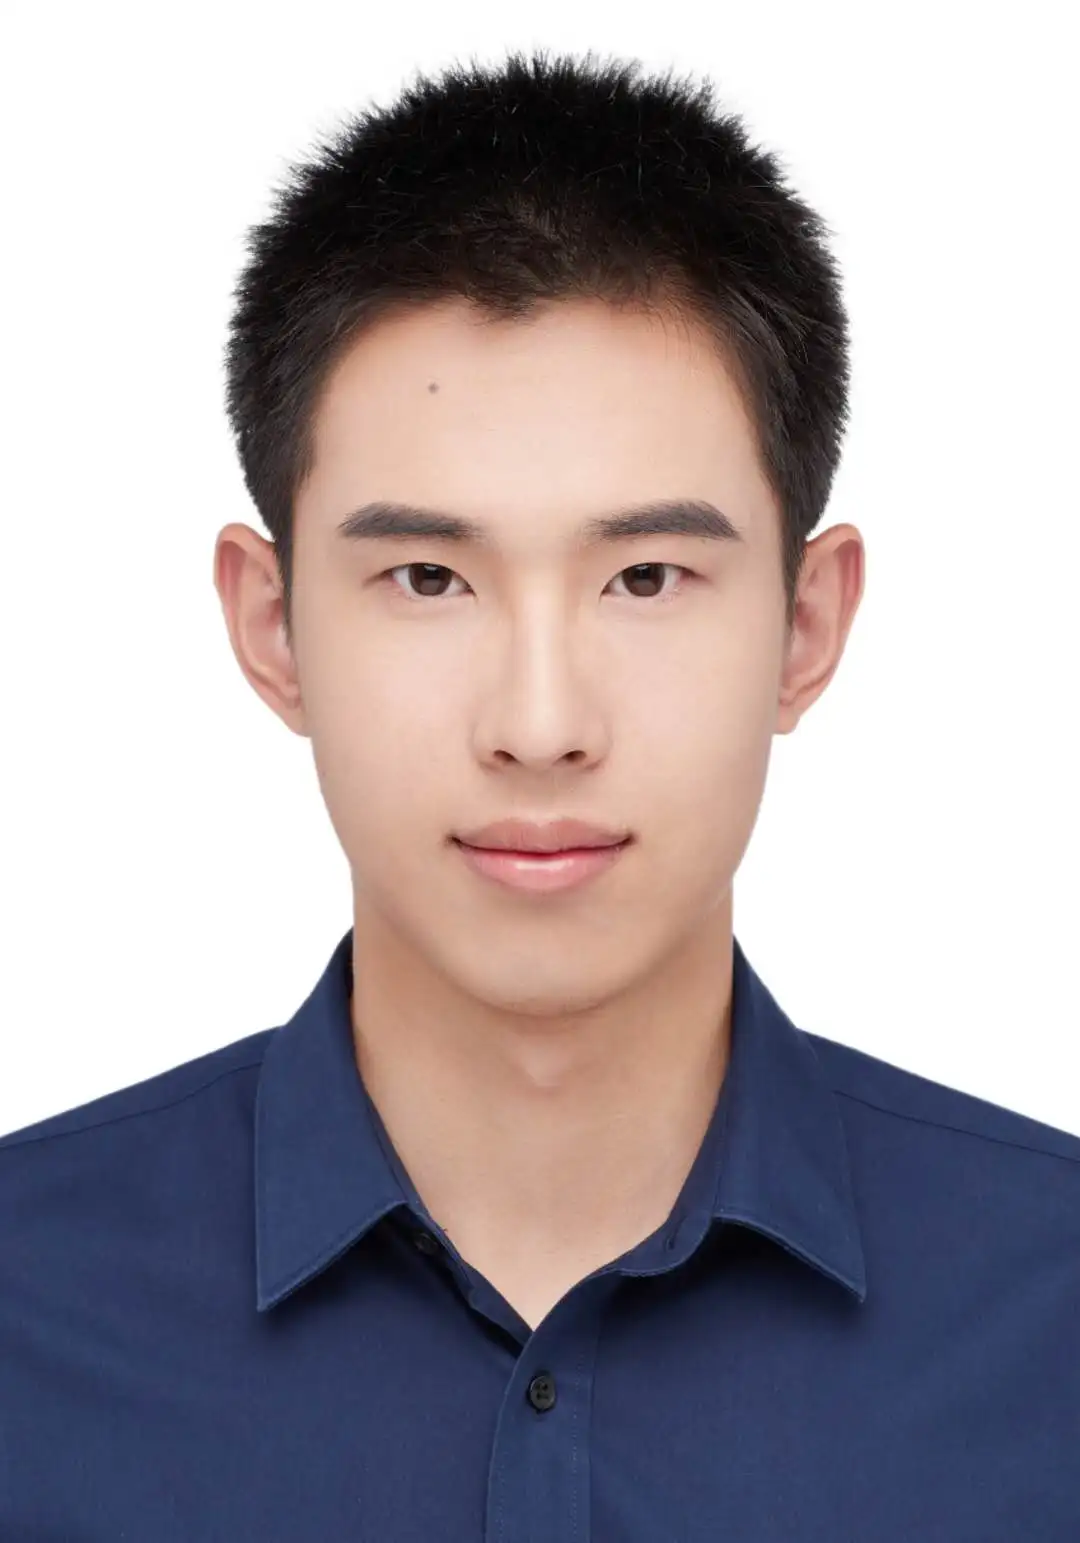
姜安柏,清华大学电子系三年级博士生,研究方向为异常声音检测和音频信号处理。
