
 语音小管家
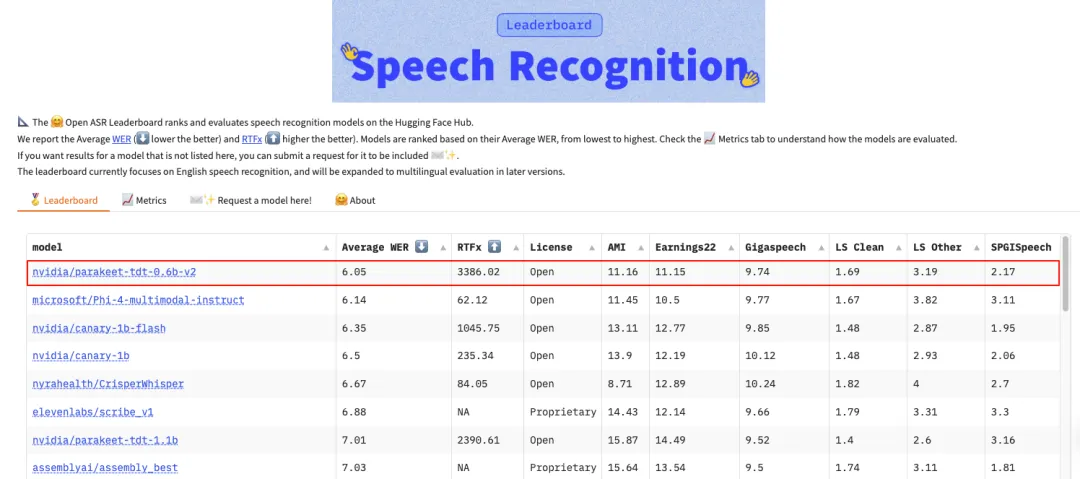
英伟达在5月1日发布了一款开源语音识别模型:Parakeet TDT 0.6B V2,其以 600M 参数登顶 Hugging Face Open ASR 榜单。
项目链接:https://huggingface.co/nvidia/parakeet-tdt-0.6b-v2
平均词错误率(WER)仅 6.05%,超越所有主流闭源模型。它能在 1 秒内转录 60 分钟高质量音频。
基于 FastConformer 架构和 TDT 解码器,仅用 600M 参数实现超低 WER 和极快推理速度。训练数据为 12 万小时 Granary 数据集(含 LibriSpeech、Common Voice 等)。
CC-BY-4.0 许可允许商业和非商业使用!
核心优势
极致转录效率:60 分钟音频仅需 1 秒内完成转录(A100 推理)
OpenASR 榜首表现:超越 Whisper、Conformer、Wav2Vec 等主流闭源模型
极小参数量:仅 0.6B(轻量级,适合边缘设备)
高精度:平均 WER 6.05%(Hugging Face Open ASR 榜单),优于 Whisper-large-v3
高鲁棒性:多语速、多口音、多录音环境下表现稳定(英文)
技术原理与架构深度解析
Parakeet-TDT-0.6B-V2之所以能在语音识别任务中表现出色,源于其创新的模型架构设计和精妙的实现细节。本节将从模型架构、训练方法和优化技术三个层面,全面解析Parakeet-TDT-0.6B-V2的技术内涵。
混合架构设计是Parakeet-TDT-0.6B-V2的核心创新之一。该模型创造性地结合了FastConformer编码器和TDT(token and duration transducer)解码器,形成了兼具高效性和表达力的识别框架。FastConformer是对标准Transformer架构的优化版本,通过改进注意力机制和层次结构,在保持强大表征能力的同时显著降低了计算复杂度。具体而言,它采用了分组注意力和卷积增强等技术,使模型能够更高效地处理语音信号这种长时间序列数据。与初代Parakeet使用的RNN Transducer相比,新版基于Transformer的TDT解码器能够更好地捕捉语音序列中的长距离依赖关系,从而提升识别准确率。
多层次特征提取是Parakeet-TDT-0.6B-V2处理语音信号的另一关键。语音信号包含从低级的声学特征到高级的语言语义的多层次信息,有效的识别系统需要兼顾各个层次。模型的编码器部分采用分层结构,底层网络聚焦于局部声学模式(如音素)的识别,而高层网络则关注更大范围的语境和语义理解。这种分层处理方式使模型能够同时把握语音信号的细节特征和整体语境,有效降低了因同音词或发音变异导致的识别错误。此外,模型还引入了动态调整的上下文窗口,根据输入语音的特点自适应地调整关注的上下文范围,进一步提升了处理效率。
在训练策略方面,Parakeet-TDT-0.6B-V2采用了多阶段训练方法,充分利用了120,000小时的Granary数据集。第一阶段使用大规模伪标记数据进行自监督预训练,让模型学习通用的语音表征能力。这一阶段采用了对比预测编码等先进技术,使模型能够从不完全标注的数据中提取有用信息。第二阶段则使用高质量人工标注数据进行有监督微调,精确调整模型的识别能力。特别值得注意的是,训练过程中采用了课程学习策略,先从较简单的语音样本开始,逐步过渡到更具挑战性的样本(如含噪声、口音或专业术语的语音)。这种渐进式的训练方法有助于模型建立稳健的语音理解能力。
数据增强与正则化技术在Parakeet-TDT-0.6B-V2的训练中扮演了重要角色。为了提升模型在各种真实场景下的鲁棒性,训练过程中引入了多种声学扰动,包括背景噪声添加、房间脉冲响应模拟、变速变调等。这些技术有效扩充了训练数据的多样性,使模型能够适应不同的录音环境、设备特性和说话人特点。在模型层面,采用了Dropout、Label Smoothing等正则化技术防止过拟合,确保学习到的特征具有良好泛化性。特别地,针对语音识别中常见的类别不平衡问题(如某些音素出现频率远高于其他音素),训练过程中采用了焦点损失函数,使模型能够更好地学习识别低频但重要的语音单元。
解码与后处理是语音识别系统中影响最终效果的关键环节。Parakeet-TDT-0.6B-V2的TDT解码器采用了联合建模方法,同步处理声学特征和语言模型信息,实现端到端的优化。与传统流水线式系统不同,这种一体化设计能够避免分阶段处理导致的信息损失和误差累积。在推理阶段,模型支持束搜索(beam search)等多种解码策略,开发者可以根据应用场景在识别准确率和响应速度之间进行权衡。后处理环节则整合了标点恢复、大小写规范化等语言理解功能,直接输出符合书写规范的文本。这些设计细节大大减少了后续处理的工作量,提升了端到端用户体验。
硬件感知优化是Parakeet-TDT-0.6B-V2实现高效推理的重要保障。英伟达充分利用了其在GPU加速计算方面的专长,对模型进行了深度优化。通过算子融合、混合精度计算等技术,最大限度提升了计算密度和内存访问效率。模型支持动态批处理,能够自动调整输入批次大小以充分利用GPU计算资源。针对不同系列的英伟达GPU(A100、H100、T4、V100等),提供了专门的优化实现,确保在各种硬件环境下都能发挥最佳性能。这些优化使得Parakeet-TDT-0.6B-V2能够在资源受限的边缘设备上实现实时推理,大大扩展了其应用范围。
从技术演进的角度看,Parakeet-TDT-0.6B-V2代表了语音识别模型设计的新趋势——在保持端到端学习优势的同时,通过架构创新和系统优化实现效率的突破。与纯自回归模型相比,它的并行化程度更高;与纯非自回归模型相比,它的识别准确率更有保障。这种平衡的设计理念,加上英伟达在硬件加速方面的深厚积累,使Parakeet-TDT-0.6B-V2在实际应用中展现出独特的价值。
使用方法
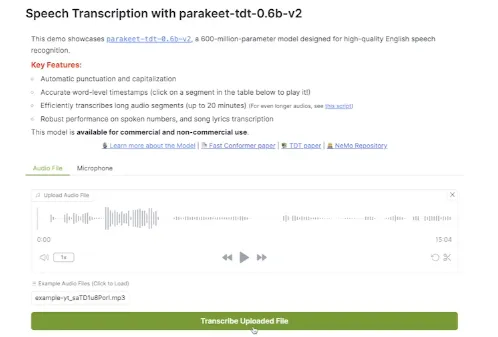
试用地址:https://build.nvidia.com/explore/speech
这个AI模型经过设计和/或优化,可在NVIDIA GPU加速系统上运行。利用 NVIDIA 的硬件(例如GPU 内核)和软件框架(例如 CUDA 库),与仅 CPU 的解决方案相比,该模型实现了更快的训练和推理时间。
如何使用这个模型:
要训练、微调或使用模型,需要安装 NVIDIA NeMo。建议在安装最新的 PyTorch 版本后安装它。
pip install -U nemo_toolkit['asr'] 该模型可用于NeMo工具,可用于预训练的检查点,用于推理或在另一个数据集上进行微调。
自动实例化模型
import nemo.collections.asras nemo_asrasr_model = nemo_asr.models.ASRModel.from_pretrained(model_name="nvidia/parakeet-tdt-0.6b-v2")
支持的GPU架构:
NVIDIA Ampere
NVIDIA Blackwell
NVIDIA Hopper
NVIDIA Volta
