
 语音小管家
随着语音领域生成式人工智能与音频伪造技术的迅猛发展,语音深度伪造(Deepfake),也称为语音反欺骗(Anti-spoofing),已成为信息安全领域的重要挑战。与此同时,基于语音大模型(如wav2vec 2.0 [1]、WavLM [2])的深度鉴伪系统在性能上已远超传统小模型[3]。然而,这些模型输出的高维特征在应用于下游任务时,常常需要通过降维层进行处理。这种降维操作不仅增加了模型参数和计算成本,还可能导致信息损失,影响系统性能。
最近,新加坡国立大学,LIGHTSPEED,新加坡南洋理工大学,Fortemedia,香港理工大学,和香港中文大学(深圳)的联合提出了一种新颖架构——Nes2Net(Nested Res2Net),旨在绕过传统降维路径,直接处理高维特征,提升语音反欺骗系统的性能与效率。我们的方法在CtrSVDD,ASVspoof2021,In-the-Wild,PartialSpoof和ASVspoof 5五个具有代表性的数据集上验证了其优越性,在多个任务上取得目前最佳性能。这五个数据集分别覆盖了歌声伪造(Singing Fake),语音伪造(Fully Spoofed),真实世界数据(Real-world Scenario),部分伪造(Partially Spoofed)和对抗攻击(Adversarial Attack)等多种复杂场景,构成了极具挑战性的测试基准。
论文: Nes2Net: A Lightweight Nested Architecture for Foundation Model Driven Speech Anti-spoofing
作者: 柳天驰, Duc-Tuan Truong, Rohan Kumar Das, Kong Aik Lee,李海洲
论文:
开源代码与预训练模型:
CtrSVDD数据集:
ASVspoof 2019,2021,和In-the-Wild数据集:
ASVspoof5数据集:
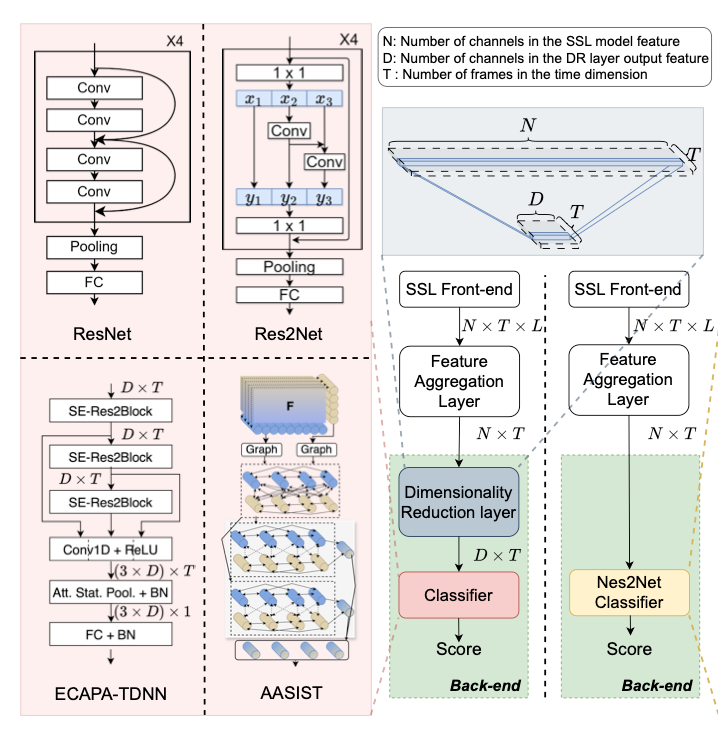
图1:基于语音基座大模型(speech foundation model)的语音反欺骗模型结构
虽然降维可解决维度匹配问题,但如上所述,它也带来了信息损失、计算资源浪费、以及跨任务泛化能力不足等严重问题。
为解决上述问题,我们设计了Nes2Net架构,如图1所示,我们移除了DR层,并通过创新的后端结构来解决维度匹配的问题。
Nes2Net的内部结构如图2所示,该结构是一种轻量级的嵌套架构。该设计可以直接处理高维特征,避免了传统的降维步骤。Nes2Net基于嵌套的Res2Net结构,增强了多尺度特征提取能力,并通过高效的通道注意力机制,提升了特征交互性,保留了丰富的高维信息。
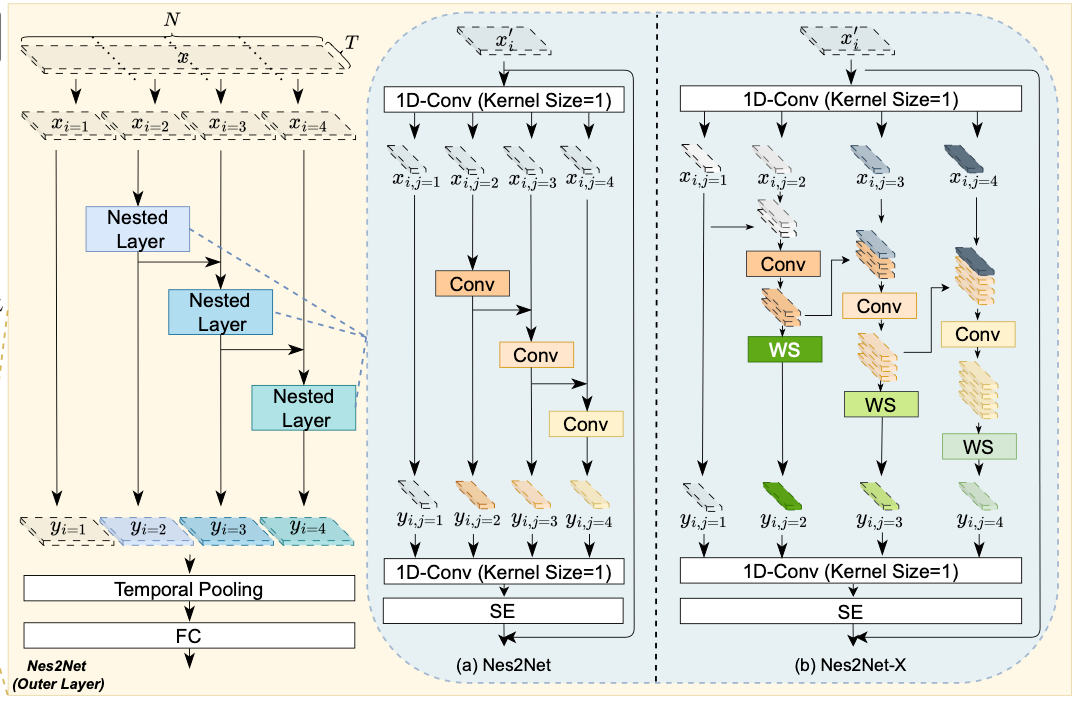
图2:Nes2Net和Nes2Net-X模型结构
此外,我们还提出了Nes2Net的改进版本Nes2Net-X,引入了可学习的加权特征融合机制,实现了更灵活的特征聚合,进一步提升了模型的适应性和性能。
基于CtrSVDD数据集的探索
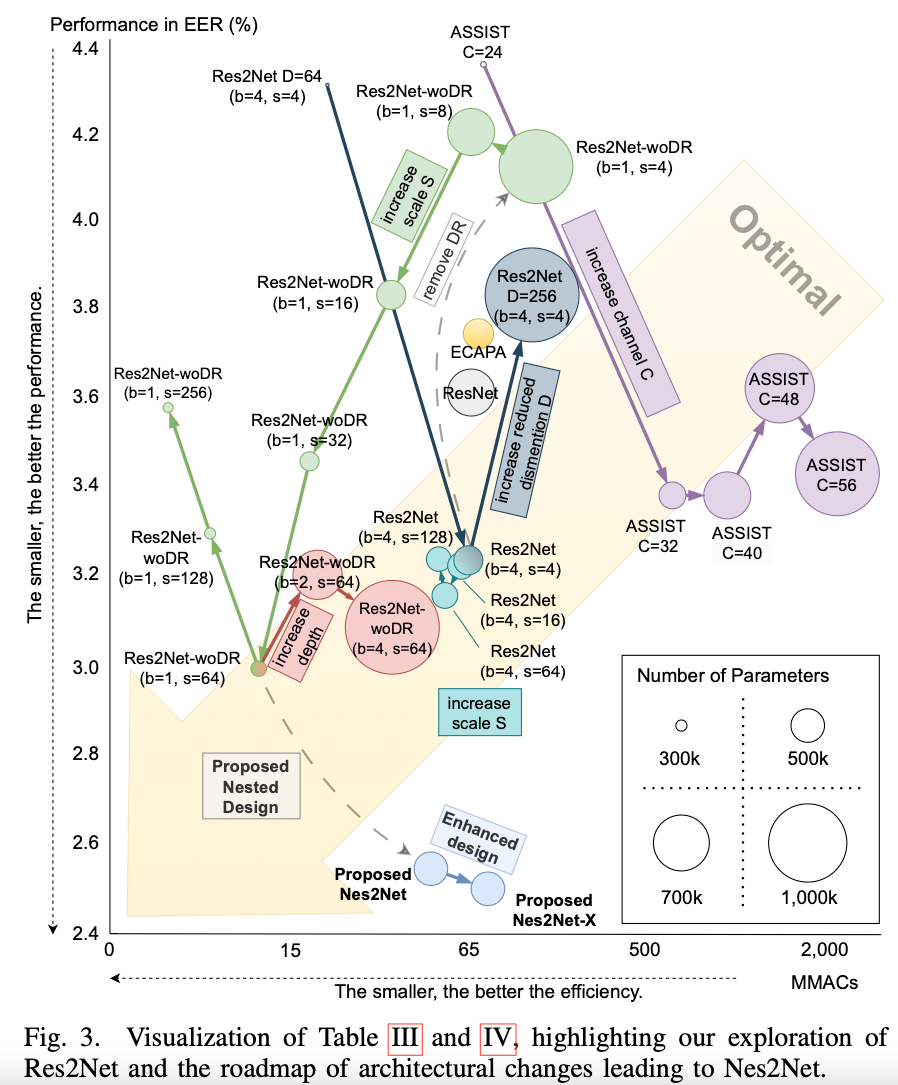
图3:Res2Net架构探索及向Nes2Net演进的路径
我们首先在CtrSVDD数据集上系统的探索了Res2Net结构在模型深度、宽度、分组、降维等维度下的性能变化。结果显示,虽然合理扩展可带来小幅改进,但始终无法突破EER 2.97%的瓶颈。Nes2Net通过结构创新,将EER进一步降低至2.55%。
多任务、多数据集的表现
为进一步验证所提出的 Nes2Net 与 Nes2Net-X 在不同数据集与伪造类型下的鲁棒性与泛化能力,我们在多个具有代表性和挑战性的任务上开展了更全面的实验评估。
1、ASVspoof 2021
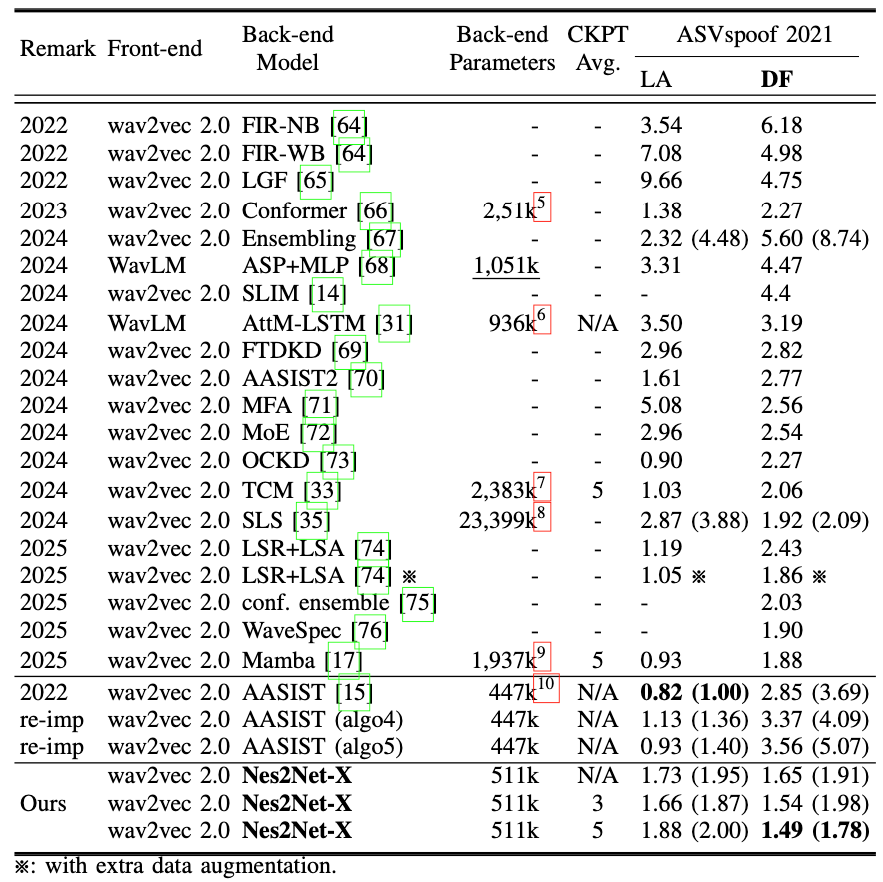
在ASVspoof 2021数据集上,Nes2Net-X在DF任务中表现尤为突出,EER低至1.49%,为当前最优水平。相比同类系统如SLS[4]和Mamba[5]等,Nes2Net-X在参数数量远少的前提下实现了更优性能,展现出卓越的模型效率。
2、In-the-Wild
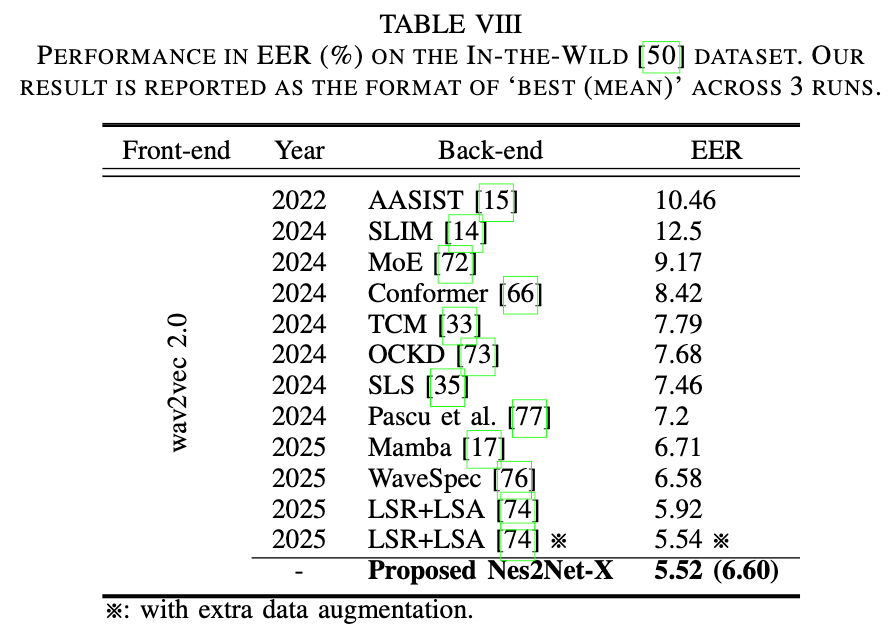
在In-the-Wild数据集上,面对网络上收集的真实深度伪造语音片段,Nes2Net-X同样表现稳定,取得了比当前多个主流模型更低的EER。该数据集包含了真实世界中的多样化干扰因素和伪造方式,是对模型泛化能力的重要考验。
3、PartialSpoof
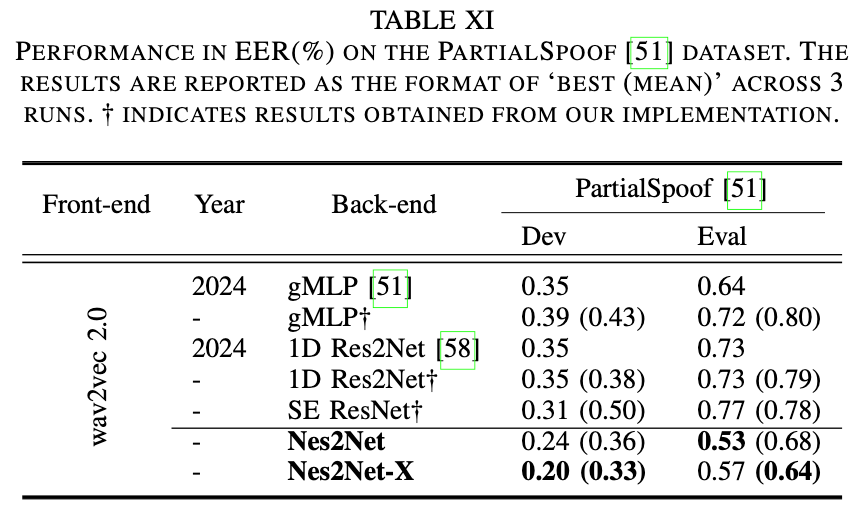
在PartialSpoof数据集中,Nes2Net-X针对“部分伪造语音”任务显示出显著优势。此类任务难度在于只有语音中的部分片段被篡改,对检测器的时序敏感性要求极高。实验结果显示,Nes2Net-X能够有效捕捉和辨别短暂的伪造信号,验证了其多尺度特征提取与注意力机制在精细粒度欺骗检测中的价值。
4、ASVspoof 5
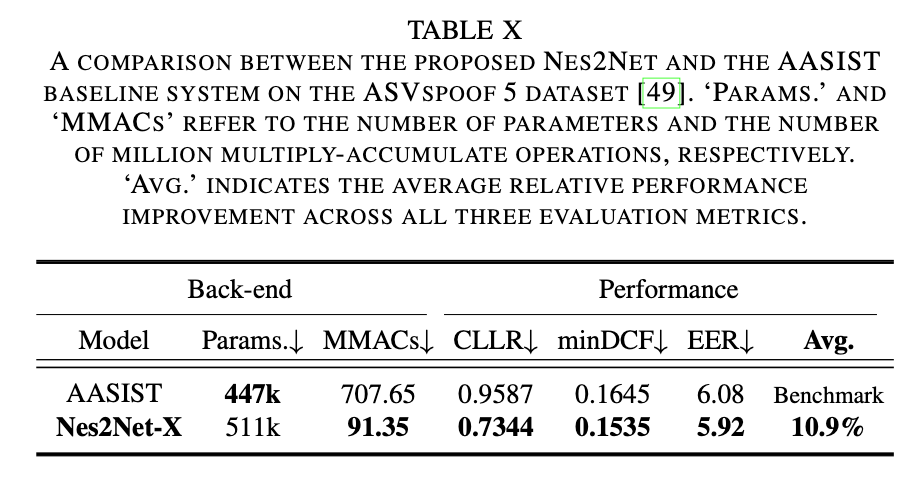
由于ASVspoof 5数据集是最新发布的,目前可用于对比的开源系统较为有限。为确保公平性与可比性,作者复现了AASIST作为基线系统。在此基础上,Nes2Net-X依然展现出一贯的出色表现,兼具高运行效率。在面对多样化伪造方式与真实应用环境的挑战时,Nes2Net-X为构建统一、轻量且高性能的语音反欺骗系统提供了坚实的基础。
在本研究中,我们提出了Nes2Net架构,以结构创新替代传统降维策略,用于高效处理语音基础模型输出的高维特征,避免传统降维层带来的信息损失和计算负担。通过在CtrSVDD, ASVspoof 2021, ASVspoof 5, PartialSpoof以及In-the-Wild等多个具有挑战性的数据集上的实验验证,我们的方法不仅在各种伪造类型和真实场景中表现出色,还展现出优秀的鲁棒性与泛化能力。
我们希望这项工作能够为语音反欺骗研究提供新的思路:不是先压缩再利用,而是保留丰富信息、用创新的结构适配维度。我们在提升性能的同时,也保持了模型的效率和紧凑性。期待Nes2Net能激发更多高维特征建模的探索,欢迎大家试用代码和模型、交流并提出宝贵建议!
参考文献:
[1] A. Baevski, Y. Zhou, A. Mohamed, and M. Auli,“wav2vec 2.0: A framework for self-supervised learning of speech representations,”in Proc. Adv. Neural Inf. Process. Syst. (NeurIPS), vol. 33, 2020, pp. 12 449–12 460.
[2] S. Chen, C. Wang, Z. Chen, Y. Wu, S. Liu, Z. Chen, J. Li, N. Kanda, T. Yoshioka, X. Xiao, J. Wu, L. Zhou, S. Ren, Y. Qian, Y. Qian, J. Wu, M. Zeng, X. Yu, and F. Wei,“WavLM: Large-scale self-supervised pre-training for full stack speech processing,”IEEE J. Sel. Top. Signal Process., vol. 16, no. 6, pp. 1505–1518, 2022.
[3] J.-w. Jung, H.-S. Heo, H. Tak, H.-j. Shim, J. S. Chung, B.-J. Lee, H.- J. Yu, and N. Evans,“AASIST: Audio anti-spoofing using integrated spectro-temporal graph attention networks,”in Proc. ICASSP, 2022, pp. 6367–6371.
[4] Q. Zhang, S. Wen, and T. Hu,“Audio deepfake detection with self- supervised XLS-R and SLS classifier,”in Proc. ACM Int. Conf. Multi- media, 2024, pp. 6765–6773.
[5] Y. Xiao and R. K. Das,“XLSR-Mamba: A dual-column bidirectional state space model for spoofing attack detection,”IEEE Signal Process Lett., vol. 32, pp. 1276–1280, 2025.
