
 语音小管家
来源丨AIGC开放
社今日,AI界突现开源重磅——Together AI与Agentica全面开源DeepCoder-14B-Preview,不仅开放模型权重,更罕见公开了完整训练数据、方法及优化细节。
github:https://github.com/agentica-project/rllm
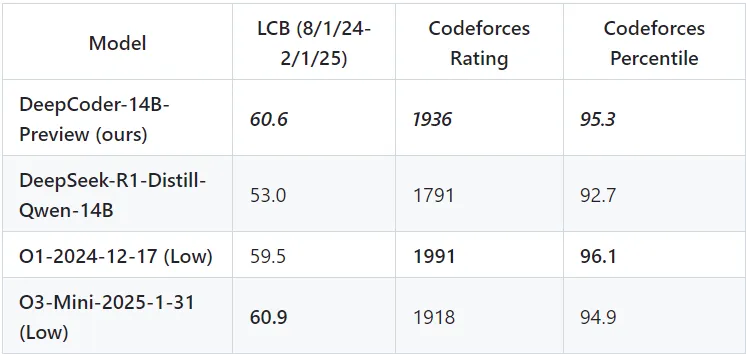
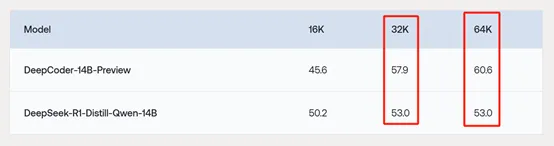
仅140亿参数的DeepCoder,在代码测试平台LiveCodeBench得分60.6%,超OpenAI-o1(59.5%),略逊于o3-mini(60.9%);在Codeforces、AIME2024等硬核评测中表现接近。
值得一提的是,Together AI不仅开源了DeepCoder-14B的模型权重,还完整公开了训练数据集、方法、日志及优化方案,使开发者能够全面掌握该模型的开发全流程。
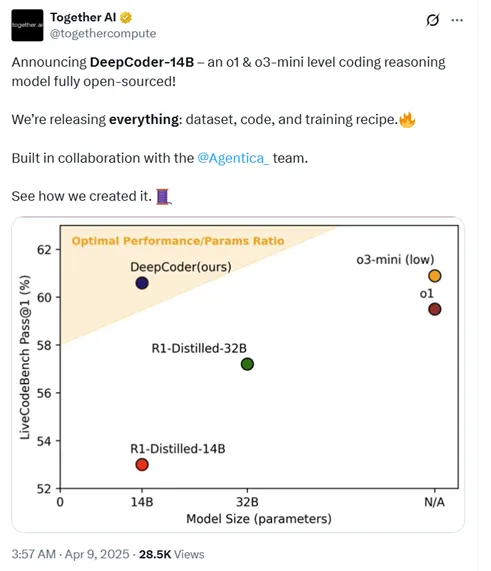
DeepCoder-14B-Preview是在Deepseek-R1-Distilled-Qwen-14B基础上,通过分布式强化学习(RL)进行微调而来。
研究人员为DeepCoder构建了一个包含24K个可验证编程问题的高质量训练数据集,涵盖TACOVerified问题、PrimeIntellect的SYNTHETIC-1数据集中的验证问题等。
为了确保数据质量,通过程序验证、测试过滤和去重等步骤。程序化验证,每个问题都会使用外部官方解决方案自动进行验证。会过滤数据集,只包含官方解决方案通过所有单元测试的问题。
测试过滤,每个问题必须至少包含5个单元测试。重复数据删除,删除了数据集中的重复问题,以避免污染。
在代码强化学习训练中,DeepCoder使用了两种沙盒来运行单元测试并计算奖励:
Together Code Interpreter:快速高效的环境,与RL训练直接兼容,成本低且可扩展性强,支持每分钟1000多个沙盒执行。
本地代码沙盒:独立的受保护Python子进程,遵循官方LiveCodeBench仓库中的评估代码,确保结果与现有排行榜一致。
在奖励函数设计方面,DeepCoder采用了稀疏结果奖励模型(ORM),避免分配部分奖励,从而防止模型通过奖励黑客行为来获取不准确的奖励信号。
奖励函数简单而明确:如果生成的代码通过所有采样单元测试,则奖励为1;否则为0。这种设计确保了模型能够专注于生成高质量的代码,而不是通过记忆测试用例来获取奖励。
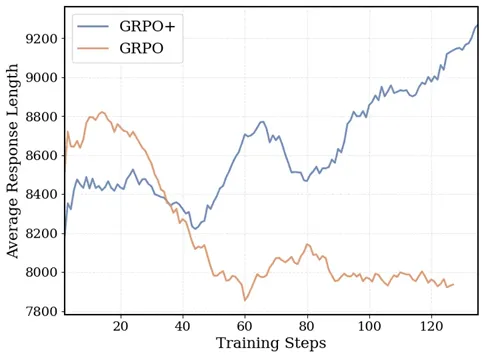
DeepCoder采用了GRPO+算法,这是对原始GRPO(广义信赖域策略优化)算法的改进版本。
通过消除熵损失和KL损失、引入过长过滤和上限裁剪等技术,GRPO+使模型在训练过程中能够保持稳定的熵值,避免训练崩溃,并能更自然地生成较长输出,提高了推理能力。
DeepCoder-14B-Preview采用了迭代上下文扩展技术,模型的上下文窗口从16K扩展到32K,最终在64K上下文中评估时达到了60.6%的准确率。
为了加速端到端RL训练,DeepCoder团队开源了verl-pipeline——一个经过优化的verl扩展版本。该方案采用创新的一次性流水线技术,实现了训练、奖励计算和采样的全流程并行化。
Together AI:从“开源基建狂魔”到代码生成“搅局者”
Together AI作为一家成立于2022年的AI公司,短短 几年内已经成为了生成式AI云平台领域的重要玩家。主打云大模型平台,目前支持超过200种开源AI模型,包括Llama系列、DeepSeek-R1等。
Together AI还拥有超过3.6万块GB200 NVL72组成的超大GPU算力集群,为大规模AI训练和推理提供了强大基础设施。Together AI提供了全面的AI生命周期管理服务,包括快速推理、模型微调、GPU集群训练等功能。
Together AI近期刚刚完成了3.05亿美元的B轮融资,公司估值从去年的12.5亿美元翻倍至33亿美元。这家公司正在快速成长为AI基础设施领域的一匹黑马。
