在 NLP 领域,大模型(LLMs)凭借其强大的理解和推理能力,正在重塑行业格局。另一方面,多模态大模型,尤其是以语音交互为核心的模型也开始崛起,技术发展迅猛,前景广阔。以 GPT-4o 为例,语音与大模型的端到端结合展示出了高实时性与强表现力,进而吸引了大量科研学者及用户的注意。

在实际对话中,语音交流不仅受表达内容的影响,语气、停顿等副语言特征也是重要因素,此外,环境音、说话人特征等背景因素也会对影响到意图的表达。相较于文本,语音模态能传递更多维度的信息,然而种种信息的叠加也导致了语音特征变化无常。这也导致了尽管现有大模型(如 ChatGPT、DeepSeek)在文本理解上已接近人类水平,但让它们“听懂”语音仍面临巨大挑战。

现有方法通常依赖于大规模训练数据(数十万甚至百万小时)实现先进性能。尽管语音大模型可以通过扩大数据量和模型参数的方式解决,但是文本和语音之间的核心问题尚未被充分探讨。

  • 表示空间差异:语音使用额外的语音编码端进行建模,而文本表示由大模型产生,两者在表示空间上并不一致。
  • 序列长度差异:语音以帧为单位表示,而大模型以子词为单位进行建模,这造成语音序列通常几十倍长于文本序列。
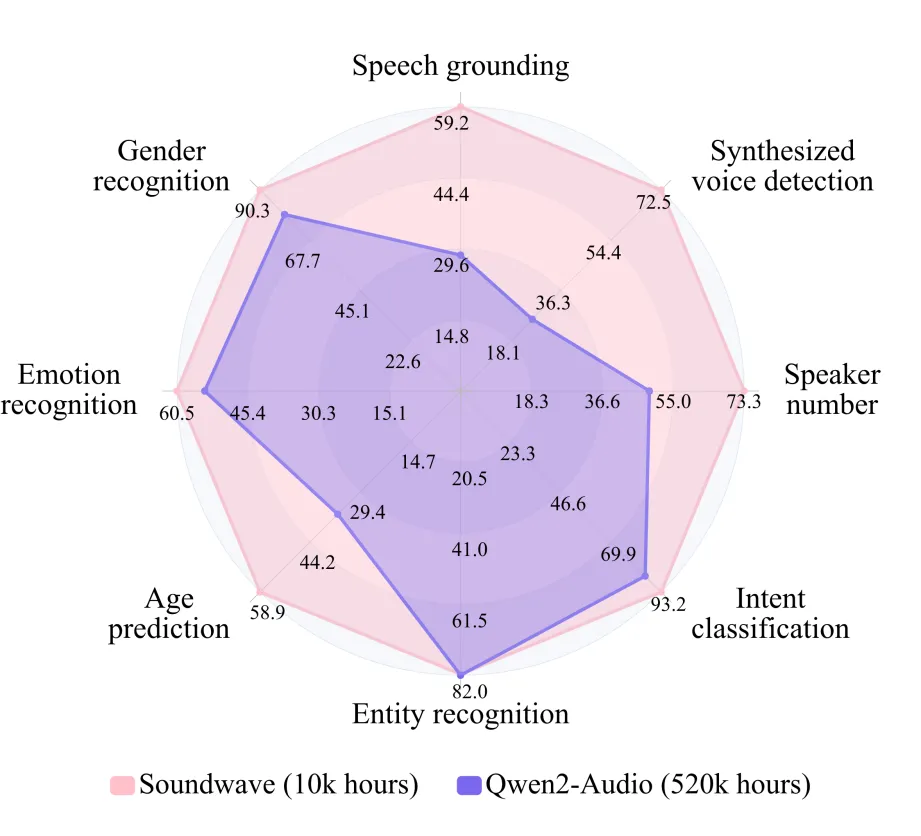
图一:Soundwave 和 Qwen2-Audio 在 AIR-Bench 上的表现

在这样的背景下,香港中文大学(深圳)联合是石科技提出了Soundwave模型,通过解耦语音大模型的模态对齐训练,针对表示空间差异和长度差异这两个核心问题分别设计出针对性的解决方案和任务数据。仅用 10k 小时的数据,Soundwave 便展现出卓越的性能(参考图一)。


论文:https://arxiv.org/pdf/2502.12900

Github:https://github.com/FreedomIntelligence/Soundwave

Huggingface:https://huggingface.co/FreedomIntelligence/Soundwave

整体架构概览

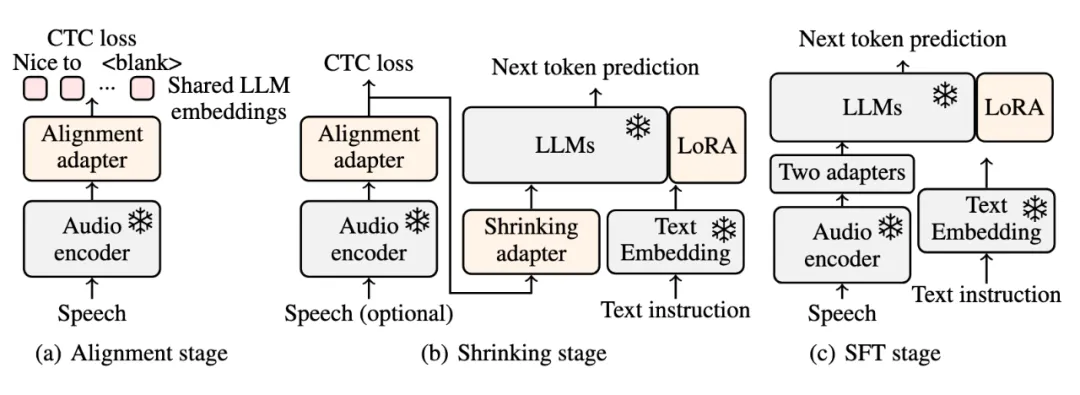
图二:Soundwave 的训练过程。其中灰色模块被冻结,橙色模块被训练。

如图二,Soundwave 的训练分为三个阶段:语音与文本对齐、语音特征压缩、监督微调。
第一阶段:语音与文本对齐
  • 该阶段主要解决语音和文本表示空间的差异,通过设计对齐适配器(Alignment adapter)和使用 CTC 损失实现对齐。对齐适配器包含线性层与单层 Transformer encoder 层,它将音频序列转换到大模型能理解的表示空间,确保音频和文本能够在表示空间中找到“共同语言”。

第二阶段:语音特征压缩
  • 这一阶段主要通过压缩适配器(Shrinking adapter),动态压缩调整语音序列长度,使其与文本匹配,并通过注意力机制提取声学信息。该方法首先根据 CTC 预测的峰值来选择语义特征,然后利用这些特征从原始序列中查询并收集辅助信息(如副语言信息等)。最后,将这两类特征进行融合以实现序列长度的缩减。此过程可以参考图三。
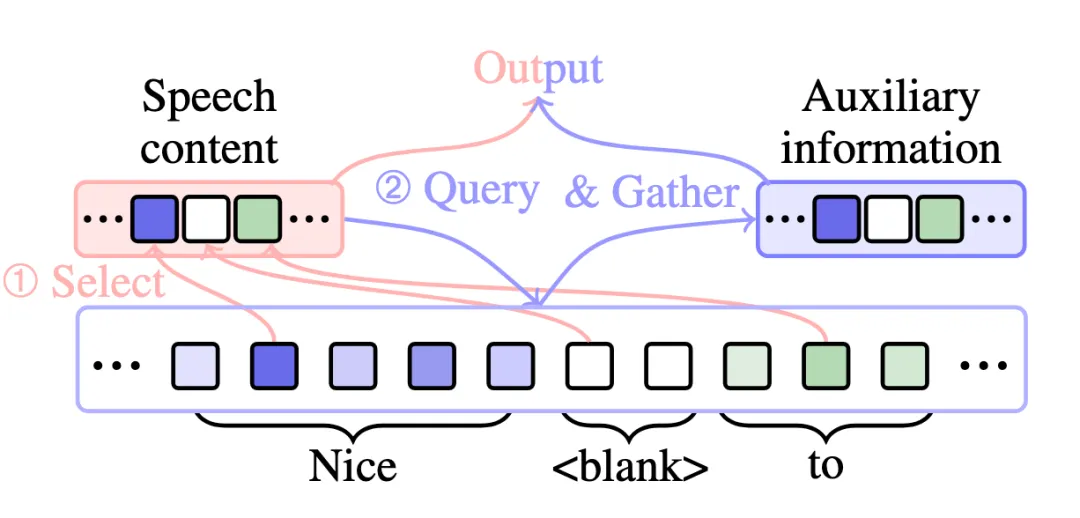

图三: 动态压缩方法示例
第三阶段:监督微调
  • 在微调阶段,模型仅调整 LoRA 参数,利用文本和语音指令数据来提升任务处理能力。模型通过三种不同的问答格式、十余种不同的语音任务以及多样化的指令格式进行学习,增强其指令遵循和语音理解能力。

除此之外,该团队还设计了基于温度的采样方法,对数据进行标注与深度清洗,以及针对语音任务的 Chain-of-Thought 等多种策略提升学习效率。


实 验

实验设置

在实验中,Soundwave采用了 Whisper Large 作为音频编码器,基础模型选择了Llama-3.1-8B-Instruct。语音与文本对齐、语音特征压缩两个阶段各自包含 6000 个训练步骤,监督微调阶段约为 4000 步。

实验结果

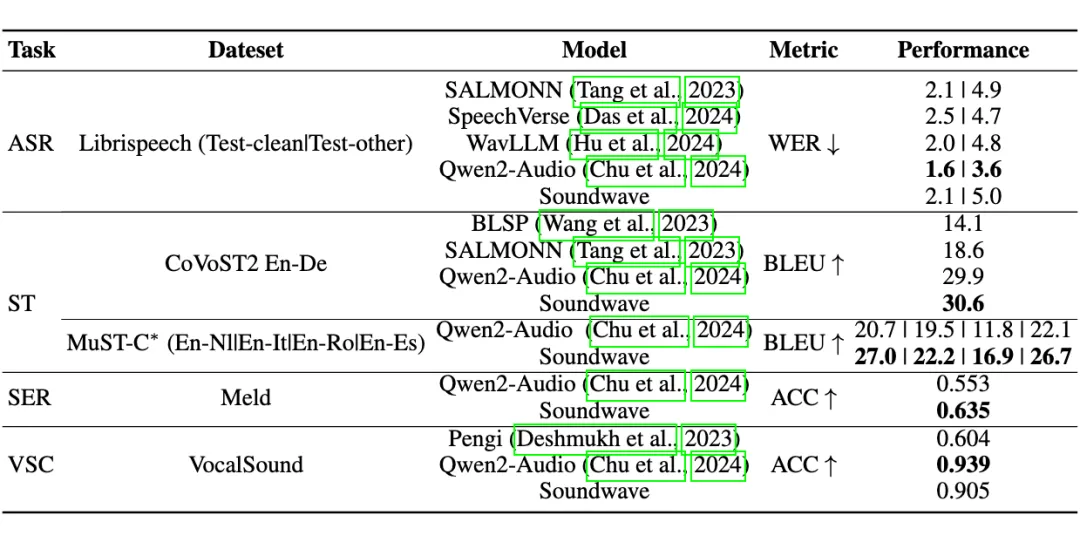
从表一中可以发现,Soundwave在多个音频任务中表现卓越,尤其在语音翻译(Speech Translation)任务上,超越了 Qwen2-Audio,展现了强大的翻译能力。
在语音情绪识别(Speech Emotion Recognition)任务中,它同样展现出色的能力,精准识别语音中的情感。对于Zero-shot任务,如在训练过程中未曾见过语言对翻译,Soundwave 也表现强劲,能够高效进行语言间转换。

表一:在基础任务上的性能表现,这些任务包括自动语音识别(ASR)、语音翻译(ST)、语音情感识别(SER)、发声分类(VSC)。其中*表示 zero-shot 任务。

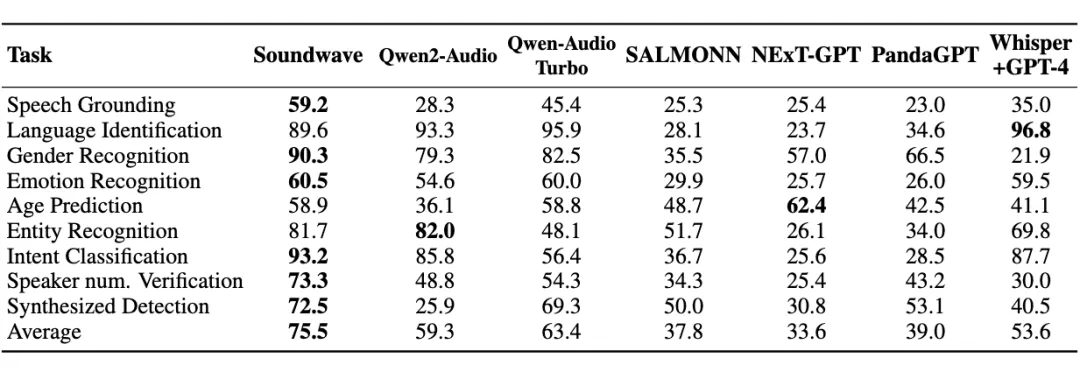
表二:不同语音大模型在 AIR-Bench 上的表现

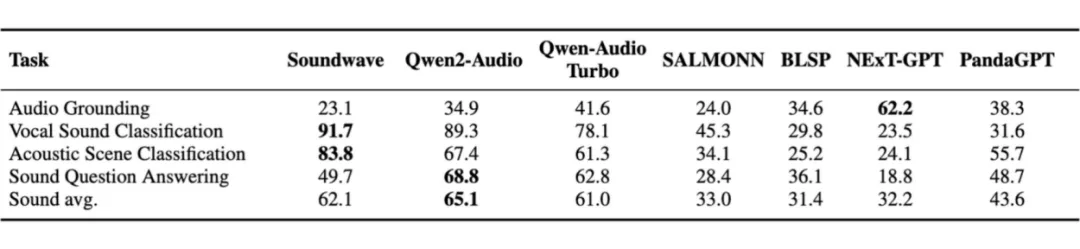
表三:不同语音大模型在 AIR-Bench Sound Foundation 任务中的表现


如表二,在AIR-Bench测试中,Soundwave的表现也令人瞩目。在Speech Foundation任务中,Soundwave 以平均得分 75.5 超越其他模型,显示出其在语音理解上的领先优势。尽管只使用了约 244 小时的 Sound 任务数据,Soundwave 在Sound Foundation任务中依然表现优异,仅次于使用 10k 小时数据的 Qwen2-Audio。此外,Soundwave 的单编码器架构比双编码器模型在处理语音时表现更佳,展现了更高的效率。如表三,在AIR-Bench  Sound Foundation任务中,Soundwave仅凭244小时的Sound 数据便跃居第二,仅次于Qwen2-Audio,充分证明了其卓越的声音感知能力。

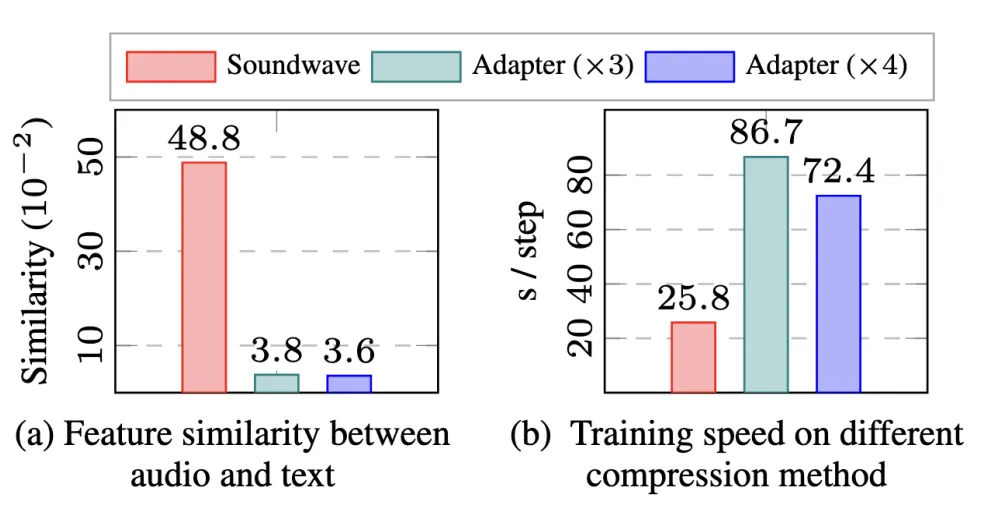
图五:不同音频特征压缩方法下,(a)语音、文本特征相似度对比(b)训练速度对比
该团队从 Librispeech-clean 测试集中随机抽取了 200 个样本,并提取了文本和语音的特征表示。经过平均池化后,将语音和文本的相似性进行比较。如图五(a)所示,该团队发现,带有对齐适配器的 Soundwave 表示显著优于其他方法。此外,该团队还比较了在相同批量条件下的平均训练速度。如图五(b),在语音文本对齐阶段,训练速度几乎是其他方法的三倍。无论是对齐效果还是训练方法,对齐适配器都表现出明显的优势。

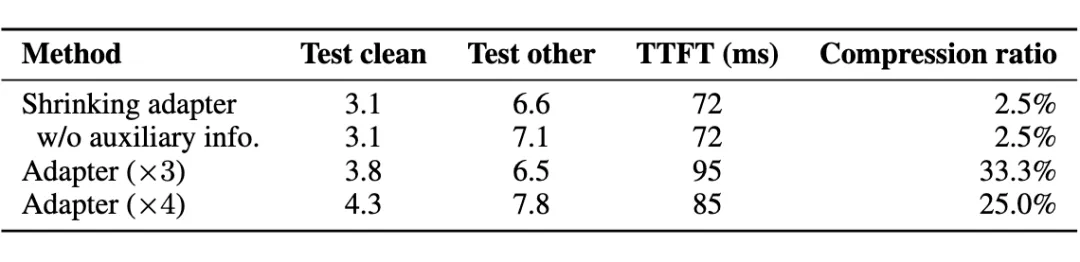
表四:不同方法压缩率与首字符响应速度比较

不仅如此,该团队在 ASR 任务上对不同压缩策略进行了对比,发现压缩适配器能够在仅 2.5% 压缩率的情况下保持稳定性能,同时显著加快推理速度。相比 Adapter(×3)和 Adapter(×4)(Adapter(×N)采用与Qwen2-Audio相同的架构,但具有不同的压缩率),该团队的方法分别提升了约 15% 和 25% 的首 Token 延迟(TTFT,Time to First Token),并且几乎不增加计算开销,证明其轻量且高效。然而,在缺少辅助信息的情况下,压缩会导致性能下降,这表明辅助信息在补充缺失特征、确保大模型完整理解方面起到了关键作用。
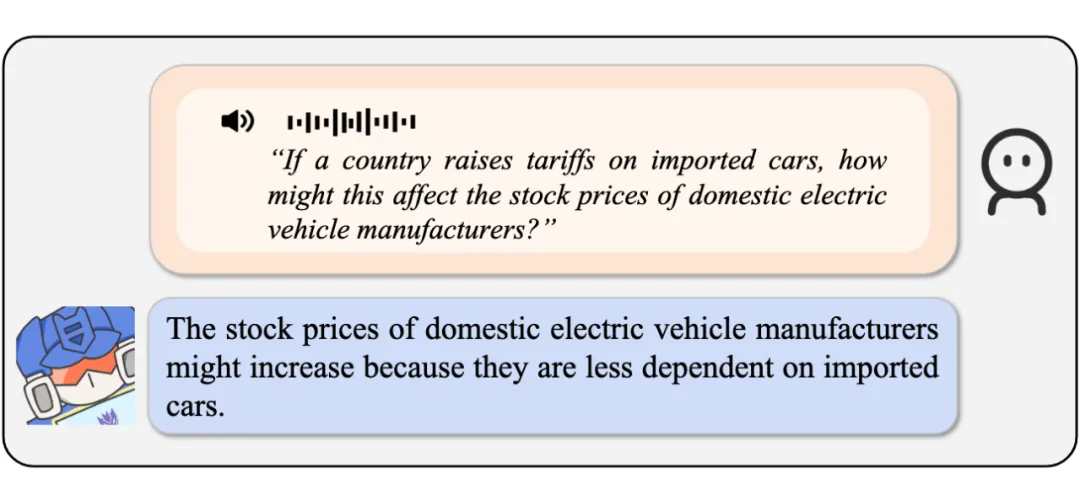

图六:QA问答示例

Soundwave 同时具备强大的问答(QA)功能,能精准理解语音输入,并迅速生成合理答案。如图六所示,用户提出经济市场相关问题,模型准确把握因果关系并作出恰当回应,展现出卓越的分析与推理能力。无论是财经、科技还是日常生活领域,Soundwave都能提供高效、精准的智能问答支持。


总 结

该团队提出了Soundwave模型,其借助高效的语音-文本对齐解决方案,突破了传统语音大模型对大规模标注数据的依赖。该团队通过创新性的三阶段训练策略,分别解决了语音与文本的表示空间差距和序列长度不一致性问题,使得模型能够更高效地学习语音理解和对齐能力。实验结果表明,Soundwave 在一万小时训练数据的情况下,在多个语音任务上的表现超越了使用大规模数据训练的 Qwen2-Audio ,并在多个zero-shot任务上展现了良好的泛化能力。

Soundwave 作为高效的语音大模型,在医疗可用于语音病历转录和远程会诊记录,在教育赋能课堂字幕、语言学习辅助,在智能交互促进语音助手、智能家居和客服系统优化。未来,Soundwave 将持续优化语音理解能力,推动语音 AI 在更多场景落地。