语音小管家
来源丨量子位
近日,豆包语音模型基于原有Seed-TTS框架进一步加入上下文理解,实现了高表现力、高自然度、高语义理解的小说演播效果。
无需额外标签,端到端合成声音
市面上很多的语音模型已经能保证足够自然的合成表现,但在音质、韵律、情感,以及多角色演绎上还有探索空间。特别是在小说演播场景下,想要媲美一流主播细腻的演播效果,要做好旁白和角色的区分演绎、角色情感的精确表达、不同角色的区分度等。
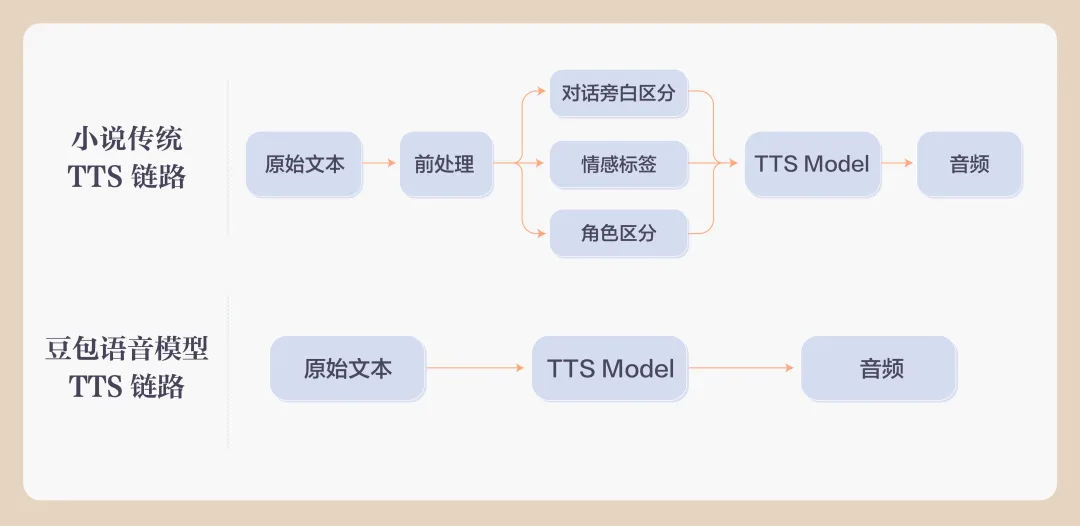
△传统语音模型和豆包语音模型合成链路的区别
改进Seed-TTS技术,合成语音效果媲美真人
其中Speech Tokenizer解析了参考音频信息,决定了合成音频的音色和全局风格;Autoregressive Transformer接收传入的目标文本和Speech Tokenizer的输出,进而生成出包含语义信息的Semantic Token;Diffusion Model会基于Semantic Token建模出包含语音信息的Acoustic Token;Acoustic Vocoder负责将Acoustic Token重建还原出最终的音频。
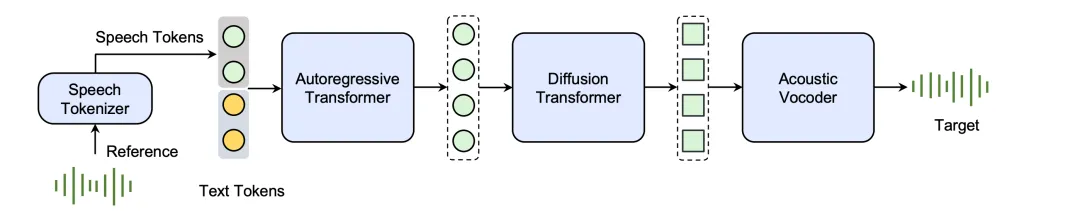
△原始Seed-TTS架构
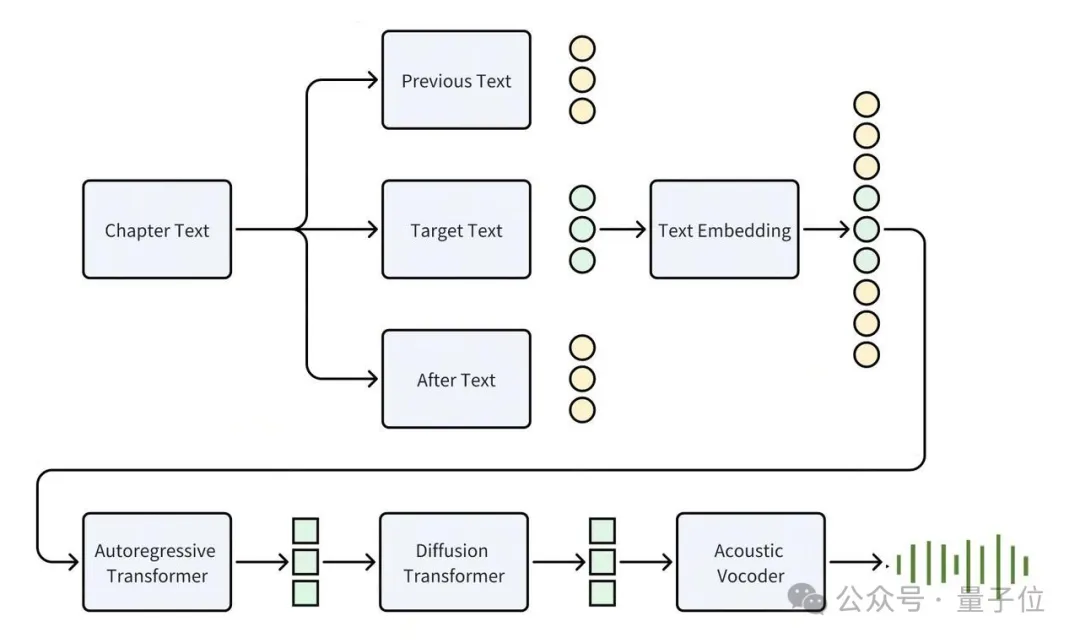
为进一步提升小说演播下的语音表现力和长文本的理解,豆包技术团队对Seed-TTS进行了改进。
在数据上,小说音频做章节级别处理,保证了长文下的语音一致性和连贯性。 在特征上,融合TTS前端提取的音素、音调、韵律信息和原始文本,提升发音和韵律的同时,保留小说语义。 在结构上,将speech tokenizer改为speaker embedding,解除reference audio对于语音风格的限制,因而同一个发音人能在不同角色上作出更贴合人设的演绎。 最后在目标合成文本之外,额外加入了上下文的信息,从而使得模型能够感知更大范围的语义信息,旁白和角色音表现更精准到位。