语音小管家
来源丨机器之心
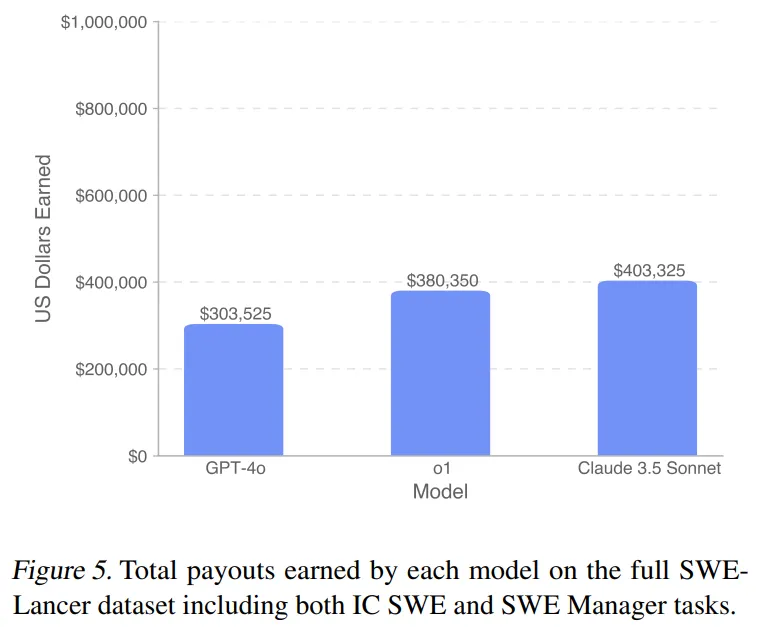
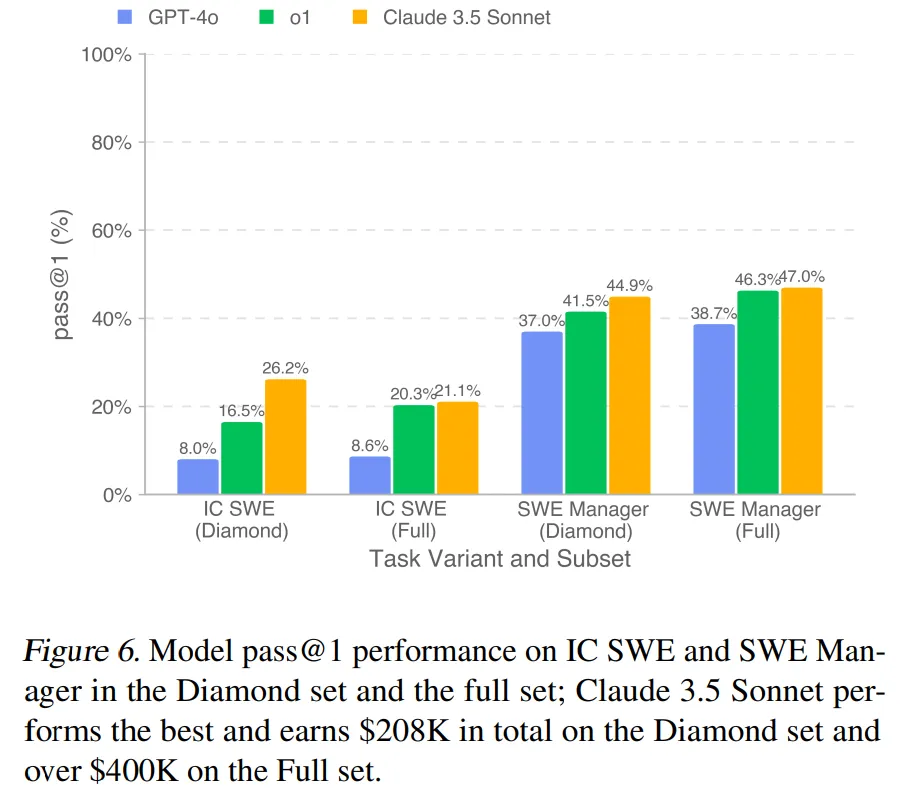
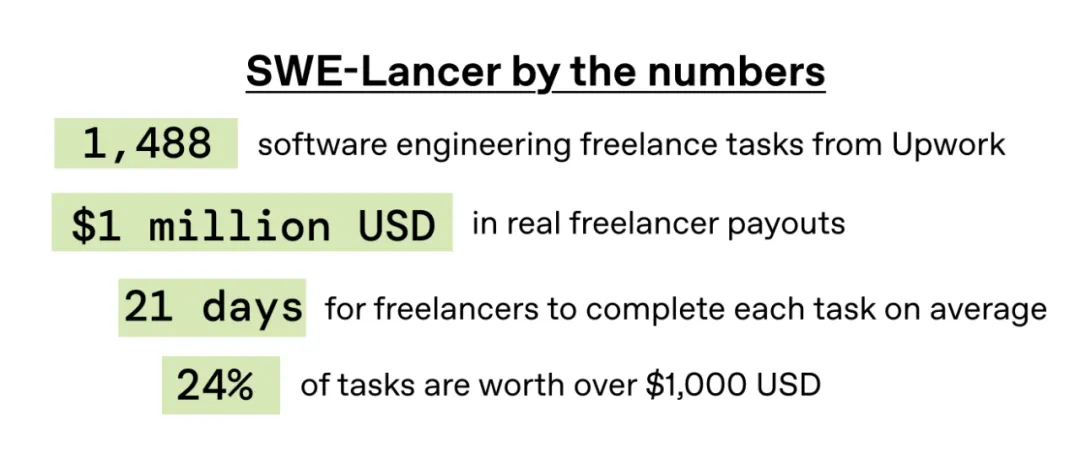
今天凌晨2点,OpenAI开源了一个全新评估大模型代码能力的测试基准——SWE-Lancer。
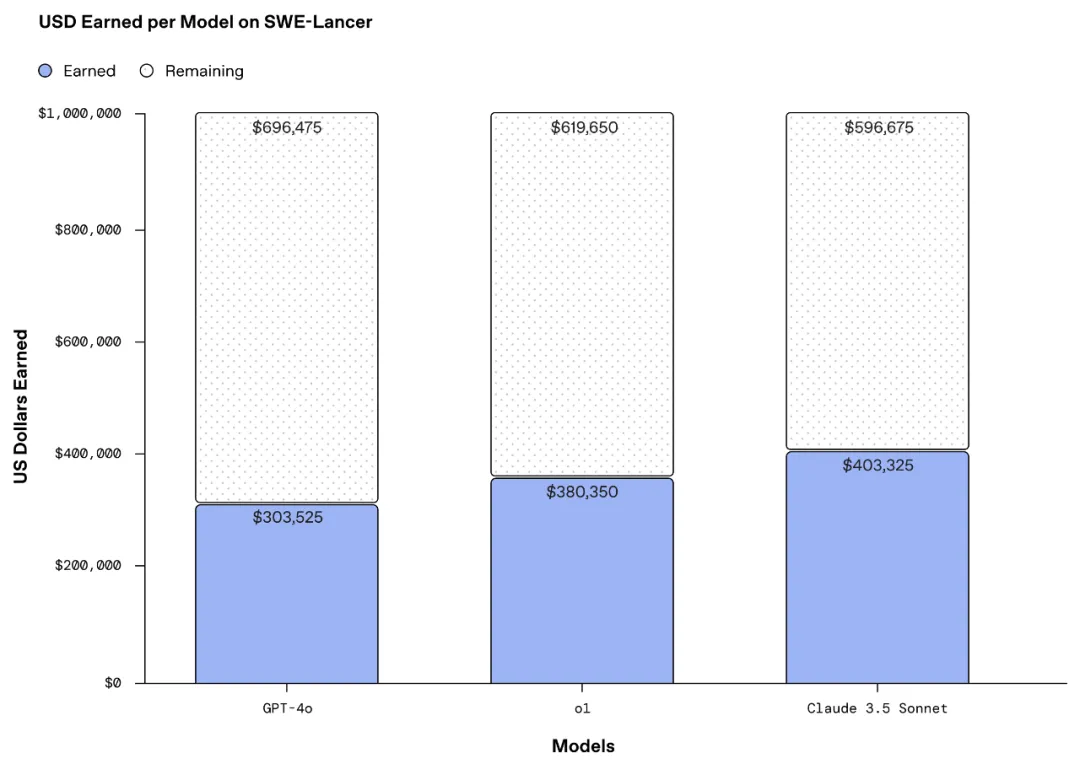
论文标题:SWE-Lancer: Can Frontier LLMs Earn $1 Million from Real-World Freelance Software Engineering? 论文地址:https://arxiv.org/pdf/2502.12115 项目地址:https://github.com/openai/SWELancer-Benchmark
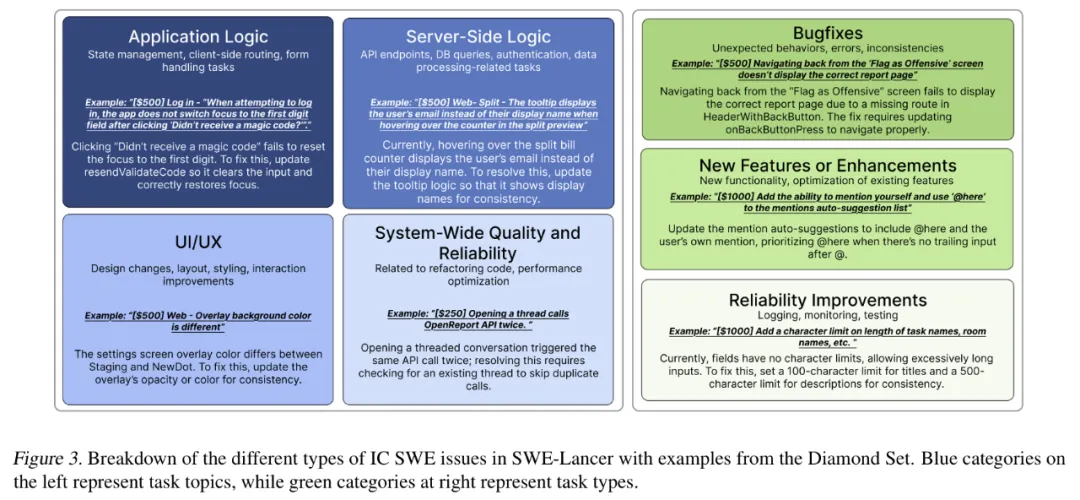
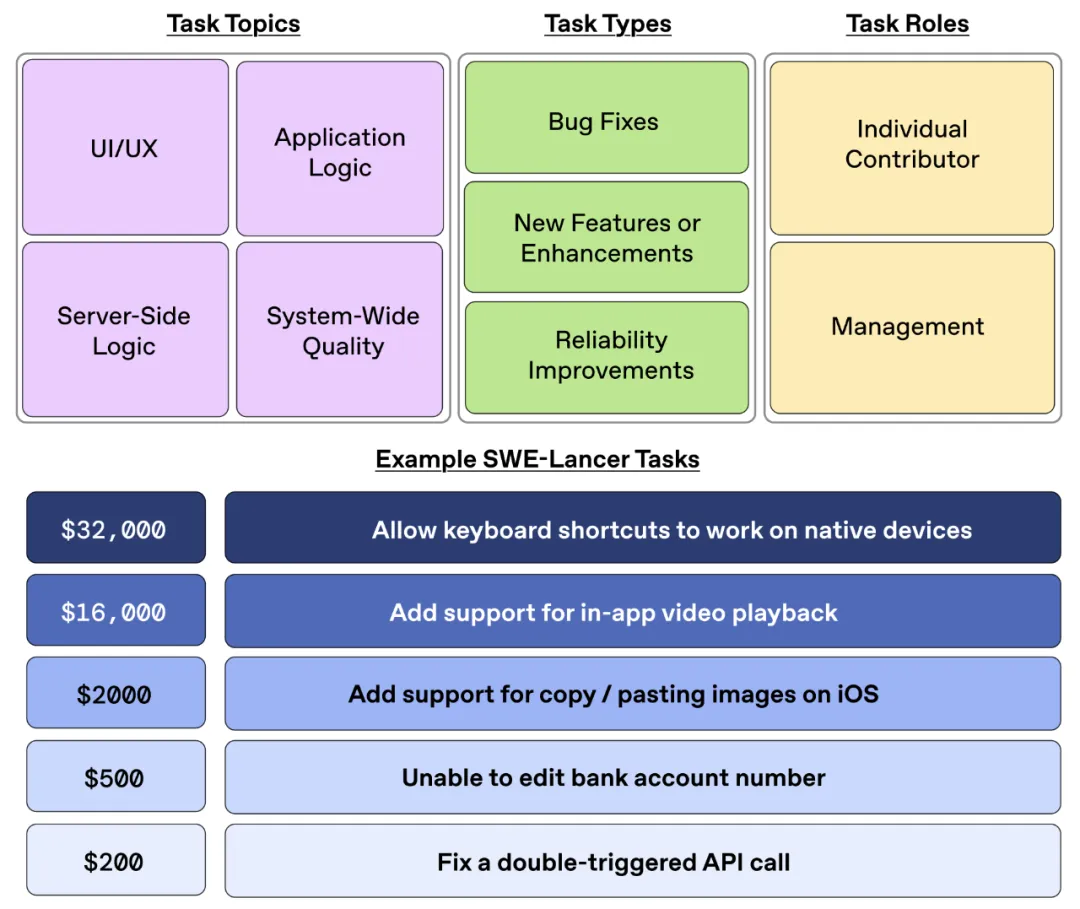
IC 任务通过端到端测试评估,这些测试由专业软件工程师编写,模拟真实世界的应用行为。 管理任务通过与原始工程经理的选择对比来评估。