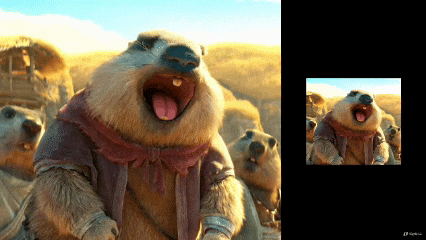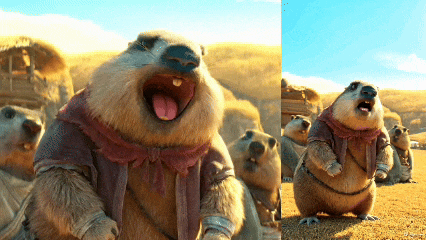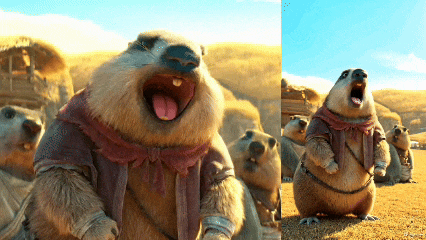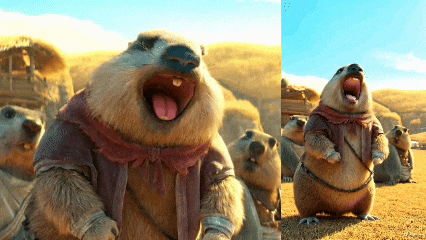
刚刚,中国首个AI短剧视频生成模型——SkyReels-V1正式开源,千万级好莱坞数据训练微调。更震撼的是,首个SOTA级表情动作可控算法同时开源,每一个表情,每一个肢体动作,AI精准掌控。
今天,昆仑万维开源中国首个面向AI短剧创作的视频生成模型SkyReels-V1、中国首个SOTA级别基于视频基座模型的表情动作可控算法SkyReels-A1。
SkyReels官方地址:skyreels.ai
SkyReels-V1:Human-Centric Video Foundation Model,中国首个面向AI短剧创作的开源视频生成模型
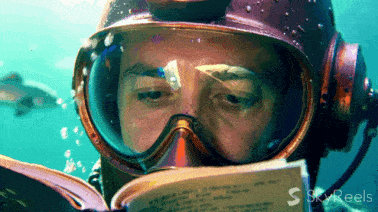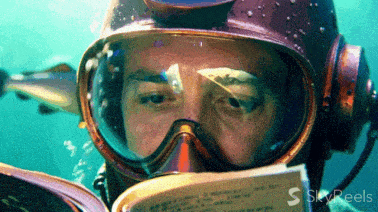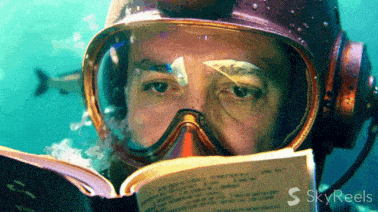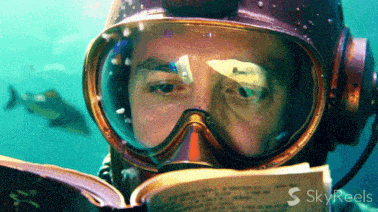
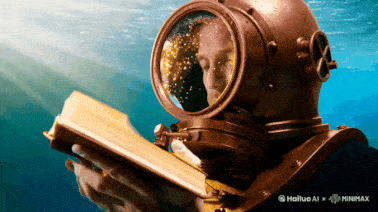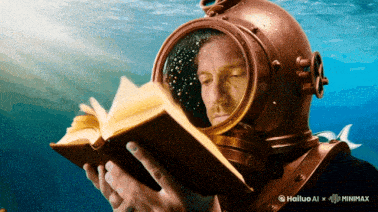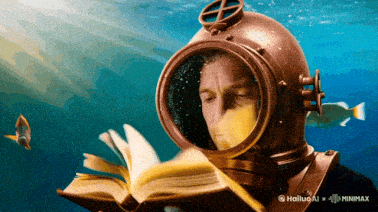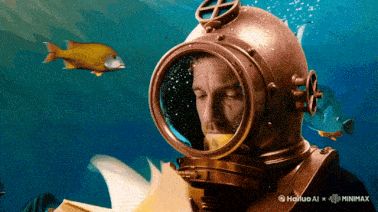
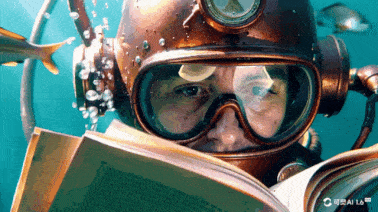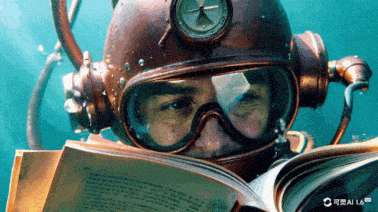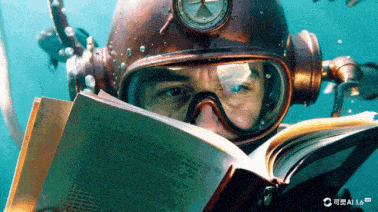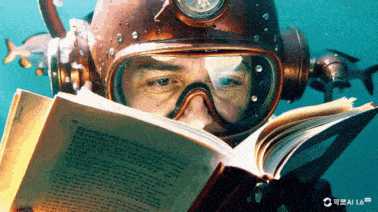
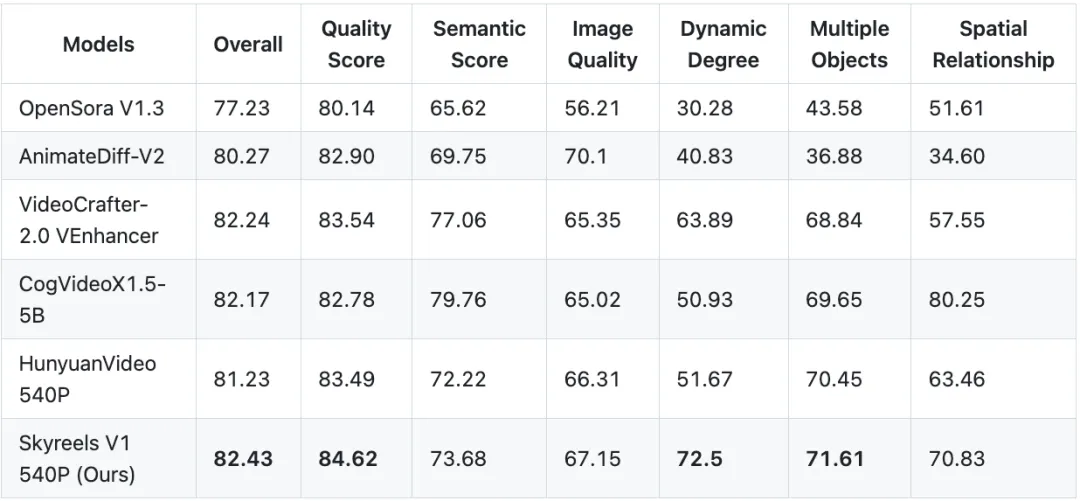
SkyReels-V1是受益于开源社区并回馈开源社区的大模型,它是在腾讯去年12月开源的混元视频大模型HunYuan-Video的基础上训练而来。开源模型虽然在通用任务上表现出色,但并非拿来即用,尤其是在特定领域或细分任务上的表现可能无法达到最佳效果。因此,模型厂商在实际的模型训练中还涉及大量的微调、推理优化、安全对齐等相关工作。目前AI短剧市场中的视频大模型普遍存在一些不足,最典型的就是人物生成表情空洞,甚至宛如智障。昆仑万维希望突破这些痛点。模型训练是让大模型学会知识与能力的核心环节。在训练过程中,昆仑万维需要教会SkyReels-V1“如何学会表演”。这其中最核心的技术贡献有两点:首先是数据清洗与标注,这是模型微调的关键所在。就像教师教学时需要用到的教材一样,昆仑万维基于自研的高质量数据清洗和人工标注管线,构建了千万级的高质量电影、电视剧、纪录片数据,这是模型要学习的“教材”。但光有“教材”还不够,还要对模型做进一步的指导。为此,昆仑万维自研了Human-Centric(以人物为中心的)视频理解多模态大模型,大幅提升视频中人物相关的理解能力。这套基于视频理解多模态大模型所构建的人物智能解析系统,在影视化的表情识别、人物空间位置感知、行为意图理解、表演场景理解等不同层次的表演上,都能达到“影帝级别”的人物表演。比如,SkyReels-V1可以生成影视级人物微表情表演,支持33种细腻人物表情与400+种自然动作组合,高度还原真人情感表达。再比如,SkyReels-V1还学会了电影级光影美学。基于好莱坞级的高质量影视数据训练,生成的每一帧画面,在构图、演员站位、相机角度等都具备电影级的质感。尽管SkyReels-V1是一个开源模型,但却有媲美海螺AI、可灵AI等闭源模型的效果。给出同样的提示词,SkyReels-V1、海螺AI、可灵AI的生成效果分别如下:提示词:戏剧性的正面特写镜头揭示了一位深海潜水员戴着老式铜制潜水头盔的面容。头盔厚厚的圆形玻璃提供了清晰视野,可以看到他平静的表情。微小的气泡在头盔内向上飘浮,水滴附着在内壁上。他小心翼翼地捧着一本敞开的书,书页在海底水流中轻轻飘动。这本书看起来干燥完好,与周围的水环境形成鲜明对比。柔和的阳光束穿透水面,照亮了他的脸庞,并在书页上洒下金色光芒。鱼儿在周围游动,颜色因深度而变得柔和,但在蓝绿色背景前依然生动。潜水员专注地阅读着文本,尽管身处水下,却完全沉浸在阅读中。文学与海洋深处的超现实结合营造出梦幻般的氛围,突出了在最意想不到的地方追求知识的追求。从实际效果不难发现,无论是在画面清晰度与人物表演方面,SkyReels-V1都有媲美闭源模型的能力。甚至在一些细节处理效果上(例如头发丝的动态)要比闭源模型更强。SkyReels-V1文生视频指标对比(来源:昆仑万维SkyReels)此外,SkyReels-V1不仅支持文生视频,也支持图生视频的能力,是开源模型中最大的支持图生视频的模型。我们将春节档最热电影《哪吒之魔童闹海》中深入人心的土拨鼠剧照发给SkyReels-V1,并给定提示词:土拨鼠抬起头停顿了一秒,然后大吼大叫。生成的效果让人惊艳:可以说,SkyReels-V1就是当前市场上最懂表演的视频大模型。
综上所述,得益于扎实的数据工作和先进的人物智能解析系统,SkyReels-V1可以实现:
影视化表情识别体系:11种针对影视戏剧中的人物表情理解,如不屑、不耐烦、无助、厌恶等表情的理解;
人物空间位置感知:基于人体三维重建技术,实现对视频中多人的空间相对关系理解,助力模型生成影视级人物站位;
行为意图理解:构建超过400种行为语义单元,实现对人物行为的精准理解;
- 表演场景理解:实现人物-服装-场景-剧情的关联分析。
在自研推理优化框架「SkyReels-Infer」的加持下,大幅提升推理效率,实现544p分辨率,推理基于单台4090只需80s,还支持分布式多卡并行,支持Context Parallel,CFG Parallel,和VAE Parallel。此外,采取fp8 quantization以及parameter-level offload,满足低显存用户级显卡运行需求;支持flash attention、SageAttention,模型编译优化等,进一步优化延迟;基于开源diffuser库,提升易用性。正如下图2所示,在同等RTX4090资源情况下对比(4卡),SkyReels-Infer版本比HunyuanVideo官方版本端到端延迟减少58.3%(293.3s vs 464.3s);SkyReels-Infer版本具备更鲁棒的部署策略,支持用户级别显卡1卡-8卡的推理部署。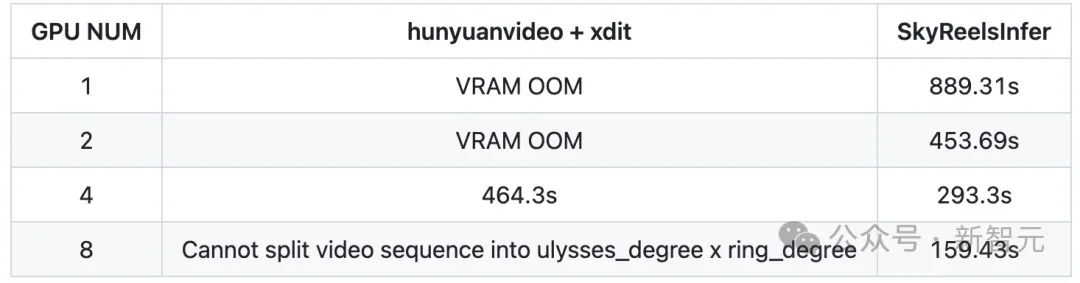
图2丨推理生成544p视频,使用相同卡数的RTX 4090,SkyReels-Infer版本端到端延迟优于HunyuanVideo官方(xdit)58.3%在同等A800资源情况下对比,SkyReels-Infer版本比HunyuanVideo官方版本端到端延迟减少14.7%~28.2%(如图3所示),SkyReels-Infer版本具备更鲁棒的多卡部署策略。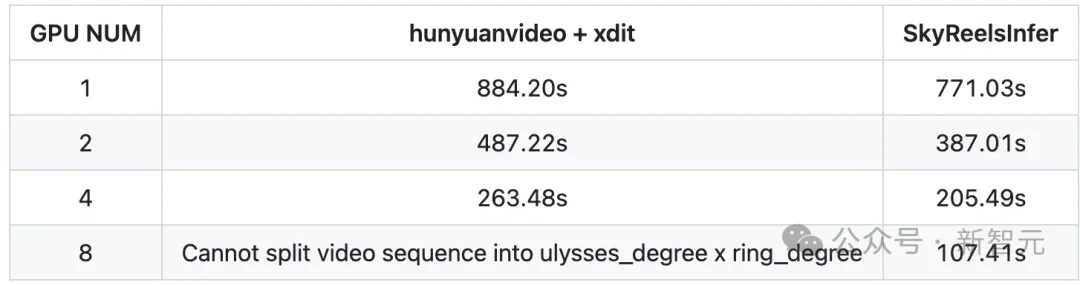
图3丨推理生成544p视频,SkyReels-Infer版本具备更鲁棒的多卡部署策略,支持8卡部署
SkyReels-A1:首个SOTA级别的基于视频基座模型的表情动作可控算法
SkyReels-A1是首个基于视频基座模型的表情动作可控算法,达到了SOTA水平。该算法支持视频驱动的电影级表情捕捉,能够实现高保真的微表情还原。SkyReels-A1能够基于任意人体比例生成高度逼真的人物动态视频,其真实感来源于对人物表情、情绪、皮肤纹理和身体动作等多维度细节的深度还原。
SkyReels-A1还支持侧脸表情控制生成,能够实现更加逼真的眉眼微表情和更大范围的头部与身体动作。与Runway的Act-One相比,SkyReels-A1生成的视频中人物不失真,表演细节更加真实,能够实现神情与身体动作的自然融合。
SkyReels-A1能够实现更大幅度的人物表情驱动。在下面视频中可以看到,相比Runway的Act-One(无法生成),SkyReels-A1可以迁移更复杂的表情动作,生成的人物面部神情可以配合肢体及画面内容实现更栩栩如生的表演。
 语音小管家