
 语音小管家
论文题目:StableVC: Style Controllable Zero-Shot Voice Conversion with Conditional Flow Matching
作者列表:姚继珣,杨宇光,潘宇,宁子谦,叶剑豪,周鸿斌,谢磊
合作单位:喜马拉雅
论文原文:https://arxiv.org/pdf/2412.04724
零样本语音转换 (Zero-Shot Voice Conversion) 近年来取得了显著的进展,并在专业有声读物制作和娱乐短视频等领域找到了重要的应用。然而,现有方法大多只关注将音色迁移到未见过的说话者,而忽略了对语音风格的控制。语音风格指的是说话人表达情感和态度的方式,包括音调变化、语速、语调和情感等。能够独立地控制语音风格和音色对于丰富语音的表现力和个性化至关重要。此外,现有的零样本语音转换方法的推理速度也是一个挑战。基于大型语言模型和基于扩散的方法虽然在零样本场景中取得了令人瞩目的成果,但它们分别依赖于自回归token预测和多步反向采样,导致推理速度缓慢。这限制了零样本语音转换技术在实时应用中的实用性。
因此,本文旨在解决上述两个关键问题:实现对语音风格的灵活控制,并提高零样本语音转换的推理效率。为了实现这一目标,StableVC 提出了一种全新的框架,将语音分解为语言内容、音色和风格,并利用条件流匹配模块在非自回归的方式下重建目标梅尔频谱图。StableVC是一种新颖的风格可控的零样本语音转换方法,可以将音色和风格独立地转换到不同未见说话者,从而实现音色和风格迁移的任意组合。我们引入了条件流匹配模块,用于以音色和风格为条件预测概率密度路径,与传统的基于扩散和基于语言模型的方法相比,显著提高了合成速度和样本质量。在流匹配模块中提出了一种带有自适应门控的双重注意力机制(DualAGC)来捕获独特的音色和风格。同时,引入了自适应风格门控和音色先验信息,以确保音色和风格建模的稳定性。StableVC 不仅实现了对语音风格的灵活控制,还提升了转换的质量和效率,为零样本语音转换领域带来了新的突破。
模型架构
如图1所示,StableVC 包含三个特征提取器,用于提取语言内容、风格表示和梅尔频谱图。此外,它还包含一个内容模块和一个时长模块,用于根据不同的风格和音色重新预测时长,以及一个流匹配模块,用于生成高质量梅尔频谱图。
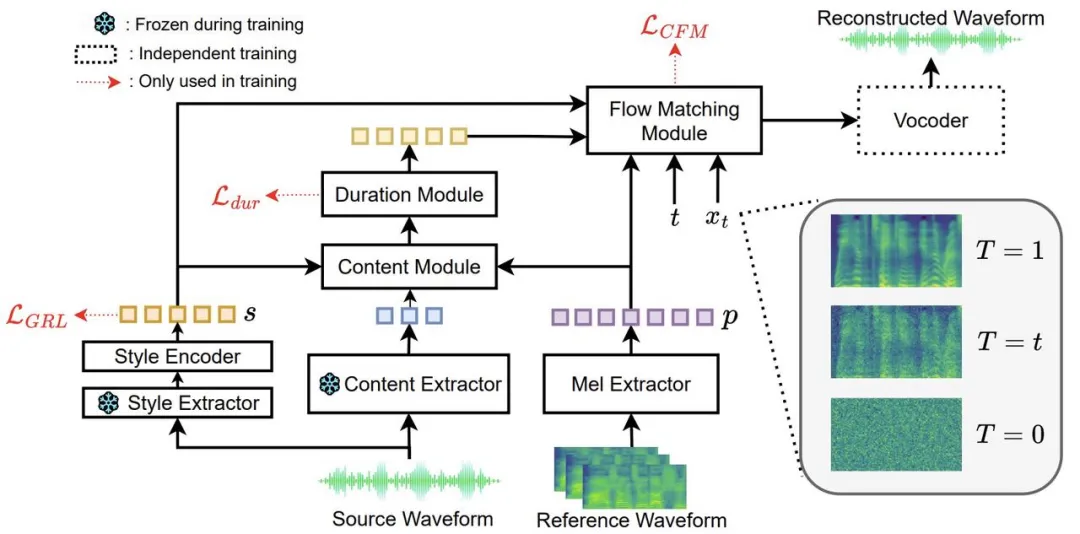
图1 StableVC框架图
特征解耦
语言内容提取:第一步使用预训练的 WavLM 模型和 K-means 聚类提取离散的语言内容标记;第二步对提取的离散标记做去重处理,并记录时长方便后续时长模块根据不同风格进行时长建模
风格表示提取:使用FACodec作为风格提取器,提取语音风格的解耦子空间表示
音色表示提取:从与源语音相同说话者的多个参考语音中提取梅尔频谱图作为音色特征的来源
音色注意力:使用从多个参考语音中提取的梅尔频谱图作为音色注意力的值,并使用预训练的说话者验证模型提取的全局说话者嵌入作为音色先验,引导音色注意力捕捉与音色相关的信息。 风格注意力:使用经过下采样压缩的风格表示作为风格注意力的键和值,并使用自适应门控机制控制风格信息的建模过程。
条件流匹配模块
StableVC 使用条件流匹配模块生成概率密度路径,并使用欧拉步骤逼近 ODE 的解,从而高效地生成与目标分布匹配的样本。
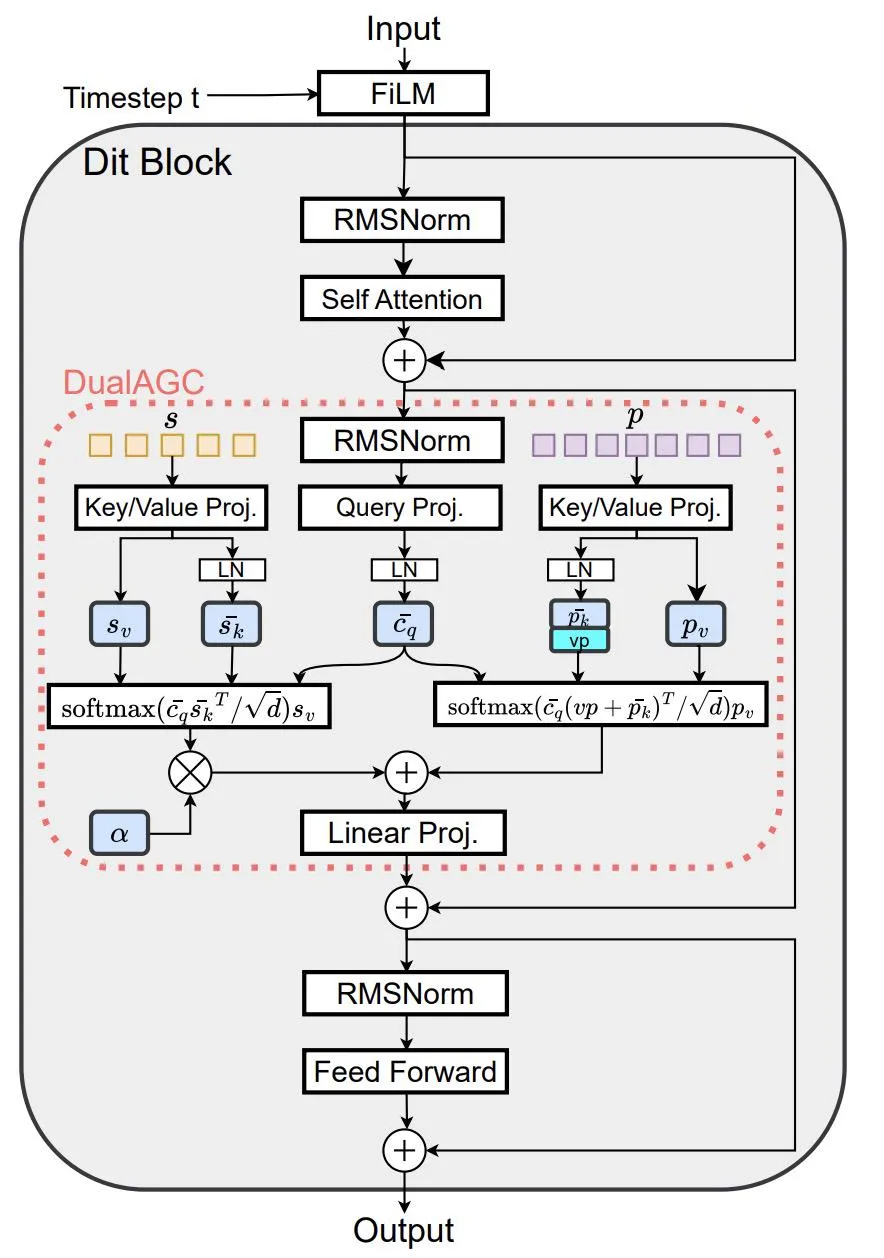
图2 DualAGC模块结构图
训练数据集
StableVC 使用LibriLight数据集进行模型训练,包含 60,000 小时的语音数据。为了保证训练数据的质量,我们筛选了时长超过 5 秒的样本,并使用 DNSMOS P.808 分数过滤掉了低质量样本,最终得到一个包含 20,000 小时的训练子集。
验证数据集
为了评估模型的泛化能力,StableVC 使用了VCTK和ESD语料库进行评估。VCTK 语料库用于评估音色迁移性能,包含来自 10 位男性和 10 位女性说话者的语音样本。ESD 语料库用于评估风格迁移性能,包含 5 种不同风格的语音样本,每种风格选择了 2 个高强度样本,总共 200 个参考样本。
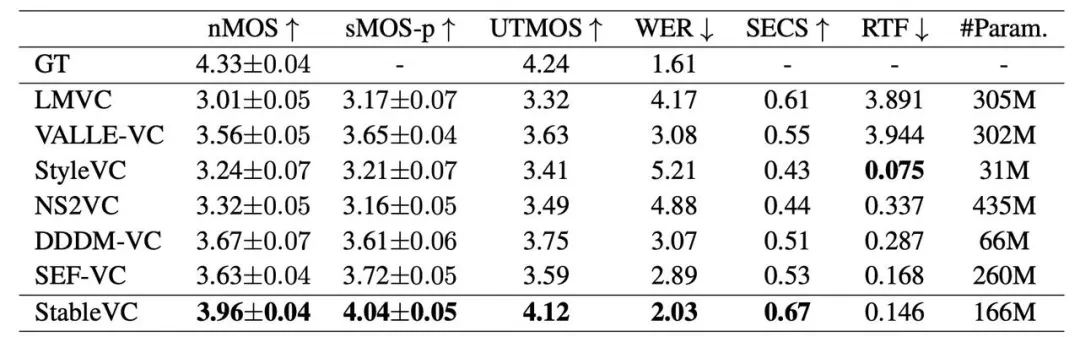
我们首先评估了StableVC在零样本语音转换场景下的性能,音色和风格参考来自同一条音频,实验结果如表1所示。我们可以发现StableVC 在自然度、语音质量、说话人相似度和鲁棒性等方面均优于所有基线系统。StableVC 生成的样本自然度高,音质良好且说话人相似度高,且具有很强的鲁棒性。同时,StableVC 的推理速度也明显优于基于语言模型和基于去噪扩散的基线系统,证明了 StableVC 是一种高效的零样本语音转换方法。
表 1 零样本语音转换的性能评估
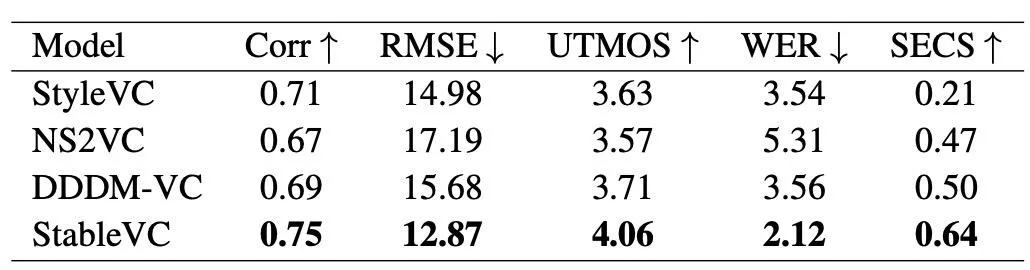
此外,我们比较了 StableVC 和基线系统在零样本风格迁移任务上的表现,即音色和风格参考来自不同的未见过说话人音频。由于部分基线系统不支持同时输入音色和风格提示,因此选择了 StyleVC、NS2VC 和 DDDM-VC 作为基线系统进行比较,客观指标比较结果如表2所示。StableVC 在所有指标上均优于基线系统,包括音调相关指标、语音质量和说话人相似度。尽管StyleVC 在风格迁移方面取得了可比的结果,但在有效迁移目标音色方面存在困难,StyleVC 转换后的样本说话人音色相似度较低。
表 2 零样本风格迁移的性能评估
我们还使用小提琴图展示了基线系统和 StableVC 生成的语音的音色相似度和风格相似度的主观评价结果,如图3所示。我们发现:1)StableVC 的音色相似度和风格相似度的中位数都高于三个基线系统,表明 StableVC 在音色和风格迁移方面表现更佳,生成的语音与目标说话人和目标风格更相似。2)StableVC 的主观得分总体分布也优于基线系统,这意味着 StableVC 生成的语音质量更高,更接近真实语音。图 3 的结果与客观评价结果一致,都证明了 StableVC 在准确迁移音色和风格方面的优越性能。StableVC 能够独立且准确地转换来自不同未见说话人的音色和风格,生成高质量、可理解且富有表现力的语音转换结果。
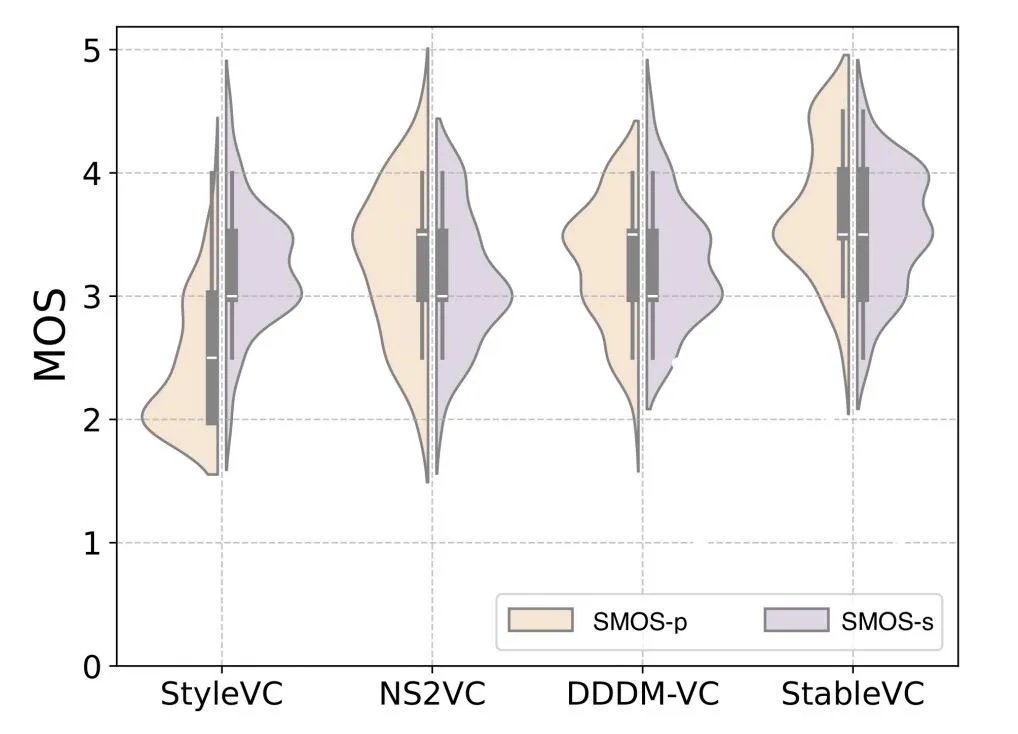
图3 风格迁移主观指标的小提琴图
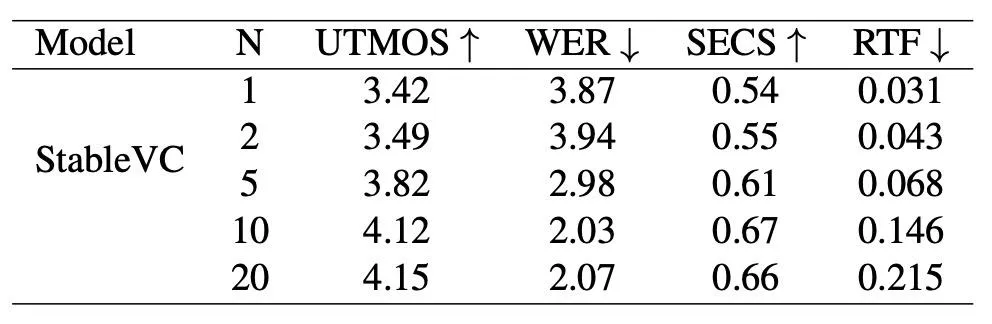
为了评估效率和质量之间的权衡,我们还展示了不同欧拉采样步数 N 对 StableVC 中流匹配模块的影响。,实验中使用了 1 到 20 步欧拉采样进行比较。表3中列出了不同步数下语音质量、词错误率、说话人相似度和实时因子的得分。即使使用很少的欧拉步数,StableVC 仍然可以实现较低的 WER,表明流匹配模块生成的样本可以被 ASR 模型准确识别,具有很强的鲁棒性和可懂度。评价结果在大约 5 步欧拉步数后趋于稳定,在 10 步左右获得更好的音频质量,在 20 步时仅观察到轻微的改进。尽管 RTF 随着采样步数的增加而增加,但在 10 步欧拉步数时,RTF 与大多数基线系统相比仍然具有竞争力。
表 3 Euler 采样步数对流匹配模块的影响
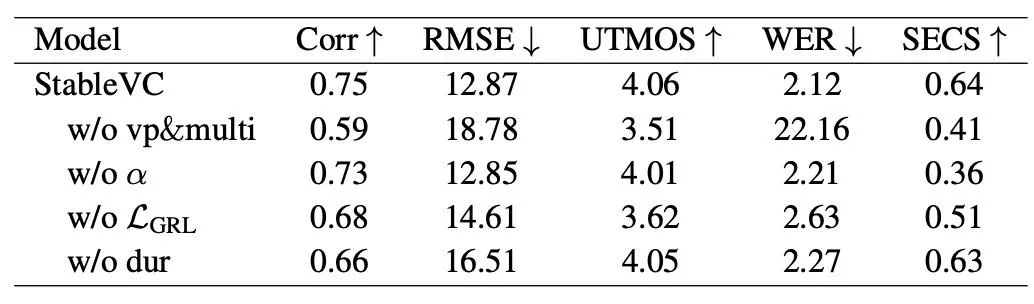
最后,我们对音色和风格建模中每个组件进行消融研究。表4中列出了每个消融模型在音调相关指标、语音质量、说话人相似度和词错误率上的得分。实验结果证明了:1)移除多参考语音和音色先验后,所有指标都出现了显著的性能下降,尤其是在 WER 结果中。这表明多参考语音和音色先验在捕获音色信息中起着至关重要的作用;2)移除自适应门后,SECS 出现了明显的下降。这表明自适应门在控制风格注入而不损害音色相似性方面起着关键作用。3移除 GRL 损失后,风格和音色指标均有所下降。这表明 GRL 损失有助于解开音色和风格信息,从而提高生成样本的最终音色和风格相似度;4)移除去重操作和持续时间建模后,与风格相关的指标有所下降。通过将这些消融模型的性能与完整的 StableVC 模型进行比较,可以评估每个组件对系统整体控制音色和风格信息能力的贡献。
表 4 消融实验 - 音色和风格建模中各个组件的有效性
更多demo样例:https://yaoxunji.github.io/stablevc/
