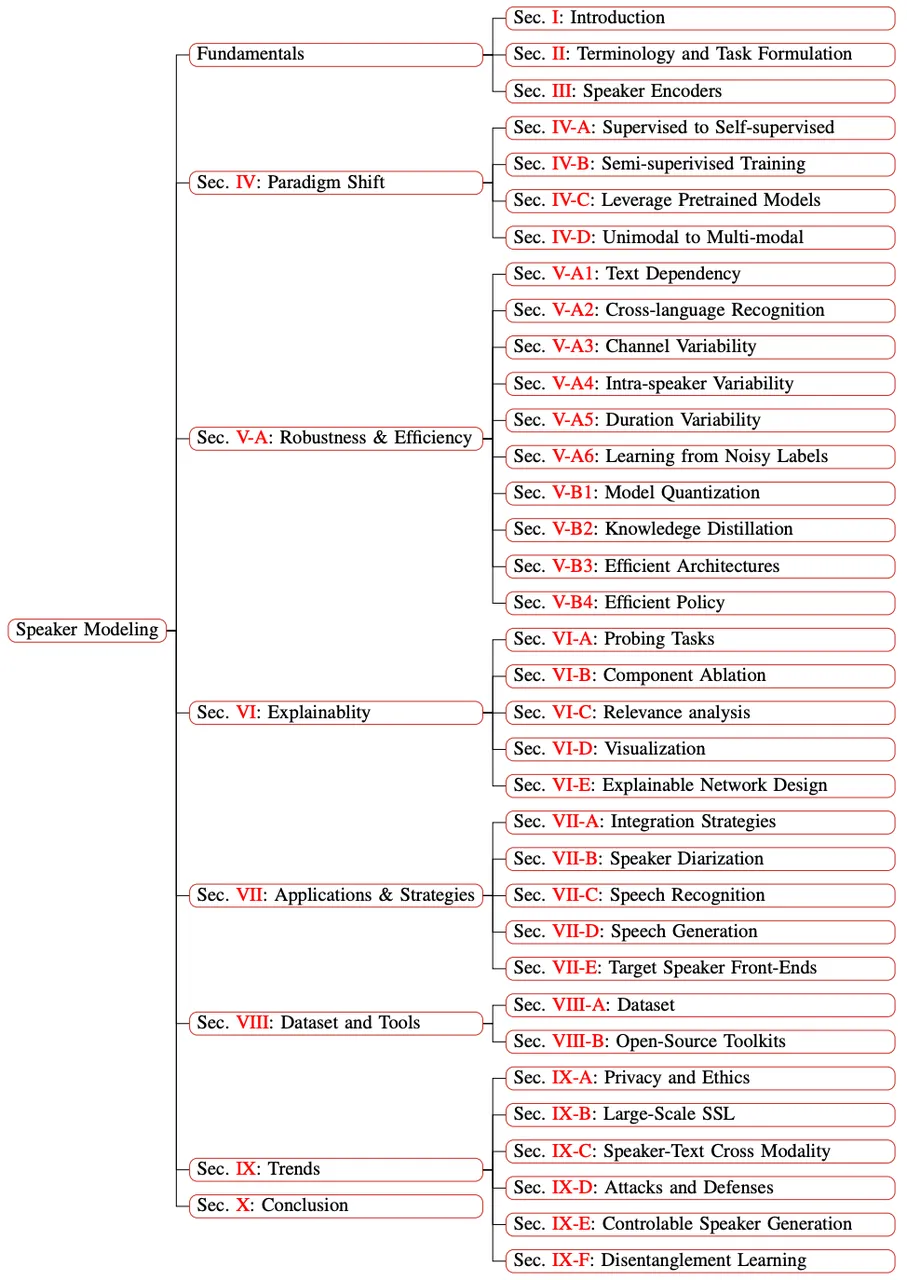
该综述由来自深圳市大数据研究院,上海交通大学,香港理工大学,香港中文大学(深圳)的相关学者共同完成。在这篇综述中,我们从理论和实践两个角度对基于神经网络的说话人表示学习方法进行了系统而全面的回顾。在理论层面,我们探讨了该领域的关键发展,包括从有监督学习到自监督学习算法的演进、从独立模型到大规模预训练模型的转变、从纯粹的说话人表征学习到与下游任务联合优化的融合,以及在可解释性研究方面的最新进展。在实践层面,我们深入研究了提升说话人表示学习鲁棒性与有效性的方法,并对该领域的各种开源工具包进行了介绍与比较。通过对相关文献、研究活动和资源的全面梳理与总结,本综述为从事说话人特征建模研究的学者提供了清晰的参考,同时也为希望将说话人建模技术应用于具体下游任务的研究人员提供有价值的指导。
Overview of Speaker Modeling and Its Applications: From the Lens of Deep Speaker Representation Learning
作者列表:王帅,陈正阳,Lee Kong Aik, 钱彦旻,李海洲
作者单位:深圳市大数据研究院,上海交通大学,香港理工大学,香港中文大学(深圳)
说话人建模旨在通过分析语音信号中的声学模式或特征,表征并识别个体身份的独特性。这项技术涵盖了与说话人身份及声音特征相关的重要信息,并为多项语音处理任务提供了核心支撑。其中最为广为人知的是说话人识别,通过声音直接确认个人身份的能力,使其在生物特征认证、监控系统、个性化服务以及法医学等领域得到了广泛应用。除了与说话人信息直接相关的任务(如说话人识别和说话人日志)之外,说话人建模的应用还进一步拓展至语音生成领域,包括声音克隆、语音合成和声音转换等。通过学习并模仿说话人的声学特征,该技术能够支持高质量的个性化语音生成,为虚拟助手、游戏角色等场景提供自然且个性化的语音交互体验。此外,通过将某个说话人的声音特征转换为另一个说话人(通常是虚拟的伪说话人)的声音特征,这项技术还能够实现说话人匿名化,保障个人隐私和数据安全。近年来,基于说话人信息的语音前端处理算法也引起了广泛关注。这类算法包括目标说话人声音活动检测、目标说话人增强以及目标说话人提取等技术。通过引入额外的说话人信息,这些算法可更精准地聚焦于特定目标说话人,从而有效提升语音信号的质量与清晰度。总体而言,精确的说话人建模及对说话人信息的深度理解,不仅显著推动了语音处理技术的发展,也在多个应用场景中提升了用户交互体验,展现了该技术的巨大潜力和价值。
在这篇文章中,我们将深度说话人表征学习进行规范化定义如下: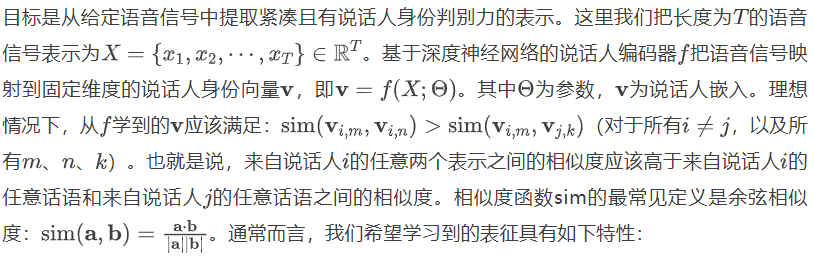
- 区分性:不同说话人的表示向量应该尽可能不同,也就是大的类间方差。
- 一致性(鲁棒性):对于同一说话人的不同话语,即使在不同的语音内容、环境噪声和信道条件下,它们的表示向量应该保持一致,也就是小的类内方差。
- 紧凑性:表示向量的维度应该尽可能小,以便于存储和计算效率,同时包含足够的信息以进行有效的识别。
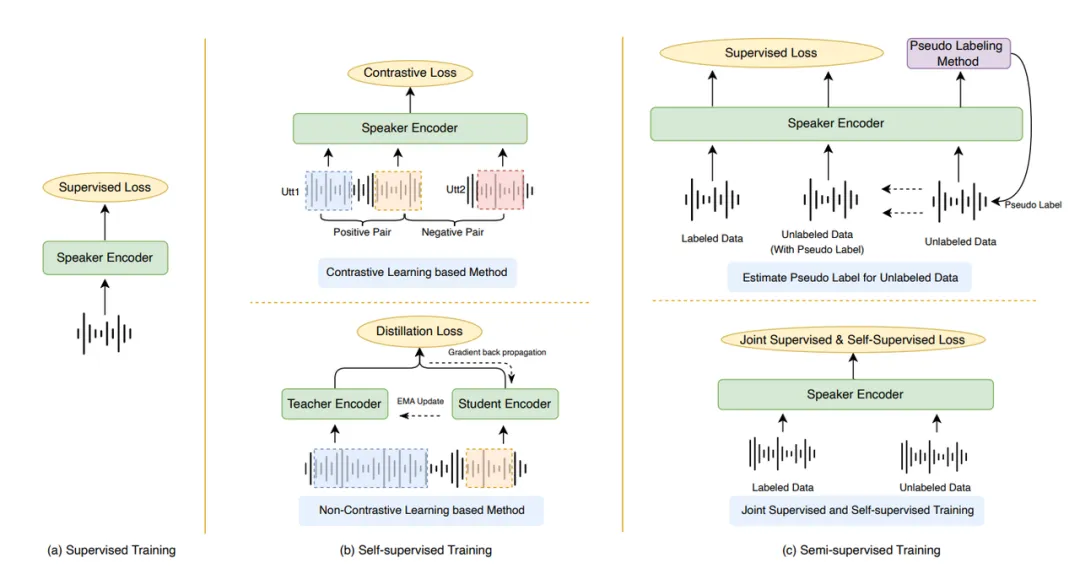
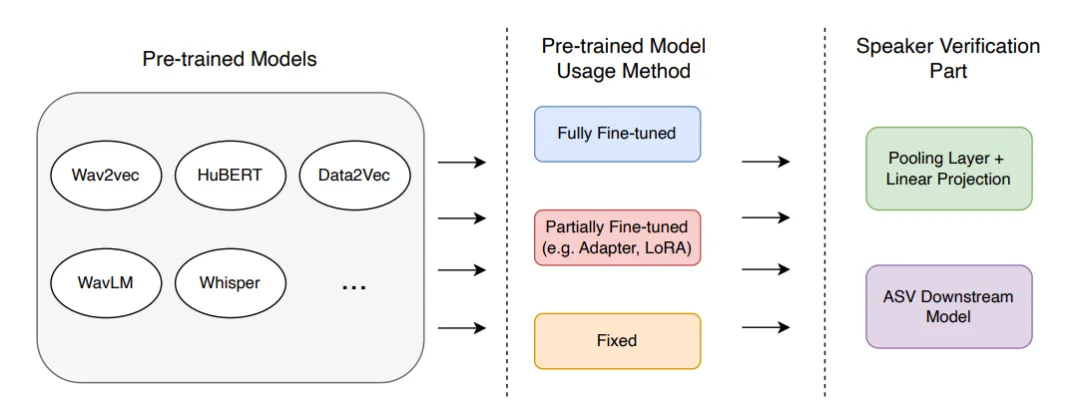
在深度说话人表示学习框架方面,研究主要集中于网络架构设计与性能优化两个方向。在网络架构设计上,从早期的TDNN到ResNet,再到近期的Transformer架构,模型设计不断推陈出新。在本综述中,我们对一维卷积和二维卷积的特点进行了比较,并探讨了帧级优化和段级优化两种训练范式的优劣。与此同时,通过引入残差连接以构建更深的网络、多尺度特征建模以及注意力机制等技术手段,系统性能得到了持续提升。随着无标注数据规模的快速增长,自监督学习方法受到了广泛关注。其中,基于对比学习的方法通过构建正负样本对实现特征表示的学习,而诸如DINO等非对比学习策略则通过避免假负样本问题进一步优化了学习效果。整体上,能够利用大规模无标签数据的自监督、半监督范式得到了更多研究者的关注。此外, 随着大规模预训练模型如wav2vec、HuBERT、WavLM 的出现, 如何有效利用这些模型的强大特征提取能力来增强说话人相关任务的性能,也成为新的研究热点。如下图所示,需要设计的策略主要分为两部分,一个是如何对预训练模型进行Finetune调整,另外一个是如何设计预训练模型到speaker任务的桥接部分。对于预训练模型的Finetune策略,主要分为三种:对于预训练模型到speaker任务的桥接部分,主要有两种策略:- 使用Pooling layer将预训练模型的序列输出转成定长输出,并使用Linear Projection映射到说话人表征
- 使用预训练模型的输出特征替换说话人模型原本的音频表征输入
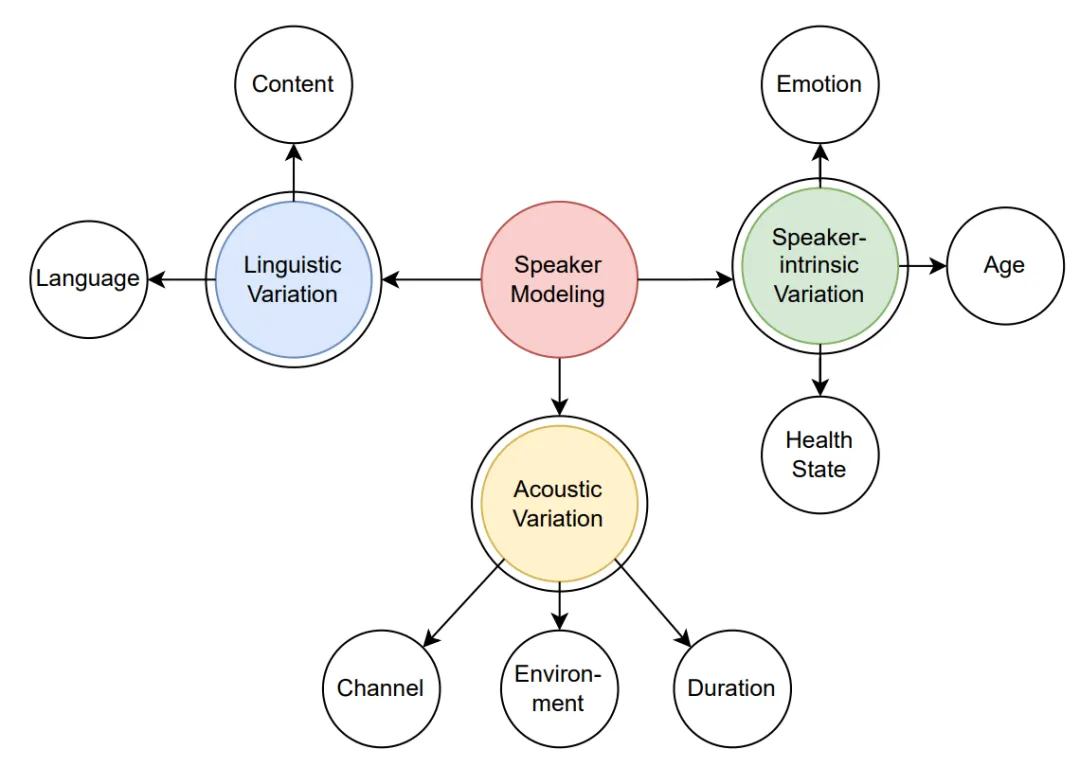
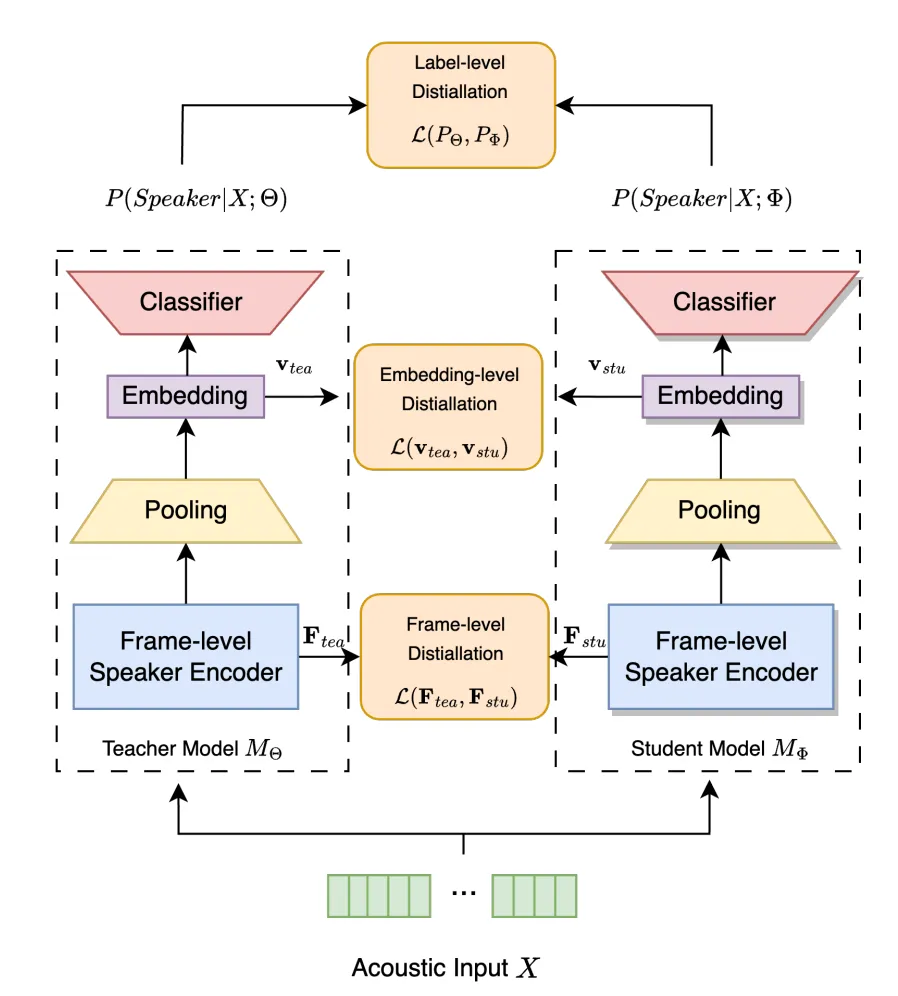
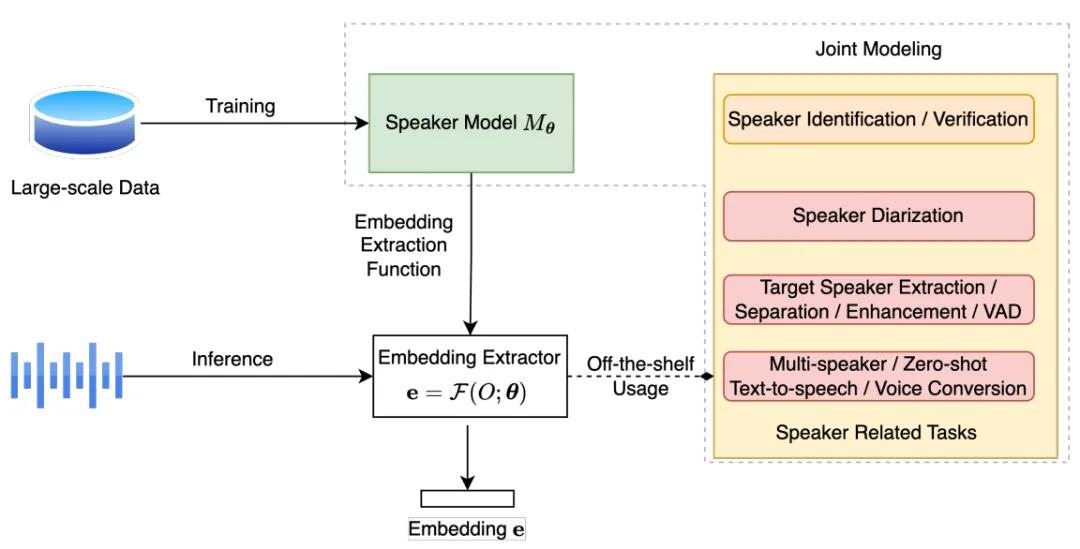
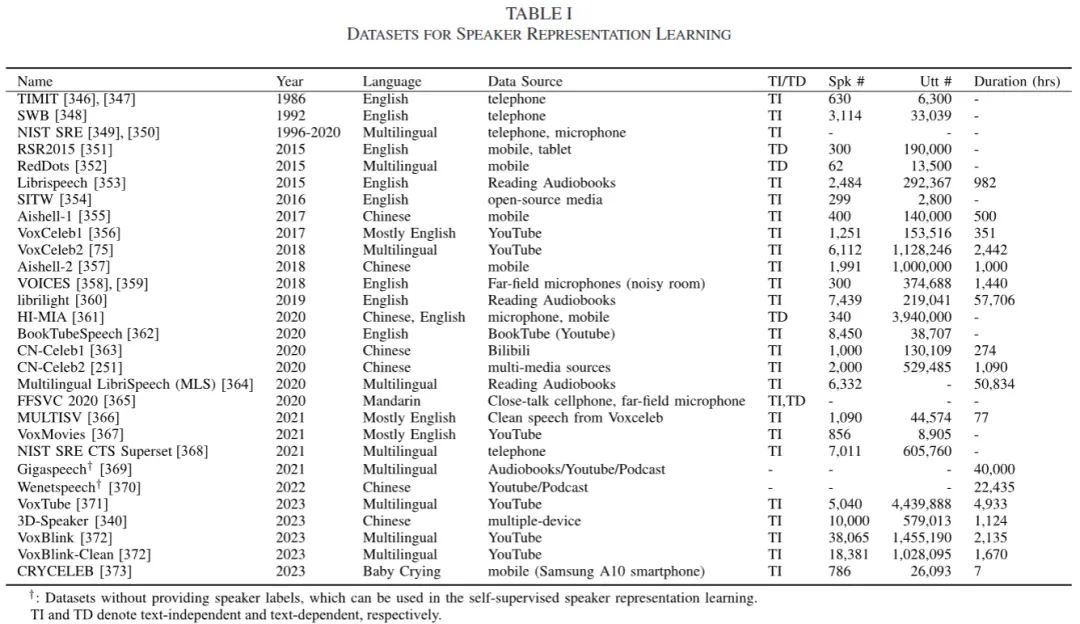
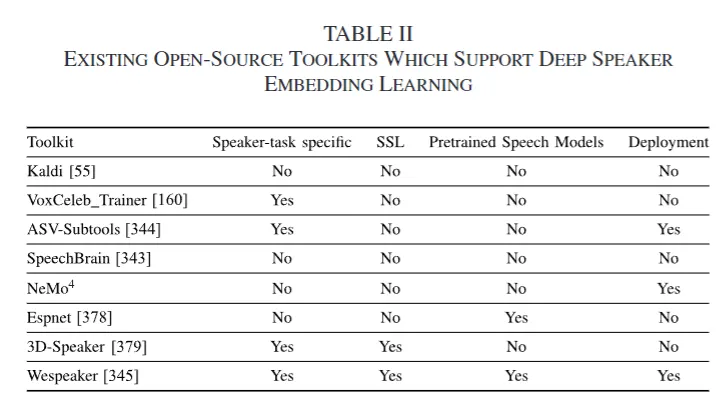
鲁棒性研究主要针对文本依赖、跨语言、信道变化、说话人内部变化等因素的影响,探索相应的解决方案。下图则展现了主要的影响说话人表征学习鲁棒性的因素,既有外部客观环境因素,也有说话人自身状态因素。我们在文中对不同因素带来的挑战进行了分解,并给出了相应相应技术的总结。在效率方面,常见的做法则主要包括模型量化、知识蒸馏、轻量级网络设计等多个研究方向,下图展现了常见的知识蒸馏方法示意:随着说话人建模技术的发展,其可解释性逐渐成为研究焦点。在该领域,多种方法被用于探索说话人表示学习的内在机制,以增强模型的透明度和可理解性。基于探测任务的方法通过设计各类任务,如分析说话人、文本和环境等信息的建模能力,来量化比较不同说话人嵌入的特性和能力,SUPERB 基准也采用类似思路,通过简单探测头评估预训练模型在不同下游任务中的表现。组件消融则通过系统移除模型组件,如网络层、损失函数或训练策略等,确定其对最终性能的贡献,从而构建更优的说话人表示学习器。相关性分析借助CKA等方法,解释中间层表示,揭示不同属性在信息跨层流动时的变化趋势。可视化方法利用 Class Activation Map 等技术,直观呈现模型在数据增强后的鲁棒性,或通过归因算法可视化特征重要性。可解释网络如 Concept Bottleneck Model,引入中间层捕获与人类可理解概念或属性相关的表示,使模型决策与具体概念相连,提供决策过程的透明解释路径,提升了说话人建模的可解释性,有助于深入理解模型行为和性能。正如前文所述,说话人表征经常被用于其他任务作为音色输入,集成策略通常分为即插即用(Off-the-shelf Usage):使用在说话人识别任务上预训练的说话人嵌入模型,将其作为额外的预处理组件来提取说话人嵌入。这些嵌入可以作为模型的输入特征,为模型提供有关说话人身份的信息,从而丰富模型的输入;也可以作为目标输出的一部分,通过设计特定的损失函数来约束和引导模型的输出,确保语音保留正确的说话人特征。另一种方法则是将说话人模型与目标任务模块联合训练,并非简单使用预训练的说话人表示,而是在学习目标任务的同时学习说话人特征。这种端到端的训练方式允许说话人识别与目标任务之间相互增强和联合优化。无论是预训练还是联合优化框架,当说话人信息作为输入或额外条件时,关键挑战是如何有效地将其集成到目标任务的主网络中。常见的方法包括非参数化方法(如拼接和特征相加)以及参数化的条件方案(如特征 - 线性调制(FiLM)、条件层归一化(CLN)和自适应实例归一化(AdaIN)等)。从统一的角度看,AdaIN、CLN 和 FiLM 都可以被视为使用条件信息生成缩放和平移参数,从而调制特征归一化或线性变换的方法,使神经网络能够动态适应不同的条件说话人信息。如何针对具体任务定制说话人信息建模方法会是一个研究重点,因为在众多的任务中研究者已经发现预训练说话人表征在SV 任务上的表现并不能完全反应其在具体下游任务上的性能,往往看似更强的说话人表征反而取得的结果会差强人意。近年来,在说话人建模领域,新的数据集和开源工具包不断涌现,为研究和应用提供了丰富的资源。VoxCeleb、CNCeleb 和 3D - Speaker 等数据集的发布,推动了该领域研究的发展。例如,VoxCeleb 已成为过去五年说话人识别研究的主流数据集,但随着研究深入,对更具挑战性场景(如远场、多体裁)数据的需求也逐渐显现。同时,众多开源工具包如 ESPNet、Speechbrain、NeMo 等也应运而生,其中专门用于说话人识别的工具包如 ASV - Subtools、VoxCeleb_Trainer、3D - speaker 和 WeSpeaker 等,为研究者提供了便利。这些工具包多采用 PyTorch 实现,易于修改扩展,部分还支持自监督学习和预训练模型集成,如 3D - speaker 和 WeSpeaker,且 WeSpeaker 和 NeMo 还具备快速部署功能,有助于模型在工业场景中的应用,促进了说话人建模技术从研究到实际应用的转化。最后,我们也对未来的一些研究趋势进行了展望与探讨,包括但不限于:- 隐私保护和伦理问题:说话人建模涉及个人隐私,需在收集和使用数据时保护个人身份信息,可采用说话人匿名化等技术,但要平衡隐私和数据可用性。
- 大规模自监督表示学习:大规模预训练可提升模型性能,但说话人表示学习面临数据隐私和现有预训练模型不针对性等问题,需进一步研究利用大规模无标记数据。
- 文本与说话人表示的跨模态学习:大型语言模型在跨模态任务中表现出优势,探索其与说话人表示的相互理解具有重要意义,但现有研究在将文本描述转换为说话人表示方面性能有待提高。
- 攻击与防御:说话人表示在身份验证系统中面临安全威胁,包括语音合成技术带来的伪造风险和神经网络系统的输入扰动攻击,需开发更强大的反欺骗和抗攻击算法。
- 可控说话人生成:当前研究主要关注现有说话人的语音数据,未来可探索建模非现有说话人身份,通过调整说话人特征生成具有特定属性的语音,保护用户隐私并提供更多语音选择。
- 解耦合学习:解耦说话人、内容、环境等信息在语音转换和合成等领域具有重要意义,是众多下游任务的共同需求。
在这篇综述文章中,我们尽可能从不同于前人综述的角度,系统地回顾了基于深度学习的说话人表示技术、算法的演变及其应用。我们希望本文能提供一个全面而系统的总结,为说话人建模领域的研究人员提供详细的参考和灵感。此外,我们旨在激发相关领域研究人员的兴趣,促进说话人建模技术的发展和更广泛的应用。同时,我们必须承认,由于篇幅限制和本文的视角,某些方面可能仅作简要提及。 
 语音小管家