
 语音小管家
论文标题:Perceiver-Prompt: Flexible Speaker Adaptation in Whisper for Chinese Disordered Speech Recognition
论文作者:江怡聪,王天资,谢旭荣,刘娟,孙伟,燕楠,陈辉,王岚,刘循,田丰
论文单位:中国科学院软件研究所,香港中文大学,中国科学院深圳先进技术研究院
作者邮箱:jiangyicong231@mails.ucas.ac.cn; twang@se.cuhk.edu.hk; xurong@iscas.ac.cn
论文链接:https://arxiv.org/abs/2406.09873
论文亮点:
本文提出了一种基于P-tuning的说话人自适应方法——Perceiver-Prompt,用于Whisper模型的构建,以完成构音障碍语音识别任务。通过采用不同的配置和训练方法,这种方法能够生成具有说话人自适应能力的Prompt,从而应对不同程度的构音障碍以及不同的语音任务。在我们构建的中文构音障碍语音数据集上,利用Perceiver-Prompt微调后的Whisper,相较于Conformer、TDNN以及使用/不使用i-vector进行微调的Whisper,在所有配置下最高降低了13.04%的相对字符错误率。并且据我们所知,这是首次将P-tuning应用于大规模语音模型Whisper的说话人自适应方法。
言语障碍语音识别对于改善患有例如构音障碍等疾病个体的生活质量具有深远的影响。构音障碍语音识别面临着诸多挑战,包括数据有限、构音障碍和非构音障碍说话者之间存在实质差异、以及由于疾病导致的说话者之间的差异显著。本文提出了Perceiver-Prompt,这是一种利用P-Tuning在大规模语音模型Whisper上进行说话人自适应的方法。我们首先使用LoRA对Whisper进行微调,然后集成一个基于可训练Perceiver的Prompt编码器,从可变长度的输入中生成固定长度的说话人Prompt,以提高模型对中文构音障碍语音的识别能力。在我们自行构建的中文构音障碍语音数据集上的实验结果显示,Perceiver-Prompt能够持续改善识别性能,相较于微调后的Whisper,字符错误率(CER)能够相对减少高达13.04%。
尽管语音识别技术已经取得了显著进展,但对障碍语音识别技术的研究仍然至关重要,因为这对于改善患有构音障碍等疾病个体的生活质量具有深远意义。构音障碍是一种由神经损伤引起的神经-运动障碍,影响了言语产生过程中需要的肌肉。患者通常表现为发音不清、语速变化不定以及言语节奏紊乱。此外,由于构音障碍患者自身的残疾或行动不便,很难进行大规模的数据采集。这些因素共同导致了:(1)训练数据不足;(2)构音障碍患者与非患者之间存在显著差异;(3)由于疾病的影响,不同说话者之间也存在较大变异。
为应对这些挑战,许多研究选择使用构音障碍患者的数据来训练专门的自动语音识别模型。时频深度特征、LHUC、i-vector等方法都通过适应构音障碍患者的语音特性来实现构音障碍语音识别的性能提升。
Whisper[1]、HuBERT[2]、Wav2Vec 2.0[3]等模型利用大规模数据进行预训练,从正常语音数据中学习通用语音表征,一定程度上弥补了构音障碍语音数据的不足。微调这些预训练模型已成为一种趋势。然而,在大规模预训练模型(如Whisper)上的说话人自适应仍是一个相对未被深入研究的领域。
为了填补这部分的空白,我们提出了Perceiver-Prompt。据我们所知,这是第一个在大规模语音模型 Whisper上应用P-Tuning进行说话人自适应的工作。其灵活性在我们自行构建的构音障碍语音数据集上得到了验证,在各种配置和训练任务下均展现了优秀的性能。
一、基线方法
尽管Whisper在多场景中表现出色,其在处理构音障碍语音数据时仍性能不足。因此我们使用LoRA在自行构建的中文构音障碍数据集上对Whisper进行微调,以提升Whisper在构音障碍语音识别任务中的适应性。
我们利用P-tuning来实现说话人自适应,将说话人信息与构音障碍特征编码为Prompt输入模型,帮助模型更好地适应任务。
要在构音障碍语音识别任务中实现基于P-Tuning的说话人自适应,需要为Whisper增加Prompt编码器,以处理复杂的时间序列语音数据,向量化说话人特征生成Prompt。Perceiver是这一任务的理想选择,其优势在于无需特定领域假设即可生成Prompt,并能处理任意形式的输入。Perceiver生成的固定长度嵌入向量可在输入数据的两端进行拼接,并且能够通过改变自身的相关参数实现不同场景下的障碍语音识别。此外,Perceiver还能在线生成说话人Prompt,实现推理阶段的高效自适应。Perceiver如图1左侧绿色部分所示。
具体来说,以拼接在输入的末端为例,处理过程如下所示:
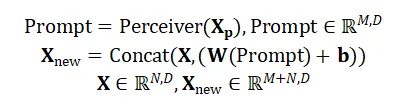
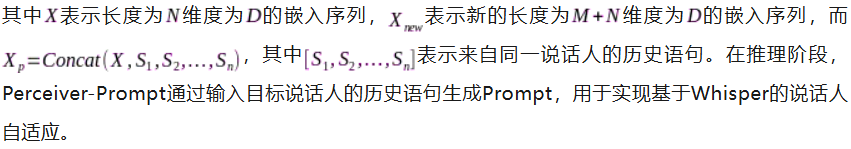
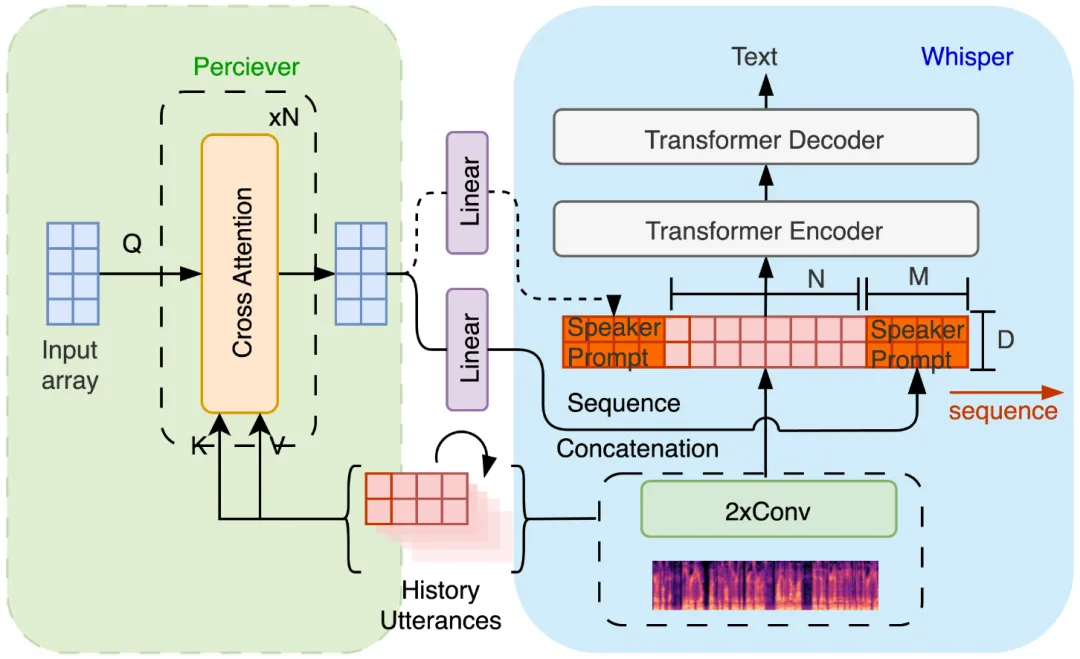
图1 Perceiver-Prompt的框架图与灵活的Prompt拼接方式,包括可选择性添加的来自相同说话人的语音数据
Whisper:我们选择Whisper-medium作为实验基础,其在性能与计算资源之间达成了良好平衡。ESPnet [5]提供的配方为使用LoRA微调Whisper-medium提供了相应的设置,编码器和解码器均由24个残差注意力块堆叠而成,每个块包含多头注意力和前馈网络。LoRA的微调目标为注意力模块中的“query”、“key”、“value”和“att.out”等组件,LoRA的秩设置为8。在Whisper中,所有音频都重采样为16,000 Hz,并使用80通道对数幅度梅尔频谱表示,计算时采用25毫秒的窗口和10毫秒的步长。
表1 Conformer、TDNN、经过微调的Whisper-medium、使用i-vector (Whisper-iVector) 进行说话人自适应的Whisper-medium以及应用了我们提出的Perceiver-Prompt的Whisper (Whisper-PP) 的性能。
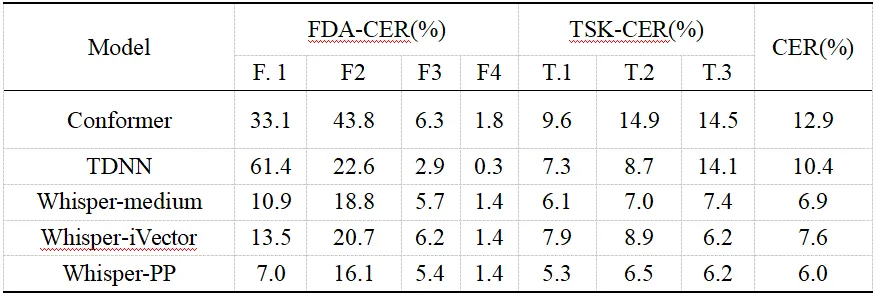
表2 Perceiver-Prompt在各种配置和训练方法下的表现。在所有配置下模型都相比之前取得了更好的效果,并且在特定场景下进行有针对性的调整可以带来性能的提高。“self”表示当前的话语。“Sto.”指的是随机性地选择来自同一说话人的数据。
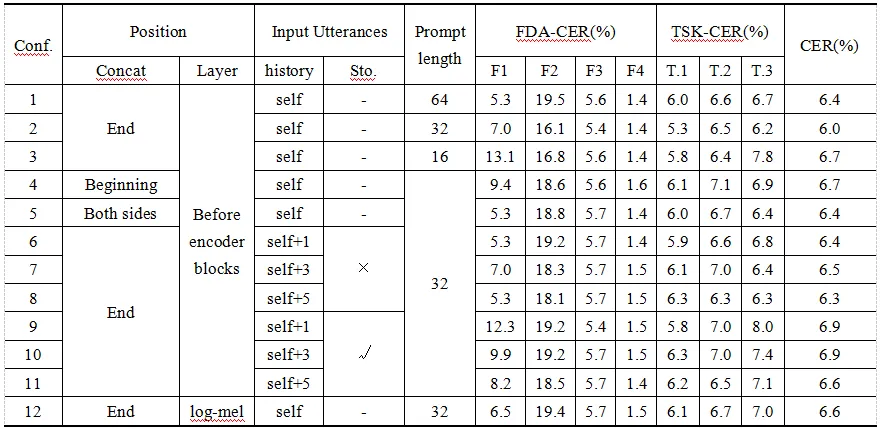
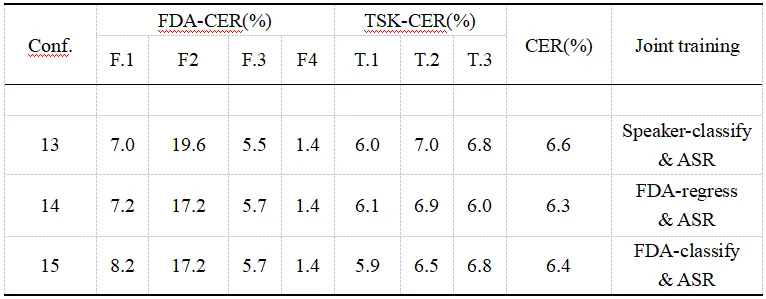
表3不同联合训练方法下的模型表现
通过t-SNE分析处理后的说话人Prompt如图2所示,表明Perceiver-Prompt生成的说话人Prompt在一定程度上能够区分不同说话人和各种FDA严重程度。更多历史信息的引入增强了说话人区分能力,但这并不一定保证在构音障碍语音识别任务中的性能提升。
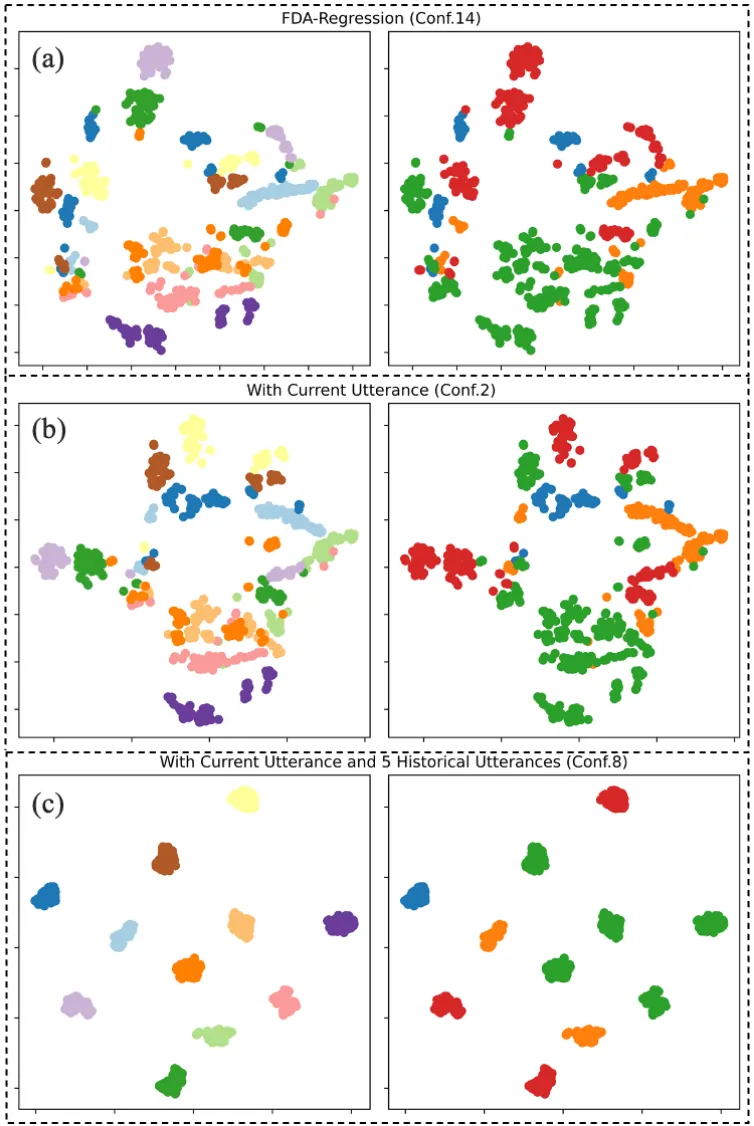
图2 三个子图(a)、(b)和(c) 分别代表Conf.14、Conf.2和Conf.8 的t-SNE分析结果。左栏代表说话人的t-SNE分析,不同颜色表示不同的说话人。右栏代表FDA 严重级别的t-SNE分析,不同颜色表示不同的FDA 严重程度。
参考文献
[1] A. Radford, J. W. Kim, T. Xu, G. Brockman, C. Mcleavey, and I. Sutskever, “Robust speech recognition via large-scale weak supervision,” in Proceedings of the 40th International Conference on Machine Learning, ser. Proceedings of Machine Learning Research, A. Krause, E. Brunskill, K. Cho, B. Engelhardt, S. Sabato, and J. Scarlett, Eds., vol. 202. PMLR, 23–29 Jul 2023, pp. 28 492–28 518.
[2] W.-N. Hsu, B. Bolte, Y.-H. H. Tsai, K. Lakhotia, R. Salakhutdinov, and A. Mohamed, “Hubert: Self-supervised speech representation learning by masked prediction of hidden units,” 2021.
[3] A. Baevski, H. Zhou, A. Mohamed, and M. Auli, “wav2vec 2.0: A framework for self-supervised learning of speech representations,” 2020.
[4] J. Liu, X. Du, S. Lu, Y.-M. Zhang, H. An-ming, M. L. Ng, R. Su, L. Wang, and N. Yan, “Audio-video database from subacute stroke patients for dysarthric speech intelligence assessment and preliminary analysis,” Biomedical Signal Processing and Control, vol. 79, p. 104161, 2023.
[5] S. Watanabe, T. Hori, S. Karita, T. Hayashi, J. Nishitoba, Y. Unno, N. Enrique Yalta Soplin, J. Heymann, M. Wiesner, N. Chen, A. Renduchintala, and T. Ochiai, “ESPnet: End-to-end speech processing toolkit,” in Proceedings of Interspeech, 2018, pp. 2207–2211.
整理编辑:张雯,李雅,吴锡欣
