Neural audio codecs (NACs) 已成为音频压缩和语音语言模型(SLM)表示的关键技术,近年来得到了极大的发展。
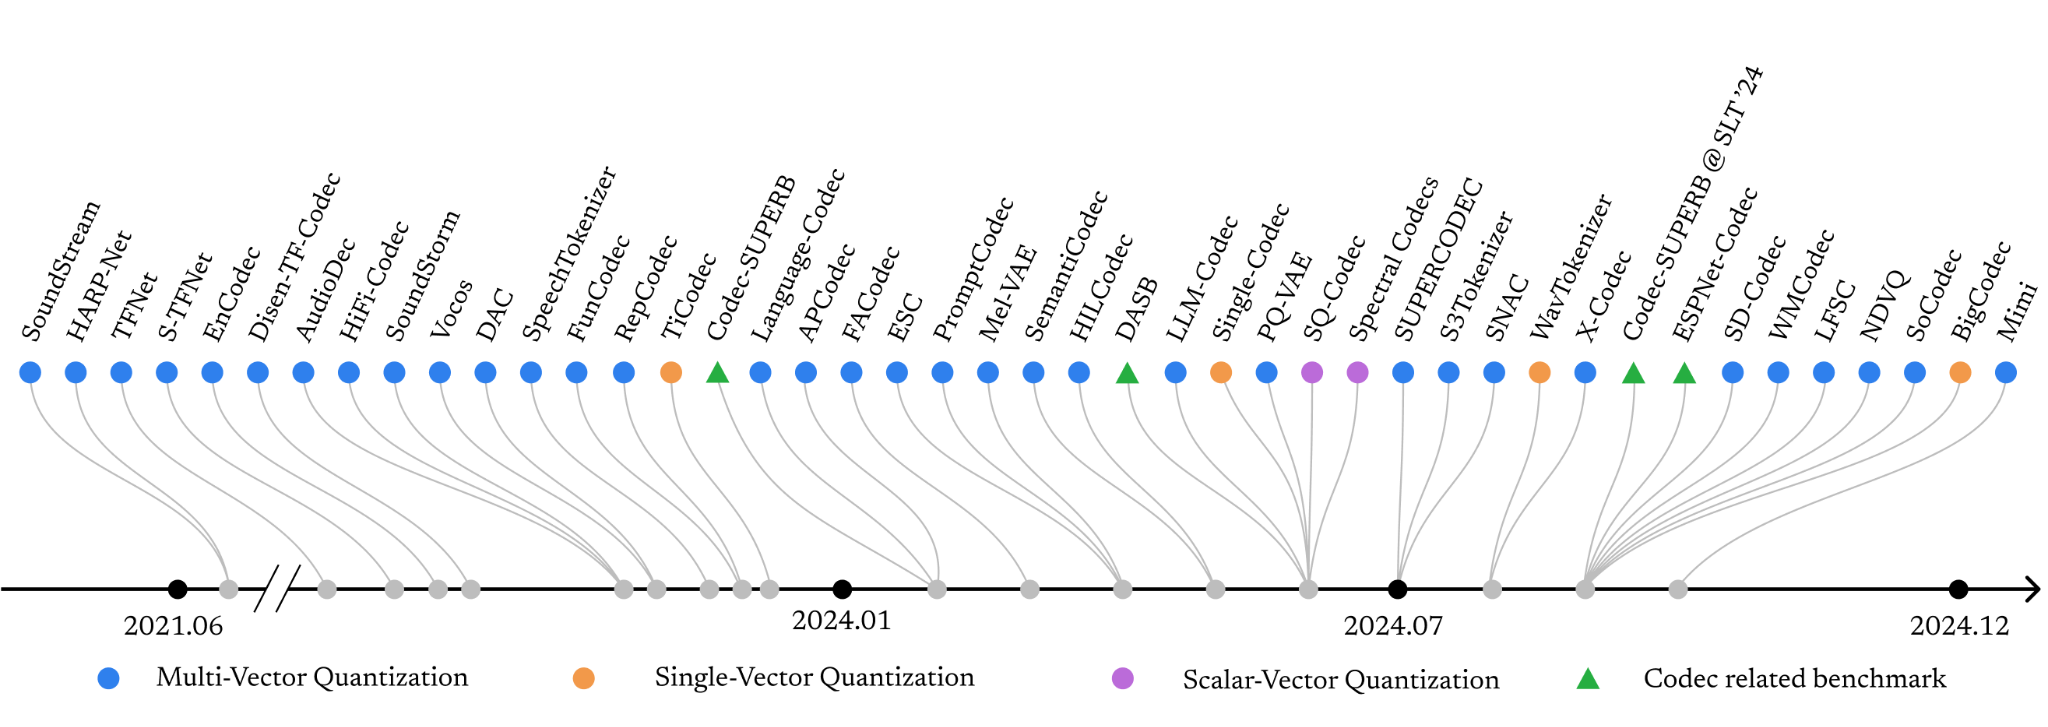
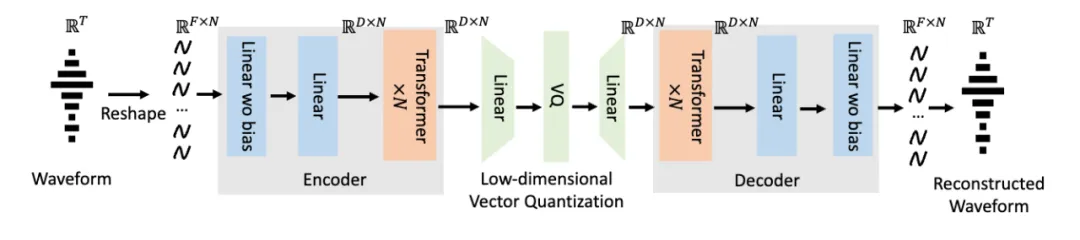
微软提出TS3-Codec,为codec模型设计提供了崭新的思路。它是首个完全基于 Transformer 的 NAC 模型,彻底摒弃了卷积结构,不仅设计更为简洁,还显著降低了计算需求。并且TES-Codec支持流式、只用单一码本、比特率可低至0.6k、音质极高。
论文:TS3-Codec: Transformer-Based Simple Streaming Single Codec
论文链接:https://arxiv.org/abs/2411.18803
1️⃣流式处理,支持实时交互TS3-Codec 天生支持流式编码,满足了全双工语音语言模型的需求——用户和机器可以同时说话、实时响应。这为构建低延迟的语音语言模型打下了坚实基础。2️⃣单一码本设计,简化架构告别复杂的多码本(如 RVQ),TS3-Codec 采用单一码本设计,显著简化了 SLM 的模型架构。这一特性避免了多组编码的组合难题,使训练和推理更高效稳定。3️⃣极低计算成本,资源分配更灵活相比主流的卷积模型,TS3-Codec 的计算需求仅为其12%,而音频质量却更胜一筹。这意味着在同样的硬件资源下,TS3-Codec 可以释放更多计算力,用于支持更复杂的 SLM 任务。4️⃣低 Token 率,高效序列处理长序列是训练大语言模型的主要瓶颈。TS3-Codec 生成的 Token 率低,序列更短,从而加速 SLM 的训练,同时避免不稳定问题。
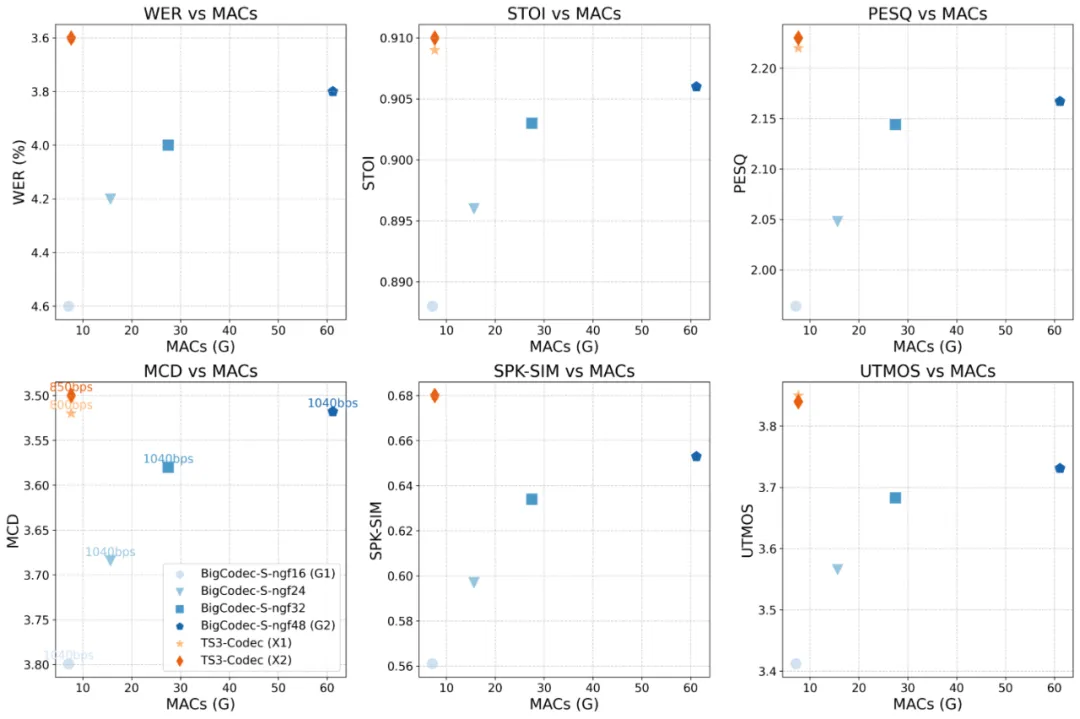
在流式场景下,TS3-Codec 在12% 的计算资源和77% 的比特率下,达到了与最先进的卷积模型相当或更优的性能。使用相同的计算资源,TS3-Codec 显著提升了音频质量,展现出 Transformer-only 模型的巨大潜力。
TS3-Codec 通过更简单、更高效的设计,它满足了语音语言模型对于流式处理、低复杂度和高质量的多重需求,为实时语音交互、音频生成等领域注入了新的活力。想了解更多技术细节?欢迎阅读论文!(点击“阅读原文”直接访问)

 语音小管家
